はじめに
RWKVに関して二つのブログを書いてきました(その1,その2)が,追加で学習(勾配)の安定性についても日本語で書いておこうと思います.というのも,RWKV-4の学習では以下の画像のように,LLMでありがちなLoss Spikeが確認されなかったという実験結果があります.
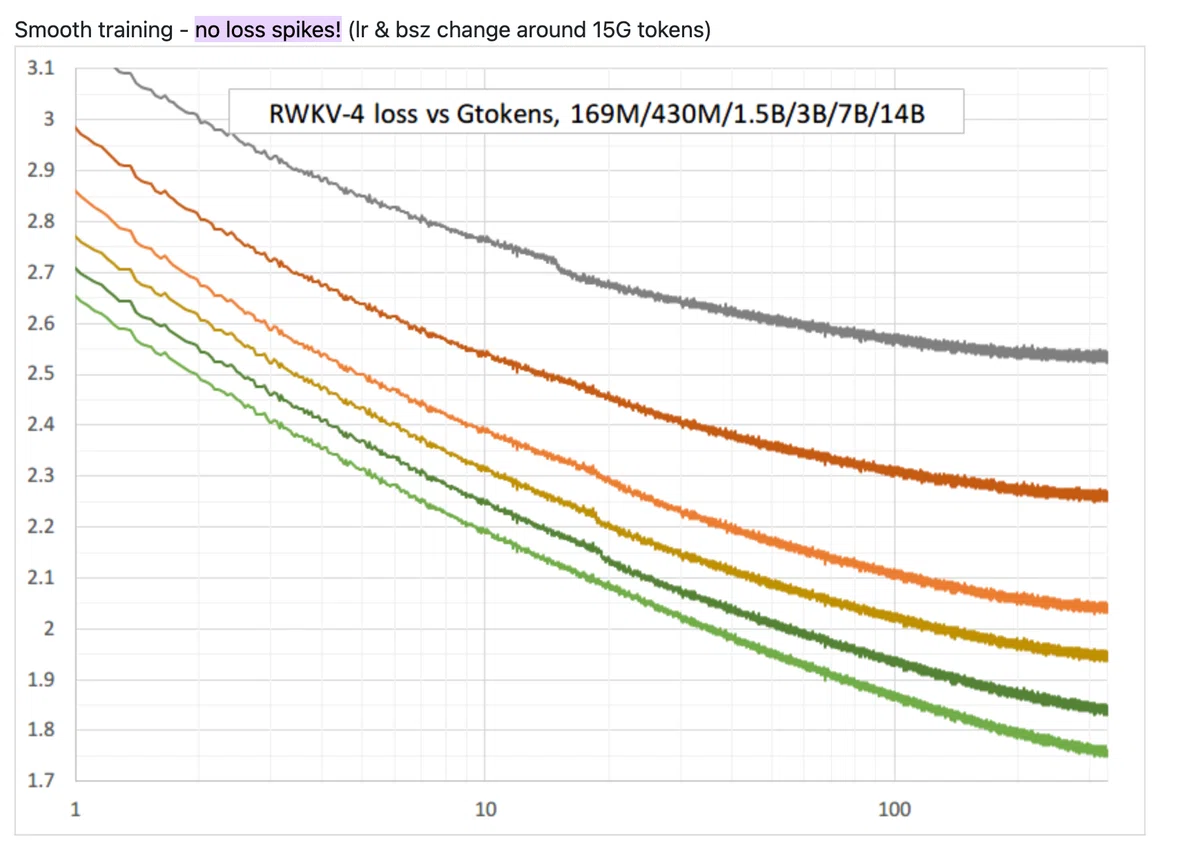 screenshot from: "no loss spikes!" - BlinkDL/RWKV-LM GitHub 2024/02/21
これがなぜそうなのか,という根拠を若干不十分な説明でありますが,Appendix Hに書いてあったので,文脈を補いながら解説します.
前準備:勾配と学習の安定性
RWKVにおいて,TransformerのAttentionに相当する機構であるwkvは以下の数式でした.
wkvt=i=1∑t−1e−(t−1−i)w+ki+eu+kti=1∑t−1e−(t−1−i)w+kivi+eu+ktvt (1)
ここで,この式を簡略化するために,valueはvt=Wvxt,指数関数部分はKte=eWkxt+wT,tと置き換えます.また,トークンは最終トークンTを見ることとします.すると,wkvは次のようになります.Eは平均,Sは重み付きの総和を表す関数です.wkvはvtの平均とも見れ,その分母と分子を,重みKteの総和と,重みつきvtの総和とも見ることができます.
wkvT=∑t=1TeWkxt+wT,t∑t=1TeWkxt+wT,t vt=∑t=1TKte∑t=1TKtevt=E(vt)=S(1)S(vt) (2)
wkv層を出ると,以降の層f(wkvt)に入り,それが正解ラベルytとの誤差が評価されます.今回,最終トークンTの損失を見るとすると,以下の式が得られます.
LT=l(f(wkvT),yT) (3)
機械学習における学習は,勾配の逆向きの更新により行われます(勾配降下法).従って,RWKVにおいて損失を減らす向きに,ある隠れ層aのパラメータ(Wa)i,jを更新をすると,以下のようになります.
(Wa)i,j←(Wa)i,j−γ∂(Wa)i,j∂LT (4)
発散しない勾配
式(4)を元に,Wvの更新がどのような上限が加わるかを見ます.
wkv層に対して合成関数の偏微分の連鎖律を考えると,以下のように損失は損失→wkv層→valueと,経由できます.
∂(Wv)i,j∂LT=∂(wkvT)i∂LT⋅∂(Wv)i,j∂(wkvT)i (5)
連鎖律はRWKVのアーキテクチャ図を見ると理解しやすいと思います.
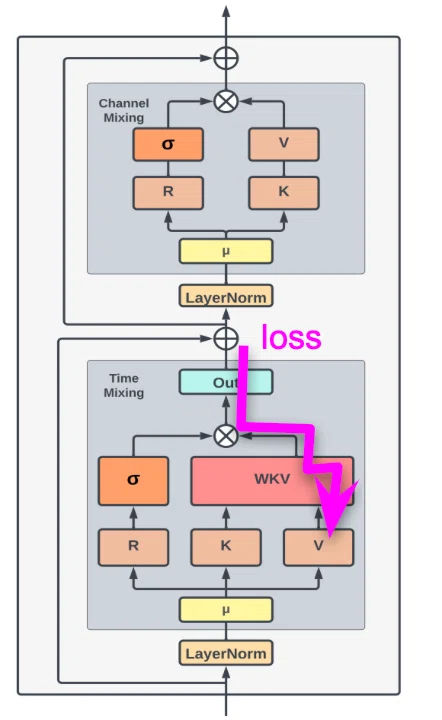 RWKV: Reinventing RNNs for the Transformer Era Fig2より.ピンク色は著者が追加
勾配の発散は正負関係無しに発生するため,式(5)のwkv層から伝わる勾配に絶対値をとります.
∂(Wv)i,j∂LT=∂(wkvT)i∂LT⋅∂(Wv)i,j∂(wkvT)i→∂(wkvT)i∂LT⋅∂(Wv)i,j∂(wkvT)i (6)
この絶対値をさらに見ていくと,式(2)を用いて
∂(Wv)i,j∂(wkvT)i=∂(Wv)i,j∂(∑t=1TKte∑t=1TKtevt)i (7)
式(7)のwkvTに式(2)を代入し,最初に書いたようにvt=Wvxtであることを踏まえると
∂(Wv)i,j∂(wkvT)i=∂(Wv)i,j∂Ei[(vt)i]=∂(Wv)i,j∂Ei[(Wvxt)i]=∂(Wv)i,jEi[(∂Wvxt)i]=∣E[(xt)j]∣ (8)
式(8)を見たらわかる通り,入力xtの平均の絶対値となっています.平均の絶対値は,その要素の最大値の絶対値を超えない ことから,以下の不等式が成り立ちます.
∂(Wv)i,j∂(wkvT)i=∣E[(xt)j]∣ =Tx1j+…+xtj+…+xTj≤tmax∣(xt)j∣ (9)
つまり,wkv層におけるWvを更新する勾配は,入力列の最大要素を超えない,という上限がつくわけです.
加えて,式(9)の上限にTが出てこないため,系列の長さによって勾配の上限は制限されない,系列長により勾配が消失がしずらいとわかります.
消失しない勾配
式(4)から,同様にWkの更新にどのような下限が加わるかを見ます.
∂(Wk)i,j∂LT=∂(wkvT)i∂LT⋅∂(Wk)i,j∂(wkvT)i (10)
式(10)のwkvに式(2)を代入すると
∂(Wk)i,j∂(wkvT)i=∂(Wk)i,j∂Si[(vt)i]⋅∂(Wk)i,jSi(1)=∂(Wk)i,j∂(Si(1)∑t=1T(Kt)i(vt)i) (11)
商の偏微分公式∂x∂(g(x)f(x))=g(x)2f′(x)⋅g(x)−f(x)⋅g′(x)から
=Si(1)2(∂(Wk)i,j∂∑t=1T(Kt)i(vt)i)⋅Si(1)−(∑t=1T(Kt)i(vt)i)⋅∂(Wk)i,j∂Si(1) (12)
部分ごとの偏微分を計算すると,最初に簡素化した式を参照して,
∂(Wv)i,j∂(vt)i=(xt)j
∂(Wk)i,j∂(Kte)i=(xt)j(Kte)i.
これらを式(12)に戻すと
=Si(1)2(∑t=1T(xt)j(Kt)i(vt)i)⋅(∑t=1T(Kt)i(vt)i)−(∑t=1T(xt)j(Kt)i)=Si(1)Si[(xt)j(vt)i]−Si(1)2Si[(xt)j]Si[(vt)i]=Ei[(xt)j(vt)i]−Ei[(xt)j]Ei[(vt)i]
これは共分散の式であるため,
=covi((xt)j,(vt)i) (13)
(2)式よりwkv層の計算において,xtとvtの共分散は0にはならないことから,
∂(Wk)i,j∂(wkvT)i=covi((xt)j,(vt)i)=0 (14)
よって,wkv層におけるWkを更新する勾配は0にならない,消失しないとなります.
まとめ
以上,RWKVを構成するwkvのパラメータは勾配と発散,両者の対策がなされていることが数式からわかります.故に最初に示した画像のように,loss spikeが発生しなかったことが説明できる,とされています.
誤り等あれば,コメント or @gojiteji まで連絡お願いします🙇.
参考文献
関連ブログ



