2013年に登場した変分オートエンコーダ(VAE)と、2014年の生成的敵対ネットワーク(GAN)は、画像生成AIの中核技術として注目されるようになりました。
VAEは学習の安定性に優れていましたが、当初は生成画像がぼやけやすいという課題を抱えていました。ただし、その後の研究と改良によって、徐々に生成品質も向上していきました。
たとえば、2020年に発表された論文「NVAE: A Deep Hierarchical Variational Autoencoder」は、NVIDIAの研究者であるArash VahdatとJan KautzによるVAEを用いた高品質な画像生成の研究です。
一方、GANは発表当初から高精度な画像生成で注目を集めました。ただし、GANには学習の不安定さやモード崩壊(特定パターンに偏った出力)といった課題がありました。それでも、DCGAN、CGAN、Pix2Pix、CycleGANなど多くの派生モデルが生まれ、応用の幅を広げていきました。
このように、改良が重ねられてきたVAEとGANは、それぞれの長所を活かしながら、画像生成AIの主流技術として長く用いられてきました。
そんな中、2020年に発表された論文「Denoising Diffusion Probabilistic Models」(ノイズ除去 拡散確率モデル、DDPM)が新たな潮流を生み出します。
この手法は、VAEやGANとは異なる拡散確率モデル、通称「拡散モデル」に基づいていました。
簡単にいえば、DDPMの画像生成は「ノイズまみれの画像から段階的にノイズを取り除き、隠れていた画像を浮かび上がらせる」アプローチです。
この研究は、コードやモデルがオープンソースとして公開され、再現性が高く評価されたこともあり、画像生成の「第3の選択肢」として注目を集めました。
その後の発展としては、Stable Diffusion(2022年)やOpenAIのDALL·E 2(2022年)などに受け継がれ、拡散モデルは現代の画像生成AIの中心技術の一つへと成長していきます。
ちなみに、OpenAIのDALL·E(バージョン1、2021年)では、画像生成の部分において、dVAE(Discrete Variational Autoencoder)というVAEの一種が採用されており、拡散モデルは用いられていませんでした。
つまり、OpenAIは当初VAEベースのアプローチを採用していたものの、後に拡散モデルへと軸足を移したことになります。
今回の記事では、まず最初にDDPMの概念的な理解にフォーカスし、「拡散モデルとは何か」「どこが画期的だったのか」を解説します。その上で、最後に拡散モデルにおける変分理論のELBOの一般的な形を導出します。
拡散モデルの2つの過程
DDPMの理論的な枠組みは、2つの確率過程によって構成されています。
確率過程(stochastic process)とは、時間やステップに応じてランダムに変化する量を確率的にモデル化したものです。
なお、論文では拡散過程をフォワード過程(forward process)、生成過程をリバース過程(reverse process)とも呼んでいますが、意味的に明白ではないのでこの記事では「拡散過程」と「生成過程」に統一します。
拡散モデルでは、画像が徐々にノイズ化されていく、あるいは逆にノイズが取り除かれていくというプロセスを、この「時間軸に沿った確率的な変化」としてモデル化しています。
下図は、DDPMにおける確率過程を示したものです。
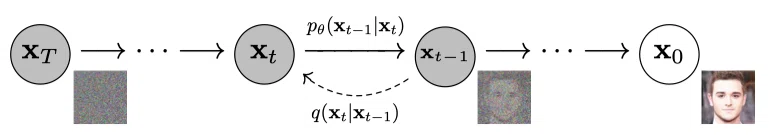 論文:図1
なお、画像データは数式として扱うのが便利なのでベクトルxとして表現しています。実際の画像データが1次元ベクトルだという意味ではありません。
注意点:モデル化と実際の処理の違い
拡散モデルでは、「拡散過程」と「生成過程」という2つの確率過程によって理論的にモデル化されていますが、学習や推論で行われる処理は、これらの過程と必ずしも一対一には対応していません。
拡散過程によるノイズ付加
拡散過程では、画像x0に対して、段階的にガウスノイズを加えていくと考えます。
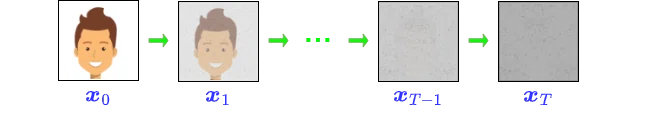
ただし、これはあくまで理論上の想定です。
実際の学習時には、ランダムに選んだステップtに応じてx0からxtまでのノイズを一度に計算して加えるようにしています。
つまり、すべての拡散ステップを逐次的に行うことはありません。また、ランダムにステップを選ぶことはモデルの汎化性能を高め過学習を防ぐ効果もあります。
ディープラーニングにおいては、学習データは独立にサンプリングされていると仮定されており、相関の強いデータを用いると、モデルが不必要なバイアスを学習する恐れがあるためです。
それでも、このように「拡散過程は少しずつノイズを加えていく過程」として捉えることで、確率モデルとしての理論的な整合性が得られます。
なお、ここでの「段階的にノイズを加える」という操作は、画像の各ピクセル(RGBの場合は各チャネルの各ピクセルの)ごとに独立にガウスノイズを注入することを意味します。
ステップが進むごとにノイズ量が増していき、やがて画像はほとんど何も識別できない完全なノイズ画像xTへと変わっていきます。
このとき、拡散過程の最終ステップで得られるxTは、各要素が標準正規分布(平均0、分散1)に従うサンプルに近くなるように設定されています。
これは生成過程が標準正規分布からサンプリングされたノイズから画像を生成できるようにするためです。
生成過程によるノイズ除去
生成過程では、上図の左端のノイズ画像xTから出発し、そこからノイズを段階的に取り除いていくと捉えます。
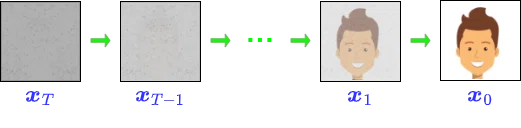
つまり、各ステップで追加されたノイズを予想して、それを除去することで、最終的に元の画像x0を再構成していくというアプローチです。
学習を終えた生成モデルを用いる推論時には、このノイズ除去がステップごとに確率的に行われるため、最終的に得られる画像x0は毎回ランダムに変化します(サンプリングのたびに異なる出力)。
ただし、学習時には段階的な生成処理は行いません。
まず学習では、ランダムに選ばれたステップtに対応するノイズ付き画像xtを合成します。これは拡散過程のモデルから得られる式を使って一気にtステップ分のノイズをx0に付加することで行われます。
次に、このxtを入力としてニューラルネットワークによる決定論的な予測を行います。これによって、xtに含まれているノイズ(または元の画像x0)を一発で推定するため、推論時のような段階的なサンプリングは行われません。
このように、DDPMは学習と推論で処理の流れが大きく異なるという特徴を持っています。しかし、その根底にあるのは「潜在変数から画像を生成する」というVAEやGANにも通じる発想です。
そこで次に、VAEやGANとの共通点と相違点をたどりながら、理解をさらに深めていきましょう。
潜在変数からの画像生成
GANによる生成との比較
GANでは、数十から数百次元のランダムな入力ノイズから画像を生成します。
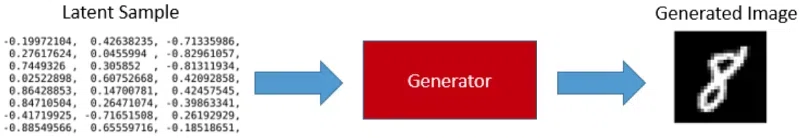
この入力ノイズは通常、標準正規分布(平均0、分散1)からサンプリングされたものです。
学習の初期段階では、これらは単なる意味のないランダムな数値にすぎませんが、
GANの学習が進むにつれて、このノイズが「どのような画像を生成するか」を決定する潜在変数(latent variable)としての役割を果たすようになります。
言い換えると、GANは標準正規分布に従う数値を利用することを学習します。生成する画像の特徴を指定するパラメータの数値として扱うようになるわけです。
その結果、学習後のGANは、ランダムなノイズから多様な画像が生成できるようになります。
この考え方は、DDPMにも当てはまります。
DDPMによる生成(推論)は、GANと同様に標準正規分布からサンプリングされた潜在変数xTを起点として、生成画像を決定するプロセスを学習していると見ることができます。
ただし、GANとの違いとして、DDPMでは生成(推論)が段階的に行われます。
このため、生成においてはxTだけでなく、途中の各ステップのノイズ画像xtもまた、次のステップxt−1を生成するための「潜在変数的な役割」を果たしていると捉えることができます。
また、生成の出発点であるxTのサイズが、最終的に生成される画像x0と同じであるのは、GANと異なります。
GANやVAEにおける潜在変数は、一般に「画像のスタイルや内容を圧縮的に記述する低次元の表現」として設計されます。つまり、元の画像空間よりも次元の小さい意味構造のある潜在空間にマッピングすることで、生成を行います。
一方、DDPMにおける潜在変数(ノイズ画像)は、「意味を圧縮するための記述子」ではなく、「ノイズから元の画像を復元するための確率的な出発点(条件)」としての役割を担っています。
それでも、論文ではDDPMを変分推論に基づく潜在変数モデルとして定式化しており、理論的にはxTからx1を潜在変数とみなした枠組みで学習が理論立てされています。
よって、拡散モデルは確率的生成モデルとして「潜在変数モデル」に分類される一方で、その潜在変数の意味的な扱いや構造的性質は、VAEやGANとは明確に異なると理解すべきです。
このあたりの理論的な枠組み「拡散モデルが潜在変数モデルとしてどのように定式化されているのか」については後述します。
DDPMによる学習安定性
GANの学習が不安定になりがちなのは、生成ネットワークと識別ネットワークが競争して学習する構造になっているためです。
しかし、これらの目的は互いの性能に依存しているため、損失関数が明確に定義しにくく、最適化が難しいという問題があります。
また、片方の性能が大きく勝ってしまうと、もう一方の学習が進まなくなるという不安定性も生じます。
たとえば、生成ネットワークの出力が稚拙すぎて、識別ネットワークが簡単に見抜けてしまうと、識別ネットワークの損失が小さくなり、学習の機会が減ります。
逆に、識別ネットワークの性能が低いと、生成ネットワークの出力をなんでも「本物」と誤認してしまい、生成ネットワークの損失が小さくなるため、改善されずに学習が停滞します。
このため、学習を安定させるには両ネットワークのバランス調整が不可欠であり、学習率や訓練回数などのハイパーパラメータをトライ&エラーで調整する必要があるのが実情です。
つまり、GANにおいて生成ネットワークと識別ネットワークを適切に競わせるためには、高度なチューニングが必要になります。
これに対して、DDPMの画像生成における学習は、はるかに安定しています。その理由は、学習目標が明確に定義されているからです。
DDPMでは、復元すべき画像は常に訓練データそのもの、すなわち元の画像(訓練画像)x0そのものです。
また、学習時に使用する入力画像xtは、ランダムに選ばれたステップtに従い、拡散過程によってx0にノイズを加えることで合成されます。
そのため、DDPMではモデルがさまざまなノイズレベルの画像xtを受け取り、それに対応するx0を復元することを学習します。
結果として、DDPMは幅広いノイズ状態に対応できる柔軟で安定した生成モデルとなります。
VAEによる学習との比較
DDPMの拡散過程と生成過程を、VAEのエンコーダとデコーダと比較してみます。
VAEではまず、エンコーダが入力画像を潜在変数の分布のパラメータ(平均と分散)に変換します。
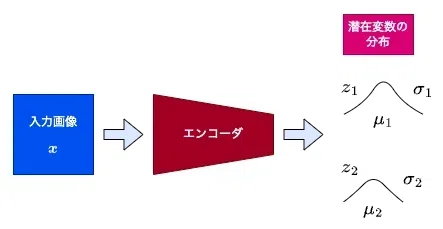
そこから、再パラメータ化トリックを用いて、潜在変数をサンプリングします。
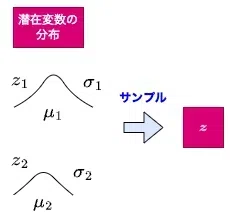
次に、デコーダがその潜在変数から画像を再構成することで、元の画像との誤差を最小化するように学習を行います。
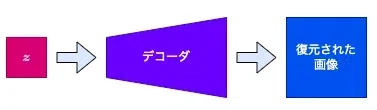
一方、DDPMの拡散過程では、元の画像x0にノイズを加えてノイズ画像xtを合成します。
この拡散過程は、画像をノイズ(=潜在変数)へと変換するプロセスであり、その意味ではVAEのエンコーダと類似した機能を持ちます。
画像から潜在変数(ノイズ付き画像)への変換(推定)を行うので「フォワード処理」(forward process)とも呼ばれます。
次に、DDPMの生成過程では、ノイズ画像(潜在変数)x0からノイズを削除して元の画像x0を復元することを学習します。
この生成過程は、ノイズ(=潜在変数)から画像を復元(生成)するプロセスであり、機能的な役割はVAEのデコーダと対応していると言えます。
潜在変数(ノイズ付き画像)から画像を復元するので「リバース処理」(reverse process)とも呼ばれます。
しかし、共通するのはおおむねこのくらいです。
DDPMの拡散過程は、あらかじめ決められたノイズの加え方に従って処理を行うものであり、VAEのエンコーダのように入力画像から分布を学習する構造にはなっていません。
また、DDPMの生成過程は、さまざまなノイズレベルの画像から元画像を復元することを学習します。しかし、VAEのデコーダには異なるレベルの潜在変数があるわけではありません。
さらに、学習済みのDDPMでは、推論(生成)時に各ステップごとにサンプリングが行われるため、VAEの「デコーダの入力だけが潜在変数となる」構造とは決定的に異なります。
DDPMの生成画像の精度
VAEは「入力画像 ≒ 復元画像」となるように学習しますが、中間に潜在変数のサンプリングが挟まるため、元の画像を厳密に復元することを目指していません。
この学習の構造的な制約により、生成される画像は潜在変数に従った「平均的な出力」になりやすく、その結果としてややぼやけた画像になる傾向があります。
さらに、VAEでは「潜在空間の連続性」が重視されており、潜在変数全体が標準正規分布に従うようにするためのKLダイバージェンス項が損失関数に含まれています。この設計は、標準正規分布からサンプリングして画像生成できるようにするためのものであって、必ずしも生成画像の精細さを最大化することが目的ではありません。
DDPMでは、ノイズを段階的に除去することで画像を直接復元するという学習アプローチが採られています。
この方法では、各ステップで「どれだけノイズを取り除けば元の画像に近づくか」を予測することにより、明示的に、元画像と同じ精度の画像を再構成することを目指して学習が行われます。
DDPMの拡散過程によるノイズにはランダム性が含まれていますが、それはVAEのように「画像の意味的な特徴をサンプリングする」ことが目的ではありません。
このノイズは、生成過程における学習で使用される「ノイズ付き入力画像」xtを合成するために用いられます。すなわち、さまざまなノイズレベルの画像から、元の画像x0を復元する能力を学習するための訓練材料として機能しています。
これは、VAEの学習における「潜在変数をサンプリングし、それによって元の画像と微妙に異なる画像を生成する」という構造とは本質的に異なります。
VAEではこの仕組みによって、潜在変数の連続的な変化が、画像の意味的特徴の連続的な変化に対応することを目指しています。つまり、潜在空間を滑らかに保ち、潜在変数の変化によって意味的操作が可能な表現を得ることが目的です。
これに対して、DDPMの画像生成における学習では、あくまでノイズを除去し、オリジナルの画像を再構成することを目指しています。連続的な意味操作よりも、復元精度そのものが学習の主眼となっています。
結果として高精度かつリアルな画像生成が可能になります。
ただし、DDPMは生成に多くのステップを要するため、推論時間が長くなるという実用上の課題もあります。
次に、数式を用いて拡散過程と生成過程をモデル化し理解することを目指します。
なお、ここからの議論では、しばらく学習や推論で行われる実際の段取りなどを一旦忘れて、数式によるモデル化に集中します。
生成過程を数式で理解する
そもそも生成モデルとは、観測データの背後にある確率分布を学習し、その分布から新たなサンプルを生成することを目的とするモデルです。これにより、実際には存在しないが、学習データと統計的に類似した特徴を持つデータ(たとえば画像など)を生成することが可能になります。
このような性質から、生成モデルの理論を正しく理解するには、確率分布やその変化を数式的に捉える視点が不可欠です。
生成ステップの遷移確率
生成過程は、最終的なノイズ画像xTから出発し、そこから段階的にノイズを削除していくことで、意味のある画像x0を生成する確率的な過程として定式化されます。
すでに言及しましたが、生成方向は拡散方向と逆であり、ステップtがTからtへと減少する方向に進むので「リバース過程」(reverse process)と呼ばれます。なので、ステップが減る方向が進行方向であることを念頭に置いて以下を読み進めてください。
この生成過程のステップtにおける遷移は、条件付き確率pθ(xt−1∣ xt)によって記述され、次のようなガウス分布でモデル化されます。
Pθ(xt−1∣ xt)=N(xt−1;μθ(xt,t),Σθ(xt,t))
ここでの各記号の意味は以下の通りです。
θ:学習されるパラメータ(ネットワークの重み・バイアスなど)
N:多変量ガウス分布
μθ:xtとステップtを入力として予測される平均ベクトル
μθ:同様に予測される共分散行列
このように、生成過程では、各ステップtにおいて「次の状態」xt−1をガウス分布としてサンプリングすることを学習します。これは、ノイズを少しずつ除去していく操作を、確率的な形式でモデル化したものです。
なぜ、ガウス分布(正規分布)を用いるのかというと、これは与えられた平均と共分散以外に余計な仮定を導入せずに不確実性を表現できるからです。そのため、確率的なモデリングにおいて非常によく使われる常套手段です。
確率分布を用いて「ある入力に対して次の状態がどうなるか」をモデル化する際に、ガウス分布は次のような利点があります。
最小限のパラメータ(平均ベクトルと共分散行列)だけで定義できる
連続空間上の分布であり、ノイズや誤差のモデル化に適している
再パラメータ化トリックなど、勾配ベースの学習に便利な性質を持つ
最大エントロピー原理に基づき、「我々が知らない情報を勝手に仮定しない」
したがって、DDPMにおけるステップごとの画像遷移を確率的に扱う際にも、過度な仮定を導入せず、柔軟かつ計算効率よくモデリングできるという点でガウス分布が選ばれています。
生成過程全体の遷移確率
この条件付き確率を用いることで、ノイズ画像xTから意味のある画像x0へと至る生成過程全体の遷移確率Pθ(x0:T)は、次のように定義されています。
Pθ(x0:T)=P(xT)Pθ(xT−1∣xT)… Pθ(xt−1∣xt)… Pθ(x0∣x1)=P(xT)t=1∏TPθ(xt−1∣xt)
この定式化をよく見ると、初期分布P(xT)にパラメータθが含まれていません。これは、生成の出発点であるxTが、あらかじめ決められた確率分布(標準正規分布)からサンプリングされるため、ニューラルネットワークによって学習する必要がないからです。
P(xT)=N(xT;0,I)
ここでIは単位行列です。これは、対角線上が1でそれ以外は0の行列です。共分散行列として捉えると各要素の分散が1ですべての共分散が0になります。
すなわち、xTの各ピクセル(要素)は 独立かつ同一の標準正規分布に従ってサンプリングされます。
このようにして得られるxTは完全なノイズ画像であり、空間的な相関や意味的な構造は一切含まれていません。
しかし、それに続くステップの遷移確率には学習パラメータが含まれています。
Pθ(xT−1∣xT)
よって、完全なノイズに至る一歩手前のノイズ状態xT−1をxTを条件としてサンプリングしていることになります。この際に学習から得られたパラメータが用いられています。
さらに、その一歩手前のノイズ状態xT−2をサンプリングし、次々と一歩手前へと継続して行っていくと最終的にノイズがない「意味のある画像」が生成されるというわけです。
Pθ(xT−1∣xT)… Pθ(xt−1∣xt)… Pθ(x0∣x1)
これが生成過程を確率分布としてモデル化したものであり、ノイズから少しずつサンプリングによって意味構造を構築していく過程を表現しています。サンプリングによる生成なので実行するたびに異なる画像が生成されることになります。
マルコフ連鎖である理由
もう一つのポイントは、各ステップtにおける遷移確率Pθ(xt−1∣xt)は、直前の状態xtだけに依存していることです。
このような確率過程の設定を「マルコフ連鎖」(Markov Chain)と呼びます。
マルコフ連鎖とは「未来の状態が現在の状態のみに依存し、過去の状態には依存しない」という性質を持つ確率過程です。このような性質が成立しているとき「マルコフ性が成り立っている」と言います。
マルコフ性が成り立たない場合には、次の状態を決定するために、過去の複数の時点の情報が必要となります。これにより、モデルの構造は複雑になり、計算コストも大きくなります。
たとえば、「将来の株価を過去5日間の株価から予測する」といったケースでは、次の状態が現在の状態だけではなく複数の過去の状態に依存しているため、これはマルコフ連鎖とは言えません。
生成過程のように逐次的な確率過程は、マルコフ連鎖としてモデル化できるならば、それが大きな利点となります。
各ステップの遷移確率を簡潔に定義できる
サンプリング処理が逐次的かつ効率的に行える
モデル設計がシンプルになり、学習が安定する
よって、マルコフ連鎖でモデル化して学習が可能なのであれば、モデル設計の単純さと計算効率とを両立できるわけです。そのため、多くの確率過程の定式化でマルコフ性を想定するのは常套手段となっています。
仮に、画像生成モデルの生成過程においてマルコフ性が成り立たなければ、各ステップでの生成に複数の過去ステップの状態を参照する必要があり、依存関係の学習やサンプリング処理が非常に複雑になります。さらに、サンプリングする際にも条件付き確率が複雑になります。
このため、DDPMの生成過程は、マルコフ連鎖によって定式化されています。
次にノイズを含んだ画像を合成する拡散過程の数式モデルを解説します。
ここでもまた、学習や推論で行われる実際の段取りなどを一旦忘れて、数式によるモデル化に集中します。
拡散過程を数式で理解する
拡散ステップの遷移確率
拡散過程は、画像x0に段階的にノイズを加えていき、最終的に完全なノイズxTに変換する確率過程のことです。
この拡散過程は、以下のような条件付き確率として定式化されています。
Q(xt∣ xt−1)=N(xt;1−βtxt−1,βtI)
ここでIは単位行列です。生成モデルでも登場しました。各ピクセル(要素)に対して、独立かつ同一の標準正規分布に従ったサンプリングが行われます。
さらに、サンプリングされた値を分散βtでスケールしているので、画像の各要素に平均0・分散βtのガウスノイズを付加していることになります。
こうして、各ステップでは、ごく少量のノイズが加えられます。
なお、β1,…,βTと分散を順番に並べたものを「分散スケジュール」(variance schedule)と呼びます。よって、モデルはこのスケジュールに従って、画像を徐々に拡散(ノイズ化)している表現できます。
拡散過程全体の遷移確率
この拡散過程全体(x0からxT)を数式で表すと、以下のようになります。
Q(x1:T∣x0)= Q(xT∣xT−1)…Q(xt∣xt−1)…Q(x1∣x0)=t=1∏TQ(xt∣xt−1)
これも生成過程同様にマルコフ連鎖になっています。よって、一つ前の状態にノイズを付加していくという単純な構造になっています。
なお、拡散過程における条件付き確率Qにはパラメータがありません。
ガウス分布を使っていますが、その平均と分散は上述の式と分散スケジュールによって計算されるものであって学習されるものではありません。
各ステップtにおけるノイズの分散βtを学習対象とすること自体は理論的に可能です。しかし、このパラメータは生成過程の学習にも強く影響するため、学習を安定化させるのが非常に難しくなります。
ただし、DDPM以降には、分散スケジュールを学習する研究が行われています。
なぜ標準正規分布になる?
生成モデルが生成開始の入力として使うノイズは標準正規分布からサンプリングされたものと仮定しています。だとすると、拡散過程によるノイズの最終結果は標準正規分布からサンプリングされたものに近くなる必要があります。
もう一度、拡散ステップの遷移確率を見てみます。
Q(xt∣ xt−1)=N(xt;1−βtxt−1,βtI)
ここで興味深いのは、1−βtによって前の画像のピクセル値をスケーリングして縮小していることです。
このようになっている理由の一つは、各ステップで追加されるノイズによって画像の分散が「暴走」しないようにコントロールするためです。
もし、仮にスケールせずに単純にノイズを足し続けると、各ステップで分散がどんどん増えてしまい、最終的に最初の画像から比べると非常に大きなノイズになってしまいます。
1−βtでスケールすることで、前の画像の寄与を徐々に減らしつつ、ノイズの寄与を増やすことができ、分散が適切にコントロールされます。
このことを数式で表現してみます。画像の各要素に付加されるガウスノイズは独立なので一つの要素x(スカラー変数)に注目して、次のように表現しなおします。
xt=1−βt xt−1+βtϵ, where ϵ∼N(0,1)
ここで、ϵは標準正規分布からサンプリングされたノイズの値です。これが標準偏差βtでスケールされて加算されているので、平均0・分散βtのガウスノイズがこの要素に付加されています。
このようにして計算されたxtの平均は次のようになります。
E[xt]=E[1−βt xt−1+βtϵ]=1−βtE[xt−1]
ここでϵの平均が0であることを使いました。
この平均の表現は一つ前のステップへと続けることができます。
E[xt]=1−βtE[xt−1]=1−βt1−βt−1E[xt−2]⋮=i=1∏t1−βtE[x0]
βtは、1より小さい正の値なので、十分に大きなtを取ると、これは平均の値が0に近づくことを意味します。
また、xtの分散は次のようになります。
Var[xt]= Var[1−βtxt−1+βtϵ]= Var[1−βtxt−1]+Var[βtϵ]=(1−βt)Var[xt−1]+βt
ここで、xt−1とϵが独立であり、またϵの分散が1であることを利用しました。
これを前のステップに次々と遡っていくと以下になります。
Var[xt]=(1−βt)Var[xt−1]+βt=(1−βt)[(1−βt−1)Var[xt−2]+βt−1]+βt=(1−βt)[(1−βt−1)[(1−βt−2)Var[xt−3]+βt−2]+βt−1]+βt⋮=(i=1∏t(1−βi))Var[x0]+k=1∑t(j=k+1∏t(1−βj))βk
なお、第2項でk=tの場合にj=t+1∏t(…)=1と定義してβtを含めています。
第1項は、初期画像x0の分散がステップごとのスケーリングを通じて指数的に減衰し、最終的に無視できるほど小さくなる(0に近づく)ことを意味します。
したがって、第2項(ノイズの累積による分散)が漸近的に 1 に近づくように、
分散スケジュールβtを適切に設計すれば、最終状態xTにおいては、元の画像の情報は完全に失われ、全ての要素が標準正規分布に従うノイズに近づくようにできます。
xT∼N(0,I)
このようにして、拡散過程の終点xTは、生成モデルの入力として仮定されるノイズ分布と整合するようになっています。
なお、生成過程における学習は、拡散過程によって付加されるノイズを学習します。よって、その損失に拡散過程からの情報を利用することが重要です。
ノイズを学習する変分推論
ここでは、拡散モデルに変分推論を適用して学習のための損失を導出します。
拡散モデルと変分推論
初期状態x0から出発し、ステップごとにノイズが付加されて順方向に状態が変化していくマルコフ連鎖を考えます。
x0→x1→x2→…→xT
そこで、最終状態xTを与えられた上で、初期状態x0を復元したいとします。そのために、過程全体の同時確率P(x0:T)に注目します。
順方向の確率過程は、マルコフ性より次のように表されます。
P(x0:T)=P(x0) P(x1∣x0)⋯ P(xT∣xT−1)=P(x0)t=1∏T P(xt∣xt−1)=P(x0) P(x1:T∣x0)
逆方向の展開を行うと次のようになります。
P(x0:T)=P(xT)P(xT−1∣xT)⋯P(x0∣x1) =P(xT)t=1∏T P(xt−1∣xt)=P(xT)P(x0:T−1∣xT)
この二つは同じ同時分布の別表現であり等価なので次の関係が成り立ちます。
P(x1:T∣x0)=P(x0)P(x0:T−1∣xT)P(xT)
つまり、順方向の過程x0→xTの構造が分かれば、逆方向の過程xT→x0も定義可能であることを示しています。
しかし、この式の分母の周辺分布P(x0)は画像データのようにx0が高次元な場合に計算が非常に困難です。
それでもこの関係を利用したいので、計算しやすい関数による近似を考えます。これはVAEにおける変分推論と基本的には同じ考え方です。
変分下限(ELBO)の導出
DDPMでは、P(x1:T∣x0)を分散スケジュールによる拡散過程としています。
Q(x1:T∣ x0)=t=1∏T Q(xt∣ xt−1)=t=1∏T N(xt;1−βtxt−1,βtI)
これは簡単に計算でき、最終状態を標準正規分布に近づけるように設定できるという利点があります。
また、P(x0:T−1∣xT)は、ニューラルネットワークPθ(x0:T−1∣xT)によって学習します。
Pθ(x0:T)= P(xT)Pθ(x0:T−1∣xT)= P(xT)t=1∏T Pθ(xt−1∣xt)= P(xT)t=1∏T N(xt−1;μθ(xt,t),Σθ(xt,t))
この関数は、拡散過程が合成するノイズ付き画像xtから元の画像x0を予測することで学習します。
そして、この二つの関数を上記の関係を利用して結びつけることで損失関数(変分下限、ELBO)を計算します。
式の導出はVAEの記事と同じなのでここでは詳細は省略しますが、そこで次のKLダイバージェンスを最小化することで得られます。
DKL(Q(x1:T∣x0)∥ Pθ(x1:T∣x0))=Ex1:T∼ Q(x1:T∣x0)[logPθ(x1:T∣x0)Q(x1:T∣x0)]=Ex1:T∼ Q(x1:T∣x0)[logQ(x1:T∣x0)−logPθ(x1:T∣x0)]=Ex1:T∼ Q(x1:T∣x0)[logQ(x1:T∣x0)−log(Pθ(x0)Pθ(x0:T))]=Ex1:T∼ Q(x1:T∣x0)[logQ(x1:T∣x0)−logPθ(x0:T)+logPθ(x0)]=Ex1:T∼ Q(x1:T∣x0)[logPθ(x0:T)Q(x1:T∣x0)]+logPθ(x0)
KLダイバージェンスは0以上になるので以下の関係が導かれます。
logPθ(x0)=Ex1:T∼ Q(x1:T∣x0)[−logPθ(x0:T)Q(x1:T∣x0)]+DKL(Q(x1:T∣x0)∥ Pθ(x1:T∣x0)) ≥Ex1:T∼ Q(x1:T∣x0)[logQ(x1:T∣x0)Pθ(x0:T)]
これに、Pθ(x0:T)とQ(x1:T∣ x0)の式を代入します。
logPθ(x0)≥ Ex1:T∼ Q(x1:T∣x0)logt=1∏T Q(xt∣ xt−1)P(xT)t=1∏T Pθ(xt−1∣xt)=Ex1:T∼ Q(x1:T∣x0)[logP(xT)+t=1∑T logPθ(xt−1∣xt) +t=1∑TlogQ(xt∣xt−1)]=Ex1:T∼ Q(x1:T∣x0)[logP(xT)+t=1∑T logQ(xt∣xt−1)Pθ(xt−1∣xt)]
logPθ(x0)は、モデルの対数尤度です。
尤度は、モデルがデータの確率を計算したものです。データは現実なものなので、尤度が高いほどモデルが観測データの分布を正しく反映していることになります。
つまり、右辺の式がモデルの対数尤度の下限となっており、これを変分下限(Evidence Lower Bound, ELBO)と呼びます。これは、近似分布Qを用いて計算された、モデルの対数尤度の下限です。
ELBOを大きくする(最大化する)ことは、モデルの対数尤度を高めることにつながります。また同時に、近似分布QとPθ(x1:T∣x0)のズレを表すKLダイバージェンスも小さくなり、ELBO自体が優れたモデル評価指標として機能します。
実装上は、このELBOの符号を反転したもの(=負のELBO)を損失関数として最小化することで、学習が行われます。
この変分下限の考え方は、VAEにも用いられた手法であり、特に高次元なデータ(画像など)に対して有効です。さらに、マルコフ連鎖に基づくモデルでは、各ステップを逐次的かつ独立に評価できるため、ELBOの計算が効率的に行えるという利点もあります。
次回予告
今回の記事では、DDPMにおける拡散過程・生成過程の確率的モデリングと、
それに基づく変分推論の枠組みについて理論的に整理しました。
次回からは、分散スケジュール、導出されたELBOによる損失関数の中身、生成モデルの実装について数回に分けてより詳しく見ていきます。
お楽しみに!


