線形代数は深層学習における計算の基本となっている。また、確率・統計にも深い関わりがある。
といってもライブラリなどで機械学習を現場で使っている人にはそれほど必要ではないかもしれない。
この記事では固有値分解と特異値分解を取り上げる。両方ともデータの特徴を抽出するのに役立つ。
特異値分解の知識があると疑似逆行列も理解できる。ただし、行列の積や行列式などは前提知識として必要になる。
また、全て実数値のみ(複素数なし)を扱う。
ノルム
ノルムとは長さや距離の概念を一般化したもの。ベクトルxに対して、いくつかのノルムが定義される。
x=x1x2⋮xn
ちなみに、スペースを省くために横ベクトルを転置した形式で表記することもよくあります。
x=(x1,x2,…,xn)T
L1ノルム
L1ノルムは、各要素の絶対値の総和。
∥x∥1=i=1∑n∣xi∣
L2ノルム
L2ノルムは、各要素の2乗の総和。
∥x∥2=i=1∑nxi2
内積でも表現できる。
∥x∥2=x⋅x
L∞ノルム
L∞ノルムは、各要素の絶対値の最大値。
∥x∥∞=imax∣xi∣
ノルム
単に「ノルム」と言う場合はL2ノルムの平方根。
∥x∥=x⋅x
ベクトルの距離
ノルムに関連して2つのベクトル間の距離も一般化され種類がある。
固有値分解や特異値分解にはあまり関係がないがノルムを説明したのでここに記す。
ベクトルx=(x1,x2,…,xn)⊤とy=(y1,y2,…,yn)⊤に対して以下の距離が定義される。
マンハッタン距離
ニューヨークのマンハッタン街の道に沿って測ったかのような距離。日本人には碁盤の目に沿って測ったような距離といった方が分かりやすいかも。平安京とか。
d(x,y)=i=1∑n∣xi–yi∣
ユークリッド距離
これはいわゆる通常の距離。
d(x,y)=i=1∑n(xi–yi)2
ミンコフスキー距離
これは、マンハッタン距離やユークリッド距離を一般化したもの。
d(x,y)=(i=1∑n∣xi–yi∣p)p1
pは整数で、p=1ならば、マンハッタン距離、p=2ならば、ユークリッド距離ど同等。
マハラノビス距離
xとyが同じ確率分布に従うと仮定した場合における2つのベクトルの類似度の指標。
D(x,y)=(x–y)⊤Σ−1(x–y)
行列の種類
いろいろあってややこしいのでまとめる。固有値分解や特異値分解を理解するのに必要な知識。
以下は全て正方行列の仲間。
正方行列
縦横が同じ数ある行列。n×n行列とかm×m行列と表現する。
これに対し、一般の行列はn×m行列あるいはm×n行列。
例:3×3行列
A=147258369
正則行列
逆行列A−1が存在する行列Aを正則行列と呼ぶ。
逆行列が存在するので正方行列でもある。
AA−1=A−1A=I
Aの行列式が0ではない:det(A)≠0。
直行行列
転置行列ATが逆行列になっている行列Aを直行行列と呼ぶ。
逆行列が存在するので正則行列でもある。よって正方行列でもある。
AT=A−1
対称行列
転置行列ATが元の行列と同じになる行列Aを対称行列と呼ぶ。
もちろん正方行列でもある。
AT=A
代表的なものに共分散行列がある。
対角行列
対角の要素以外は全て0になっている行列Aを対角行列と呼ぶ。
転置したも同じなので対称行列でもある。よって正方行列でもある。
例:3×3の対角行列
A=900050003
固有値分解などで登場する。計算が楽になる行列。
固有値、固有ベクトル
固有値(Eigenvalue)、固有ベクトル(Eigenvector)は以下に定義される。
正方行列Aとベクトルxが次の関係を持つとき、
Ax=λx
λはスカラーで固有値、ベクトルxを固有値λに属する固有ベクトルと呼ぶ。
正方行列Aと固有ベクトルxとの積は元のベクトルxのスカラー倍になり方向は変わらない。
通常、固有ベクトルはノルム ∥x∥ が1になるように定める。さもないと、拡大縮小することで無限に固有ベクトルを作れてしまうから。
しかし、ノルムが1でなくとも固有ベクトルとしての性質には変わらない。
具体例
固有値を求めるには上式を変形した次の関係を利用する。
(A–λI)x=0
仮に、A–λIの逆行列が存在すると、xがゼロ・ベクトルになってしまう。
つまり、xがゼロ・ベクトルでないならば、A–λIには逆行列が存在しては困る。
よって A–λI の行列式が0になる必要がある。さもないと固有値も固有ベクトルも存在しない。
det(A–λI)=0
例えば、
A=[4312]
det(A–λI)=0 として、
det(A–λI)=4–λ312–λ=(4−λ)(2−λ)−3=0
上式を解くと、
∴λ=1,5
次に、固有ベクトルを
x=[x1x2]
とすると、Ax–λx=0 より、λ=1に属する固有ベクトルは、
[4−1312−1][x1x2]=[00] ∴3x1+x2=0
上記の条件を満たす x1,x2 は、
x1x2=−31t=t
となる。tは任意の実数。
ノルムが1になるように x12+x22=1 を満たすように調節する。
x=−101103
となる。もちろん、負号を入れ替えた(101,−103)Tでも良い。
ベクトルの向きが逆になるだけなので、どちらかを選ぶ。
同様に、固有値λ=5に対して、
x=2121
もちろん、負号を入れ替えても良い。
行列式と固有値:
行列式の知識を使って固有値を求めたが、実は行列式は固有値を全て掛け合わせたものに等しい。
また、行列Aの行列式det(A)の絶対値は、行列Aによる乗算が空間をどのくらい拡大(あるいは圧縮)するかを示している。
(A–λI)x=0でdet(A–λI)=0となるのは行列(A–λI)による乗算が空間を原点に圧縮しているとも見れる。ちょっとしたブラックホールみたいでもある。
Numpy
上述の例では2x2の行列だったが3x3やそれ以上の場合も同じアプローチで計算できる。
ただし、行列式の計算が面倒臭いので、プログラムを使えば良い。
import numpy as np


A = np.array([
    [1, 2, 3],
    [4, 5, 6],
    [7, 8, 9]])

print('A=')
print(A)
print()

values, vectors = np.linalg.eig(A)

print('固有値')
print(values)
print()

print('固有ベクトル')
print(vectors)
A=
[[1 2 3]
 [4 5 6]
 [7 8 9]]

固有値
[ 1.61168440e+01 -1.11684397e+00 -1.30367773e-15]

固有ベクトル
[[-0.23197069 -0.78583024  0.40824829]
 [-0.52532209 -0.08675134 -0.81649658]
 [-0.8186735   0.61232756  0.40824829]]
第一列の固有ベクトルを使ってみる。
λ = values[0]
x = vectors[:, 0]

print('λ * x')
print(λ * x)

print('A @ x')
print(A @ x)
λ * x
[ -3.73863537  -8.46653421 -13.19443305]
A @ x
[ -3.73863537  -8.46653421 -13.19443305]
ちゃんと固有値と固有ベクトルになっています。ただし、結果が行ベクトルになっています。
列ベクトルの形を崩したくなければ、固有ベクトルxxの取り出し方を以下のようにします。
λ = values[0]
x = vectors[:, 0:1]

print('λ * x')
print(λ * x)

print('A @ x')
print(A @ x)
λ * x
[[ -3.73863537]
 [ -8.46653421]
 [-13.19443305]]
A @ x
[[ -3.73863537]
 [ -8.46653421]
 [-13.19443305]]
ちなみに、Jupyter notebookのセルで \lambda と打ってTabキーを押すとギリシャ文字の λ に変換されます。
対称行列
対称行列の固有ベクトルは直行する。
固有値 λ1,λ2 (λ1=λ2) に対する固有ベクトルを x1,x2 とし、内積 x1⋅x2 に λ1 をかけると、
λ1x1⋅x2=(λ1x1)⊤x2内積を行ベクトルと列ベクトルの積に=(Ax1)⊤x2=x1⊤A⊤x2=x1⊤Ax2 対称行列は転置しても同じ=x1⊤λ2x2=λ2x1⊤x2=λ2x1⋅x2 内積に戻す
これは、
λ1x1⋅x2=λ2x1⋅x2
を意味するが、λ1=λ2 なので、
x1⋅x2=0
でなければならない。よって対称行列における異なる固有ベクトルは直行する。
以上の知識があれば固有値分解が理解できる。
固有値分解
固有値分解(Eigendecomposition)は以下に定義される。
固有値と固有ベクトルを使うと正方行列Aは次のように固有値分解できる。
A=QΛQ−1
Qは固有ベクトルを要素として持つ行列。列ベクトル xi (i=1∼n) が固有ベクトル。
Q=[x1x2…xn]
Λはギリシャ文字のラムダの大文字で、ここでは固有値を対角要素としてもつ対角行列を表す。
Λ=λ10⋮00λ2⋮0……⋱…00⋮λn
Qの対角にある固有値は順番に並べる。例えば、大きい値から小さい値へ、あるいはその逆。つまり、
λ1≤λ2≤⋯≤λn
か
λ1≥λ2≥⋯≥λn
利点
分解することで行列(データ)の特徴が見える。
小さい(ほとんどゼロの)固有値を無視することで次元削減ができる。
また、Anの計算が楽になる。
An=(QΛQ−1)n=(QΛQ−1)(QΛQ−1)…(QΛQ−1)=QΛ(Q−1Q)Λ(Q−1Q)Λ…Λ(Q−1Q)ΛQ−1)=QΛnQ−1
対角行列Λのn乗は対角要素をn乗するだけ。
証明
固有値分解が可能なことを証明するには式を変形して、
AAQ=QΛQ−1=QΛ
が示せればいい。よって、
AQ=A[x1 x2 … xn]=[Ax1 Ax2 … Axn]=[λ1x1 λ2x2 … λnxn]=[x1 x2 … xn]λ10⋮00λ2⋮0……⋱…00⋮λn=QΛ
上記の計算では、列ベクトル xi (i=1∼n) が固有ベクトルであることを利用している。
Numpy
import numpy as np


A = np.array([
    [1, 2, 3],
    [4, 5, 6],
    [7, 8, 9]])

print('A=')
print(A)
print()

# 固有値と固有ベクトル
values, vectors = np.linalg.eig(A)

Λ = np.diag(values)
Q = vectors

QΛQinv = Q @ Λ @ np.linalg.inv(Q)

print('QΛQinv=')
print(QΛQinv)
A=
[[1 2 3]
 [4 5 6]
 [7 8 9]]

QΛQinv=
[[1. 2. 3.]
 [4. 5. 6.]
 [7. 8. 9.]]
QΛQ−1の値が浮動小数点になっていることを除けばAの値と合致します。
もし、気になるのであればAを定義するときにデータ型を指定すれば良い。
A = np.array([
    [1, 2, 3],
    [4, 5, 6],
    [7, 8, 9]], dtype=np.float64)

print('A=')
print(A)
A=
[[1. 2. 3.]
 [4. 5. 6.]
 [7. 8. 9.]]
直行行列
前述したように、Aが対称行列だと、異なる固有値は直行する。さらに、固有ベクトルのノルムを1にしておくと、固有値ベクトルを集めた行列Qは直行行列になる。
Qが直行行列だと、QQ⊤=IなのでQ⊤=Q−1となり、
A=QΛQT
の関係が成り立つ。固有値分解と言うとこれを指すことが多い。
対称行列を使ってNumpyで実際にやってみます。
import numpy as np


# 対称行列
A = np.array([
    [1, 2, 3],
    [2, 5, 6],
    [3, 6, 9]], dtype=np.float64)

print('A=')
print(A)
print()

# 固有値と固有ベクトル
values, vectors = np.linalg.eig(A)

Λ = np.diag(values)
Q = vectors

QΛQT = Q @ Λ @ Q.T

print('QΛQT=')
print(QΛQT)
A=
[[1. 2. 3.]
 [2. 5. 6.]
 [3. 6. 9.]]

QΛQT=
[[1. 2. 3.]
 [2. 5. 6.]
 [3. 6. 9.]]
理論通りに結果が出ると楽しい。
ちなみに、Qが直行行列であることを確かめてみます。
QQT = Q @ Q.T

print('QQT=')
print(QQT)
QQT=
[[ 1.00000000e+00  5.55111512e-17 -1.80411242e-16]
 [ 5.55111512e-17  1.00000000e+00  0.00000000e+00]
 [-1.80411242e-16  0.00000000e+00  1.00000000e+00]]
対角は1でそれ以外は0のはずですが、非常に小さい0でない値が入っている。
これはコンピュータによる数値計算の精度に限界があるため。
なので実際にプログラムを組むときはある程度小さい値はゼロと見なすなど必要に応じて判断する必要がある。
逆に、小さすぎる値は0になってしまうこともある。
固有値分解は正方行列(特に対称行列)を分解するのに有効だが、世の中には正方でないデータが多い。
よって次の特異値分解が役に立つ。ただし、特異値分解を理解するには固有値分解の知識が必要となる。
特異値分解
特異値分解(Singular Value Decomposition)は略してSVDと呼ばれる。
全ての行列にSVDは存在する。よって固有値分解より条件がゆるく使い勝手が良い。
分解される行列は正方行列でなくともOK。
行列Aをm×n行列とすると、
A=UΣV⊤
に分解することができる。
Uはm×mの直行行列、Σはm×n対角行列、VTはn×nの直行行列Vの転置行列。
Σの構造は以下のようになる。左上に特異値を対角要素に持った対角行列をもち、それ以外は全て0。
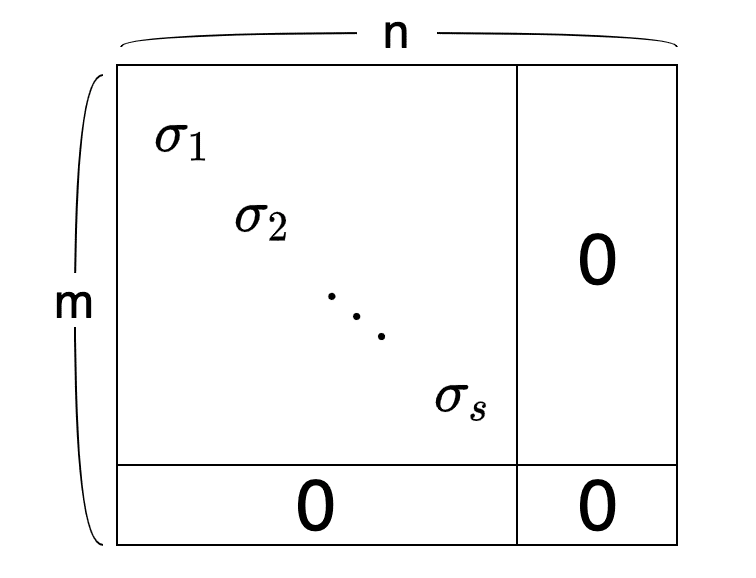
このσ1≥σ2≥⋯≥σs≥0を特異値と呼ぶ。この特異値の数は行列Aのランクに一致する。
ランクは行列内にある独立な列ベクトルの数。独立とはある列ベクトルを他の列ベクトルの組み合わせで表現できないこと。
計算
基本的な考え方は、Aが正方行列ではないのでAATあるいはATAで正方行列を作り、固有値問題にする。
その際に計算が楽になる方を選ぶ。
まず、AATを計算すると、
AA⊤=UΣV⊤(UΣV⊤)⊤=UΣV⊤VΣ⊤U⊤=UΣΣ⊤U⊤=UΣm2U⊤
となる。Vが直行行列なのでVTV=Iになることを利用した。
また、∑m2=∑∑Tとしている。∑m2はm×mの対角行列。
AATに右からUを掛ければ、
AA⊤U=UΣm2U⊤U=UΣm2
となる。ここでは、Uが直行行列であることを利用した。
よって、∑m2の対角がAATの固有値σi2で、Uの列ベクトルが固有ベクトル。
つまり、AATの固有値と固有ベクトルを解けば、Uとσiがわかる。
同様に、ATAを計算すると、
A⊤A=(UΣV⊤)⊤UΣV⊤=VΣ⊤U⊤UΣV⊤=VΣ⊤ΣV⊤=VΣn2V⊤
となる。Uが直行行列なのでUTU=Iになることを利用した。
また、∑n2=∑T∑としている。∑n2はn×nの対角行列。
ATAに右からVを掛ければ、
A⊤AV=VΣn2V⊤V=VΣn2
となる。ここでは、Vが直行行列であるとこを利用した。
よって、∑n2の対角がATAの固有値σi2で、Vの列ベクトルが固有ベクトル。
つまり、ATAの固有値と固有ベクトルを解けば、Vとσiがわかる。
以上で、U,Σ,Vが求まるので、m×n行列AをUΣVTに分解することができる。
実際にはAATかATAのどちらか小さい方を使って固有値問題を解く。
その固有値を使ってUとVの固有ベクトルを計算すれば良い。
具体例
画像データ一枚につき10,000の画素データがある。
これを列ベクトルとして、100枚分の画像を 10,000 × 100 の行列Aに入れる。
この場合、AATは 10,000 × 10,000 だが、ATAAは100×100なのでより小さい。
よってATAで固有値問題を解き、UとVの固有ベクトルを計算する。
このようにしてデータから主成分を取り出すことができる。
注意点
自分で計算する際に注意する点がある。
まず、特異値はAATかATAで求めた固有値の平方根であること。
その際に、特異値分解の定義に従って正の平方根を使う。
また、直行行列UとVの列ベクトルは正方行列AATとATAの固有ベクトルである。
直行行列UとVの列ベクトルはAの固有ベクトルではない。
最後に、特有値分解A=UΣVTではVはVTとして使われることを忘れないように。
Numpy
NumpyでSVDをやってみる。
import numpy as np


A = np.array([
    [1, 2],
    [3, 4],
    [5, 6]], dtype=np.float64)

print('A=')
print(A)
print()

U, S, VT = np.linalg.svd(A)

print('U=')
print(U)
print()

print('S=')
print(S)
print()

print('VT')
print(VT)
print()
A=
[[1. 2.]
 [3. 4.]
 [5. 6.]]

U=
[[-0.2298477   0.88346102  0.40824829]
 [-0.52474482  0.24078249 -0.81649658]
 [-0.81964194 -0.40189603  0.40824829]]

S=
[9.52551809 0.51430058]

VT
[[-0.61962948 -0.78489445]
 [-0.78489445  0.61962948]]
Numpyは直接VTを返してくる。また、固有値はベクトル形式。
必要ならば、固有値ベクトルSを特異値分解におけるΣの形式にする。
Σ = np.zeros_like(A, dtype=np.float64)
Σ[:2] = np.diag(S)

print('Σ=')
print(Σ)
print()
Σ=
[[9.52551809 0.        ]
 [0.         0.51430058]
 [0.         0.        ]]
これを使ってA=UΣVTを確認する。
UΣVT=
[[1. 2.]
 [3. 4.]
 [5. 6.]]
行列Aの値が復元されている。
疑似逆行列
正方行列でも逆行列が存在するとは限らないが、正方行列でないと逆行列は存在しない。
疑似逆行列を使うと正方行列でなくとも疑似的な逆行列が使える。
例えば、m×nの行列Aがあるとする。
Ax=y
疑似逆行列A+を使えば、
x=A+y
と変換することができる。
疑似逆行列A+は、
A+=VD+UT
と定義される。VとUは特異点分解A=UΣVTから来ている。
D+はΣを転置して対角成分を全て逆数にしたもの。
m×nの行列Σが以下のように定義されていると、
Σ=σ1σ2⋱σs0⋱0
n×mの行列D+は次のように定義される。
D+=σ11σ21⋱σs10⋱0
ここでD+Σ=Iであることに注目すると、
A+A=(VD+U⊤)(UΣV⊤)=VD+ΣV⊤=VV⊤=I
となる。また、特異値分解の定義から、UとVは直行行列なので、UTU=IとVVT=Iとなることを利用した。
まとめると、
AxA+Axxx=y=A+y=A+y=VD+Ux
つまり、Aの特異値分解をすれば、Aの疑似逆行列としてA+を計算できる。
注意としては、Aがm×n行列ならばA+はn×m行列になること。
Numpy
Numpyで試してみる。
import numpy as np


A = np.array([
    [1, 2],
    [3, 4],
    [5, 6]], dtype=np.float64)

AP = np.linalg.pinv(A)

print('AP @ A')
print(AP @ A)
AP @ A
[[ 1.0000000000000004e+00  0.0000000000000000e+00]
 [-4.4408920985006262e-16  9.9999999999999956e-01]]
対角がほぼ1で、それ以外はほぼ0なのでA+A=Iが成り立っているのがわかる。
関連記事