この記事で扱う分布は、全て有限の事象です。
例えば、コインの裏表とかサイコロの目とかで例えることができる確率の分布。
値が連続ではないので離散分布とも呼ばれる。
その中でも、多項分布が最も包括的な分布。
多項分布がわかると二項分布やカテゴリカル(マルチヌーイ)分布が導き出せる。
さらに二項分布かカテゴリカル分布からベルヌーイ分布も導き出せる。
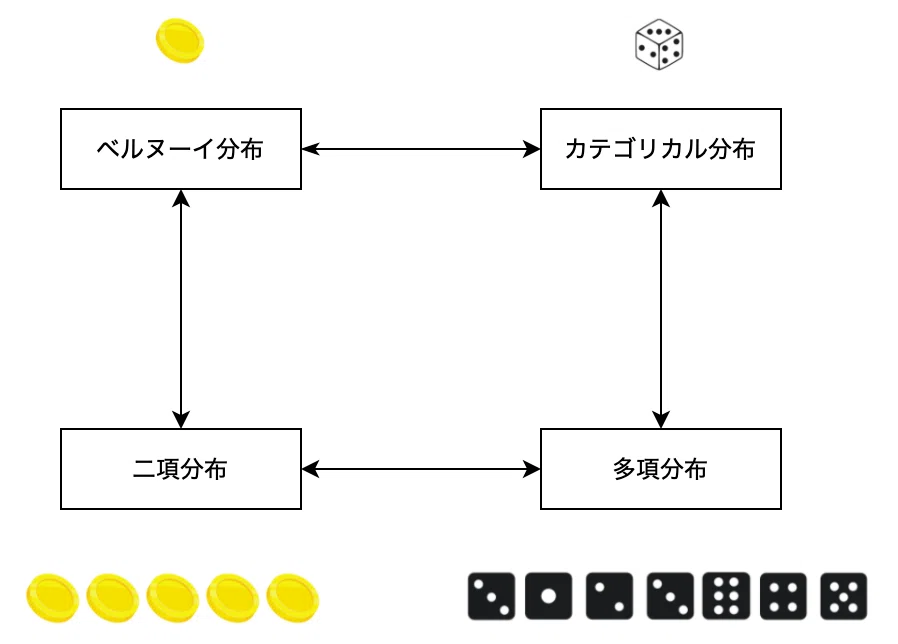
でも、これらを理解するにはベルヌーイ分布から積み上げていった方が分かりやすい。
ベルヌーイ分布
コインを放り投げるとpの確率で表が出るとする。普通はpが50%と仮定するがそれはここでは本題ではない。
コインが表になる確率pを以下のように表現する。表記の仕方は色々あるがこの記事ではこうしている。
Ber(X=1)=p
ここで、X=1は表、X=0は裏としている。それ以外の値はない。
縦に立つかもしれないとか実際にはあり得ても考えない。
 現実には、これも起こりえるが
裏か表しか出ない理想のコインで思考実験していると思って欲しい。
よく、P(X=1)=pと定義されるがPを使うと他の確率と紛らわしいのでBerとして明確に区別した。
また、Berでは一つの確率pが必ず必要なので明記せずに暗黙の了解としている。表記を簡単にするため。
必要ならば、Ber(X=1;p=0.5)などと明示すれば良い。
もちろん、確率ppの値は0≤p≤1の範囲内でなければならない。
なお、Xは確率変数と呼ばれる。確率変数は大文字で書かれることが多いのでここでもそうしている。
「変数」であるが、実際には関数のような動きをする。Xの値はXが従う確率分布からランダムに返される。
可能な値が表(X=1)か裏(X=0)しかないので、裏が出る確率は、
Ber(X=0)=1–p
となる。
ベルヌーイ分布の定義
コイン投げで裏か表かどちらかが出る確率を一つの確率関数にまとめると、
Ber(X=x)=px(1−p)1−x,x∈0,1
となる。X=1とX=0をそれぞれ代入して上述した確率になることを確認して欲しい。
この二者択一の確率分布をベルヌーイ分布(Bernoulli Distribution)と呼ぶ。分布といってもx軸には0か1しかなく、縦軸はpと1−pのみである。
ベルヌーイ分布の期待値
変数Xがベルヌーイ分布に従う時のXの期待値は、
EX∼Ber[X]=x∈{0,1}∑Ber(X=x)⋅x=Ber(X=1)⋅1+Ber(X=0)⋅0=p
EX∼Berとしているのは、期待値を求める確率変数Xがベルヌーイ分布に従うことを意味する。
期待値がpになるとは、コインの例でいえば、コインが表になる確率が期待値になるということ。
直感的な解釈は、「何度も繰り返しコインを投げて表(X=1)と裏(X=0)が出た回数から表が出る回数の平均を計算すると大体pぐらいになる」といった意味。それが確率なのだから身も蓋もないが。
こうなるように裏を0と定義しているとも言える。
ちなみに、EX∼Ber(X)ではなくてEX∼Ber[X]と角括弧を使っているのは、期待値を求める関数Eは入力される確率変数Xが従う分布によって決まることを明示するため。
Xは確率関数に従うので、Eは関数できまる関数になっており、EそのものはXの中身に関わらず共通になる。
よって全ての分布に対して期待値の計算では同じ記号Eを使える。
一般に、期待値は確率分布をPとすると、
EX∼P[X]=x∑P(X=x)⋅x
と書ける。
つまり、関数Eは汎関数(関数の関数)になる。英語では汎関数はfunctionalと呼ばれる。
まあ、これも人によって表記の仕方が違うが、ここではそうしている。
ベルヌーイ分布の分散
確率変数Xが確率分布Pに従うとすると、Xから返される値の分散は、
VX∼P[X]=x∑P(X=x)(x−E[X])2
と書ける。VはVariance(分散)から。
VX∼PでXがPに従うと定義されているので、分散の定義にあるE[X]をわざわざEX∼P[X]とは書かないことにした。これも、明記が必要ならば書き足せばよい。
以上より、確率変数Xがベルヌーイ分布に従う時のXの分散は、
VX∼Ber[X]=x∈{0,1}∑Ber(X=x)(x−E[X])2=Ber(X=1)(1−p)2+Ber(X=0)(0−p)2=p(1−p)2+(1−p)p2=p(1−p)
となる。
コインの例でいうと、分散は表の確率と裏の確率の積になる。
p=0.5だと分散が一番大きい。pで分散を微分して最大値になる値を求めればわかる。
p=1.0かp=0.0だと分散は0になる。毎回同じ結果になるから。
ベルヌーイ分布は非常に簡単だがよく出てくる。後で紹介する「独立」など確率の基本概念が詰まっている。
また、二項分布の期待値や分散の計算で役に立つ。
二項分布
二項分布はベルヌーイ分布に従う試行をn回繰り返した場合にX=1となる回数の確率分布。
例えば、表が出る確率pのコインを3回放り投げて表が2回出る確率を求めたいとすると、
の3パターンがある。
同じことをX=1とX=0で表現すると、
表表裏: X=1, X=1, X=0
表裏表: X=1, X=0, X=1
裏表表: X=0, X=1, X=1
となる。この3つの組合せからどれか一つが起これば良い。
例えば、表表裏が起こる確率は、X=1の確率と X=1の確率とX=0の確率を掛け合わせれば良いので、Ber(X=1)Ber(X=1)Ber(X=0)になる。
よって、表が出る確率pのコインを3回放り投げて表が2回出る確率は、上記3つのパターンの確率を足し合わせればよく、
Ber(X=1)Ber(X=1)Ber(X=0)Ber(X=1)Ber(X=0)Ber(X=1)Ber(X=0)Ber(X=1)Ber(X=1) + +=p2(1−p)+p(1−p)p+(1−p)p2=3p2(1−p)
となる。
ベルヌーイ試行の独立性と同一性
あるベルヌーイ試行はその後のベルヌーイ試行に影響しない。
だからベルヌーイ試行を繰り返すことによって起こる事象の確率は、それぞれの事象が起こる確率を単純に掛け算したものになる。
このような性質を確率分布の独立性と呼ぶ。
将来、条件付き確率が出てくると独立の概念があやふやになりがちなので忘れないでほしい。
また、ベルヌーイ試行は毎回同じ分布に従う。途中でpが変わったりしない。この性質を同一と呼ぶ。
まとめるとベルヌーイ試行は何回行っても毎回独立で同一。
このような分布を独立同一分布(independent and identically distributed、i.i.d.)と呼ぶ。
独立同分布とも呼ばれる。
この記事に出てくる分布は全て独立同一分布。
実は、ベルヌーイ試行が独立同一なので、表と裏がどんな順番で現れても、表が2回、裏が1回になる確率は同じ。あとは、組み合わせの数だけその確率を足せば良い。
二項分布の定義
一般に、確率pのベルヌーイ試行をn回繰り返してm回のX=1が生じる確率は、
Bin(n,m)=nCmpm(1−p)n−m=(mn) pm(1−p)n−m
となる。BinはBinomial Distribution(二項分布)の略称。
組合せと順列
ちなみに、nからm選ぶ組合せnCmの計算は、
nCm=(mn)=m!(n−m)!n!
そして、順列n! の計算は、
n!=n⋅(n−1)⋅(n−2)⋯⋅2⋅1
簡単な具体例で見ていこう。a、b、cの3つの事象を順番に並べるときに、まず、最初の事象を3つから1つ選ぶ、2番目の文字は残りの2つから選ぶ、最後は残りの1つを選ぶ。よって、
3!=3⋅2⋅1=6
となり6つの順番のパターンがある。
abcacbbacbcacabcba
ここで、aとbが同じものだとしたら、aとbの順番は関係なくなるので、b=aとして、
aacacaaacacacaacaa
となり、3つのパターン aac, aca, caa しかないことになる。
独立同一の試行では事象が生じる順番は関係なく、ある事情が起こる回数だけが重要なので組み合わせを使って考える。
例えば、3回のベルヌーイ試行でX=1が2回出る組み合わせを考えよう。
事象をa=1, b=1, c=0と考えると、abcの順列は6パターンあるが、aとbは同じなので、その順番を無視する必要がある。また、残りの事象(ここではcひとつしかないが)の順番も無視する。
具体的に言うと、abcとbacは用法とも110なので一つの事象として数える。結局のところ、3つのパターン(110, 101, 011)しかない。
つまり、組み合わせの数式を確率の計算で使うのは、独立で同一な試行では順番を無視することができることを利用している。
数式で見ると、3つ事象の順列から、同一事象2つの順番を無視して、さらに選ばれなかった残りの事象の順番も無視するという作業をしているのがわかる。
3つのものから2つを選ぶ組み合わせ=(選んだ2つの順列)⋅(残り1つの順列)(3つのものの順列)=2!1!3!=26=3
もう一度、nからm選ぶ組合せnCmの計算は、
nCm=(mn)=m!(n−m)!n!
分母では、m!で選んだものの順番を無視して、(n-m)!は残りものの順番を無視している。これを覚えておくと丸暗記しなくともよくなる。
二項分布の期待値
二項分布の期待値の計算は、確率に組合せが入っており一見複雑で面倒になりそうだが、実はそうでもない。
ベルヌーイ試行をn回繰り返しただけなので、n個の確率変数X1,X2,…,Xnが全てベルヌーイ分布に従っているとし、確率変数X=X1+X2+⋯+Xnの期待値を計算する。
EX∼Bin[X]=EX1∼Ber, X2∼Ber, … , Xn∼Ber[X1+X2+⋯+Xn]=EX1∼Ber[X1]+EX2∼Ber[X2]+⋯+EXn∼Ber[Xn]=n⋅EX∼Ber[X]=np
それぞれの確率変数Xiはベルヌーイ試行に従い独立同一なので、期待値を別々に計算して総和を取っている。
よって、二項分布の期待値はベルヌーイ分布の期待値のn倍になっている。
独立同一分布であるベルヌーイ試行をn回実行しただけなので当然でもある。
もちろん、n=1だとベルヌーイ分布と同じ。
二項分布の分散
二項分布に従う確率変数Xの分散は、
VX∼Bin[X]=VX1∼Ber, X2∼Ber, … , Xn∼Ber[X1+X2+⋯+Xn]=VX1∼Ber[X1]+VX2∼Ber[X2]+⋯+VXn∼Ber[Xn]=n⋅VX∼Ber[X]=np(1−p)
ここでもベルヌーイ試行が独立同一なことが役に立っている。よって、二項分布の分散はベルヌーイ分布の分散のn倍になっている。言うまでもないが、n=1だとベルヌーイ分布と同じ。
カテゴリカル分布
ベルヌーイ分布はバイナリの変数(裏表、0か1)の確率分布を扱ったが、カテゴリカル分布は変数が3つ以上のカテゴリに分かれる場合の確率分布。マルチヌーイ分布とも呼ぶ。
ジャンケン
例として、ジャンケンの相手がグー・チョキ・パーのどれを出してくるかの確率を考える。
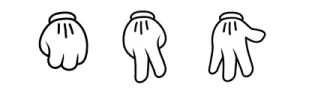
グー・チョキ・パーのそれぞれ31の確率と言いたいところだが、人それぞれの癖があるのでそうとも限らない。
グーが出る確率をpグー、チョキが出る確率はpチョキ、パーが出る確率はpパーとする。
なお、これらの確率は固定されており、変化しないと仮定している。
現実の世界では人間は相手の出しそうな手を予測したりするので確率分布が固定されているとは限らない。
よって分布の同一性を仮定するのは理想的な想定となる。
さらに、毎回の事象は独立と仮定する。人間には色々な思惑や癖がある。相手が3回もチョキを出した後にまたチョキを出さないだろうとか。自分は常に手を変えるようにしているとか。よって独立性を仮定するのもまた理想的な想定になる。
要するに、ランダムにグー・チョキ・パーを出してくる理想のロボットで思考実験をしていることになる。
よって、ジャンケンの相手の手が従う確率分布は独立同一分布になる。
また、一度に出るのはグー・チョキ・パーのどれか一つだけ。よって確率の合計は1になる。
k∈{グー,チョキ,パー}∑3pk=1
どれか一つだけになる性質を排他的と呼ぶ。グー・チョキ・パーやサイコロの目などは排他的事象。
言及しなかったが、もちろんコインの裏表も排他的事象。
量子力学ではないので裏と表が同時に出現するとかは言わない。
排他的な事象は、ベクトルを使って表現できる。
グー・チョキ・パーのそれぞれの事象を3次元のベクトルxグー,xチョキ,xパーで、
xグーxチョキxパー=(1,0,0)=(0,1,0)=(0,0,1)
と表現することができる。
ベクトルの要素の一つだけが1で他は0にすることで事象を完全に区別している。
機械学習でよく出てくるone-hotエンコーディングと同じ考えだ。
x=(x1,x2,x3), xi∈{0,1} where k=1∑3xk=1
以上の表記を使って、グー・チョキ・パーの出る確率は、
Cat(X=x)=pグーx1⋅pチョキx2⋅pパーx3
と書ける。CatはCategoricalの略。
グーの時はxグー=(1,0,0)なのでx1=1,x2=0,x3=0となり、
Cat(X=xグー)=pグーx1⋅pチョキx2⋅pパーx3=pグー1⋅pチョキ0⋅pパー0=pグー
が成立する。
ゴチャゴチャしてきたので、グー・チョキ・パーを1,2,3に置き換える。
Cat(X=x)=p1x1⋅p2x2⋅p3x3where x=(x1,x2,x3)
これで3つのカテゴリがある一般の確率として扱える。もうグー・チョキ・パーは忘れよう。
実際には、3つの内の1つは他の2つが決まると定まる。なぜなら、i=1∑3pi=1なので。
繰り返すが、それぞれのカテゴリに対して1回の事象が起こる確率が固定されていると想定している。よって、上式が成り立つ。例えば、カテゴリ1が出る確率は、
Cat(X=x1)=p11⋅p20⋅p30=p1
となる。カテゴリ2が出る確率についても同様に一意に決まる。そして、残りがカテゴリ3の確率になる。
また、ベクトルの要素の数だけ確率があるのでp1,p2,p3などをCatの入力値としてわざわざ明記していない。
必要な時に明示すれば良い。例えば、
Cat(X=x;p=(0.2,0.3,0.5))=0.2x1⋅0.3x2⋅0.5x3
表記の仕方は色々あるので、状況に合わせればよい。
サイコロ
もう一例として、サイコロを取り上げる。一度の試行で1から6までの数字のどれかが出る。
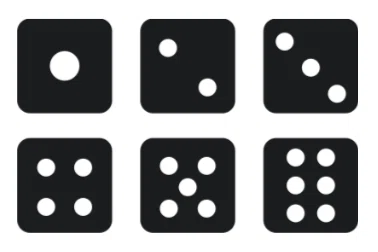
通常は、サイコロの数字はそれぞれ61の確率で出ると想定するが、異なる確率を考えることもできる。
壊れているサイコロやイカサマのサイコロとか。
よって、それぞれの目の出る確率をp1,p2,p3,p4,p5,p6とする。
もちろん、確率の合計は1にならないとおかしいので、以下の関係を前提とする。
k=1∑6pk=1
また、1度に出るサイコロの目は1つだけ。例えば、1と6の目が同時に出ることはない。つまり排他的。
サイコロの目をx=(x1,x2,x3,x4,x5,x6)と6次元のベクトルで表現する。
ただし、x1からx6のどれか一つだけ1で他は0とする。つまり、one-hotエンコーディング。
サイコロでは1から6の数値が出るが、カテゴリカル分布を考えるときにはその数値的な意味(順序など)は考えない。あくまでも6つに分類される各事象が起こる確率を捉えるだけ。
例えば、サイコロを振って1の目が出る事象はx1=(1,0,0,0,0,0)となる。
よって、サイコロを振って1の目が出る確率は、
Cat(X=x1)=p11⋅p20⋅p30⋅p40⋅p50⋅p60=p1
グー・チョキ・パーの時と同様に、サイコロの目のどれかが出る確率は、
Cat(X=x)=p1x1⋅p2x2⋅p3x3⋅p4x4⋅p5x5⋅p6x6
と書ける。カテゴリの数が3から6に増えただけ。
でも長いので、同じことを下記のようにまとめて表記することができる。
Cat(X=x)=k=1∏6pkxk
k=1∏Kはk=1からk=Kの項を全て掛け合わせることを意味する。
具体的に、サイコロで目が2の場合で計算してみよう。
x2=(x1,x2,x3,x4,x5,x6)=(0, 1, 0, 0, 0, 0)
カテゴリカル分布の確率の式に当てはめると、
Cat(X=x2)=k=1∏6pkxk=p1x1⋅p2x2⋅p3x3⋅p4x4⋅p5x5⋅p6x6=p10⋅ p21⋅ p30⋅ p40⋅ p50⋅ p60=p2
3とか他の数字でも同様に確認できるはず。
カテゴリカル分布の定義
以上をまとめると、一般にカテゴリカル分布に従うK次元変数Xの確率は、
Cat(X=x)=k=1∏Kpkxk
「サイコロ如きに大袈裟な」と時々ふと思う。(個人の感想です)
カテゴリカル分布でK=2のケースは、分類する数が2つなのでベルヌーイ分布になる。
だったらベルヌーイ試行は2次元の変数なのでは思われた方は鋭い。確かにベルヌーイ試行は2次元の変数としても扱える。
その場合、表がx=(1,0)で裏がx=(0,1)となる。
Cat(X=x)=k=1∏2pkxk=p1x1p2x2p1+p2=1,x1,x2∈{0,1} where x1+x2=1
ただし、p2=1–p1なので、p1=pとするとp2=1–pとなる。また、x1=xとすると、x2=1–xなので、
Cat(X=x)=p1x1p2x2=px(1−p)1−x=Ber(X=x),x∈{0,1}
となり、ベルヌーイ分布に等しい。
確率変数Xが返す値がスカラー(x=0とx=1)になり、同じ内容をより簡単に表現できる。
だから、ベルヌーイ分布から話を始めた方が分かりやすい。
カテゴリカル分布の期待値と分散
カテゴリカル分布では、分類された事象のそれぞれが起こる確率を考えており、確率変数Xのベクトル値には数値的な意味がないので、平均や分散というものを考えない。(問題の設定の仕方にもよるが)
分類された各事象が起こる確率がpkなので、その他の事象が起こる確率は1−pkとなり、各事象ごとに確率がpkのベルヌーイ分布になっている。よって、事象ごとの期待値はpkで分散はpk(1−pk)になる。
多項分布
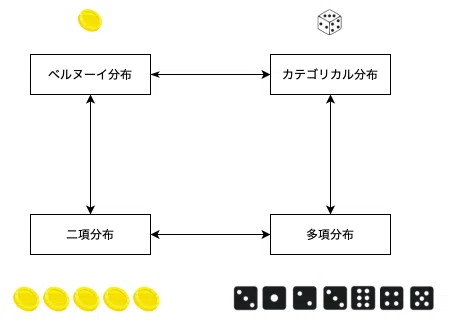
ついにラスボスの登場だ。こいつを打倒すれば天下り的にこれまでの分布も説明できる賢者になれる。
多項分布はカテゴリカル分布に従う試行をn回行なったもの。
n=1ならば、カテゴリカル分布と同じで、各要素は確率piのベルヌーイ分布に従う。
また、多項分布は二項分布を多項に拡張したものとも考えられる。
二項分布ではn回の試行でX=1がm回起こる確率を考えた。
Bin(n,m)=nCmpm(1−p)n−m=(mn)pm(1−p)n−m
多項分布では、X=(x1,x2,…,xK)の各事象がそれぞれm1回、m2回、…、mK回起きる確率を考える。
サイコロ
例えば、サイコロを10回振って、
1の目が1回(m1=1)2の目が3回(m2=3)3の目が2回(m3=2)4の目が1回(m4=1)5の目が2回(m5=2)6の目が1回(m6=1)
が出る確率を計算する。
また、当然だが、
k=1∑6mk=10
となる必要がある。
上記のパターンが出る組み合わせは、
m1!m2!m3!m4!m5!m6!n!=1!3!2!1!2!1!10!=302,400
だけあり、そのうちの一つが出る確率は、
p1m1⋅p2m2⋅p3m3⋅p4m4⋅p5m5⋅p6m6=p11⋅p23⋅p32⋅p41⋅p52⋅p61
となる。
仮に、p1=p2=p3=p4=p5=p6=61とすると、合計の確率は、
302,400×(61)10=0.005001143118427
となる。約0.5%といったところか。
多項分布の定義
一般に、m個のカテゴリがある独立同一試行をn回行う多項分布は次のように表記できる。
Mul(n,m)=m1!…mK!n!k=1∏Kpkmk,m=(m1,m2,…,mK)
MulはMultinomial distribution(多項分布)の略。
また、以下の条件が満たされる必要がある。
k=1∑Kpk=1 k=1∑Kmk=n,0≤mk≤n
二項分布の再定義
多項分布でK=2とすると、
Mul(n,m=(m1,m2)) =m1!m2!n!k=1∏2pkmk=m!(n−m)!n!p1mp2n−m// m1=m, m2=n−m=nCmpm(1−p)n−m // p1=p, p2=1−p=Bin(n,m)
となり、二項分布が導かれる。
カテゴリカル分布の再定義
多項分布でn=1とすると、一回の試行しかなくmがK次元のone-hotエンコーディングと同じになる。
m=(m1,…,mK), k=1∑Kmk=n=1, mk∈{0,1}
よって、
Mul(n=1,m)=m1!…mK!n!k=1∏Kpkmk=k=1∏Kpkmk=Cat(X=m)
となり、カテゴリカル分布が導かれる。
関連記事