前回は、ポリシー勾配法を理論的な側面から解説しました。今回はポリシー勾配法の具体例の一つであるREINFORCEを紹介します。
REINFORCEでは、エージェントが行動を選び、その結果得られる報酬を使って行動の確率を更新します。このアプローチは、生涯報酬(割引報酬の和)が多くなる行動がより高い確率で選ばれるようにポリシーを調整するので、徐々に最適な行動を見つけることができます。
しかし、REINFORCEは報酬のばらつきが大きいと非効率な場合があります。それでも、この手法は理論的には任意の報酬関数とポリシーに対して有効であり、多くの問題で適用が可能です。
では、さっそく始めましょう。
ポリシー勾配定理のおさらい
前回紹介したポリシー勾配定理は、目的関数J(θ)の勾配∇θJ(θ)と行動選択の対数確率logπθ(at∣st)の勾配∇θlogπθ(at∣st)とを結びつけるものでした。
∇θJ(θ)=Eτ∼πθ[(t=0∑T−1∇θlogπθ(at∣st))g(τ)]
これによって行動選択をうまく調節することで目的関数を最大化できるという関係が示されました。また、生涯報酬g(τ)は、トラジェクトリτから、次のように計算できます。
g(τ)=r1+γr2+γ2r3+⋯+γT−1rT
γは割引率です。報酬ri(i=1,…,T)は、環境が持つ報酬関数から与えられます。それは、各状態においてポリシーが選択した行動に依存します。もちろん、ランダム性が含まれる場合もあります。
上述の2つの式から分かることは、理論的にはポリシー勾配定理は、任意の報酬関数とポリシーに対して有効であり、多くの問題で適用が可能です。
しかし、実際にポリシー勾配定理を実践するには、具体的にはどうしたら良いでしょうか。
この問いに答える一つの手法が今回紹介するREINFORCEになります。
REINFORCE(REward Increment = Nonnegative Factor X Offset Reinforcement X Characteristic Eligibility)は、ポリシー勾配定理を基にした強化学習アルゴリズムの一つです。このアルゴリズムは、エージェントが環境内で行動を選択し、その行動がもたらす報酬をもとにポリシー(行動選択の確率分布)を更新します。
ポリシー勾配定理をそのまま実装すると学習の効率が悪くなるので、幾つかの点においてアプローチを修正しています。
マルコフ性と行動選択の評価
ポリシー勾配定理では、トラジェクトリ全体(エピソードの最初から最後までの経験)から得られる生涯報酬を勾配の計算に使っています。これは、エージェントがエピソード全体でどれだけ良いパフォーマンスを示したかを評価するためであり、マルコフ性とも矛盾しません。
しかし、エピソードの最初ではなく、途中のステップからの最適な行動選択を評価するとしたらどうでしょうか。つまり、あるエピソードの途中のステップtからエピソードの終了までの部分トラジェクトリτtを考えてもポリシー勾配定理は成り立つはずです。
また、このように考えられるのはマルコフ性のおかげです。なぜなら、マルコフ性の前提においては、状態stにおける行動atの選択の確率はそれより前の状態には依存しないからです。よって、過去に得た報酬を行動の評価に加える必要はありません。
そこで、各ステップtにおいて次のように分解して考えます。
行動選択atの対数確率logπθ(at∣st)とその勾配∇θlogπθ(at∣st)
ステップtからエピソード終了までの部分トラジェクトリτt
部分トラジェクトリτtからの生涯報酬g(τt)
以上より、各部分トラジェクトリτtから目的関数に貢献する値を計算します。
∇θlogπθ(at∣st)g(τt)
これをすべてのステップに対して計算し合計したものを目的関数の勾配として使います。
∇θJ(θ)= Eτ∼πθ[t=0∑T−1 ∇θlogπθ(at∣st)g(τt)]
これとポリシー勾配定理の式との違いは、報酬の総和をトラジェクトリ全体からのg(τ)としているか、部分トラジェクトリからのg(τt)としているかだけです。各ステップにおける行動選択の最適化は、その行動以後の総報酬から評価されるべきなので、過去の報酬を含めないことは、ある意味より正当な評価と言えます。
簡単にまとめると、ポリシー勾配定理における行動評価にマルコフ性を適用し、各ステップでの行動選択がその後の生涯報酬で評価されるようになりました。これによって、行動の「良さ」をより正確に測定できるので、ポリシーの学習効率が上がる可能性があります。
モンテカルロ法の導入
ポリシー勾配定理では、目的関数の勾配は、さまざまなトラジェクトリから計算して得られる値の期待値として定義されています。しかし、このやり方だと多くのサンプルを集めるまでは、ポリシーのパラメータの更新が行えません。つまり、学習としての効率が悪くなります。
そこで、REINFORCEでは、モンテカルロ法をポリシー勾配法に導入しました。モンテカルロ方法は、確率的なプロセス(例えば、環境との相互作用)からサンプルを取ることを繰り返して、近似的な解を求めるテクニックの一般名称です。
よって、REINFORCEは、エピソード終了ごとに、目的関数の勾配を推定します。
∇θJ(θ)≈t=0∑T−1 ∇θlogπθ(at∣st)g(τt)
一つのエピソードから計算した目的関数の勾配を使うことで学習の効率を改善しています。
具体的には次のようなステップに従って処理を行います。
現在のポリシーを使って環境から経験(状態、行動、報酬)を集める
エピソード終了後に、目的関数の勾配を計算(推定)する
ポリシーのパラメータを更新する
次のエピソードを開始し、ステップ1へ戻る
次に、目的関数の勾配の計算をどのように行うのかを解説します。
エピソードごとの勾配の計算
REINFORCEでは、効率よく勾配の計算するためにトラジェクトリを逆方向に辿りながら計算します。
例えば、エピソードが状態sTで終了したとします。すると、その一つ手前のステップからのトラジェクトリを考えることができます。
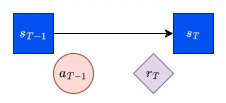
このトラジェクトリをτT−1と呼びましょう。トラジェクトリτT−1の中身は、τT−1=(sT−1,aT−1,sT)です。また、トラジェクトリτT−1からの生涯報酬は以下になります。
g(τT−1)=rT
次に、もう一つ手前のステップT−2からのトラジェクトリを考えます。このトラジェクトリをτT−2と呼びましょう。トラジェクトリτT−2の中身は、τT−2=(sT−2,aT−2,sT−1,aT−1,sT)です。
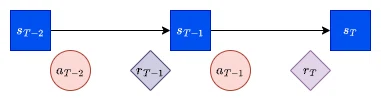
また、トラジェクトリτT−2からの生涯報酬は以下になります。
g(τT−2)=rT−1+γrT
これを次のように表現することもできます。
g(τT−2)=rT−1+ γg(τT−1)
よって、ステップT−2からの生涯報酬g(τT−2)は、状態sT−2における行動aT−2から得た報酬rT−1と、ステップT−1からの生涯報酬g(τT−1)をγで割引したものを足したものに等しくなっています。
より一般的に、次のように表現できます。
g(τt)=rt+1+ γg(τt+1)
この関係を使うと各ステップtからの生涯報酬g(τt)の計算が効率的に行えます。つまり、トラジェクトリをτT−1,τT−2,…,τ1,τ0と逆方向に辿りながら、各ステップtからの生涯報酬g(τT−1),g(τT−2),…,g(τ1),g(τ0)を次のように計算できます。
g(τT−1)g(τT−2)⋮g(τ1)g(τ0)=rT=rT−1+ γg(τT−1)=r2+ γg(τ2)=r1+ γg(τ1)
各ステップにおける行動選択による目的関数の勾配への貢献の総和が目的関数の勾配の推定となります。
∇θJ(θ)≈t=0∑T−1 ∇θlogπθ(at∣st)g(τt)
なお、対数確率logπθ(at∣st)は、ポリシー・ネットワークが選択した行動に対する確率を返すように実装し、その対数を計算するだけです。さらにその勾配はPyTorchなどで誤差逆伝播法を使えば自動的に計算されます。
よって、以上からエピソード終了ごとにポリシーの勾配を計算しポリシーのパラメータの更新を行うことが可能となります。
REINFORCEの基本的な考え方は以上となります。
この手法では、エピソードからの部分トラジェクトリを使うことで効率的に目的関数の勾配に貢献する値を計算することができます。また、数学的な期待値を直接計算する代わりに、サンプリングによって勾配の推定を行っています。これらの勾配の推定値を用いてパラメータの更新を行うことで、ポリシーを逐次的に改善していきます。よって、ポリシー勾配定理の理論的な背景にある程度忠実でありながらも学習効率の良い現実的なアプローチを可能にしています。
ベースラインによる分散低減
モンテカルロ法は確率的なサンプリングに依存しているため、得られる生涯報酬の分散が高くなりがちです。目的関数の勾配が大きく上下する可能性があり、REINFORCEの学習効率に悪い影響を与える可能性があります。
分散を低減する一つの効果的な方法は、生涯報酬のベースラインを導入することです。ベースラインとしての必要条件は、行動atに依存しない関数であることです。
具体的には、各ステップtでの生涯報酬g(τt)から、行動atに依存しない関数bを差し引きます。
∇θJ(θ)=Eτ∼πθ[t=0∑T−1∇θlogπθ(at∣st)(g(τ) −b)]
このように変更しても目的関数の勾配には影響しません。これは期待値の計算の中身を展開すると理解できます。
あるステップtにおける計算だけに注目してベースラインの期待値を展開します。
a∑πθ(at∣st)∇logπθ(at∣st)b
つまり、ある状態stにおいての全ての可能な行動に対して対数行動確率の勾配∇logπθ(at∣st)を計算し、各行動の確率πθ(at∣st)を重みとして加重平均を計算しています。
これに対数の微分の公式(∇logf=f∇f)を当てはめます。
a∑πθ(at∣st)πθ(at∣st)∇πθ(at∣st)b= a∑(∇πθ(at∣st))b
ここで、bは、atに依存しないので前に出します。
a∑(∇πθ(at∣st))b= ba∑∇πθ(at∣st)
微分の和は、和の微分であることを利用して式を書き直します。
ba∑∇πθ(at∣st)= b∇a∑πθ(at∣st)
a∑πθ(at∣st)=1なので、その勾配はゼロです。
b∇a∑πθ(at∣st)= b∇1=0
以上より、ベースラインによる目的関数の勾配への影響はゼロです。
ただし、ベースラインを使うだけでは、生涯報酬の分散を低減できるとは限りません。そのためには、生涯報酬g(τ)からベースラインを差し引くことで、その絶対値が小さくなるようなベースラインを選ぶことが必要です。
うまくベースラインを選べば、目的関数の勾配の期待値を変えることなく分散だけが低減し、学習がより効率的に行えるようになるのが理論的にわかりました。
では、REINFORCEでベースラインを適用してみます。ポリシーが予測する状態価値関数vπθ(st)をベースラインとして使うことが効果的であることが知られています。
∇θJ(θ)≈t=0∑T−1 ∇θlogπθ(at∣st)(g(τt)−vπθ(st))
このベースラインは状態stのみに依存し、行動atに依存しないのでベースラインの条件を満たしています。また、状態価値関数は、ある状態からの生涯報酬の期待値なので、g(τt)と値が近く分散を低減できることが期待されます。
ここで、g(τt)−vπθ(st)は、ある行動を選ぶことによるアドバンテージを計算しているのと同じです。なぜなら、g(τt)ある行動に従ったことによるトラジェクトリからの生涯報酬です。そして、vπθ(st)は、状態価値(その状態における行動確率分布による行動価値の期待値)だからです。
つまり、Dueling DQNで使われたアドバンテージのようにどの行動を選ぶべきかを学ぶ手助けをしていると捉えることもできます。
行動のアドバンテージが勾配の計算に影響するので、ポリシーの最適化によりどの行動を選ぶべきかの学習がより効率的になることが期待されます。
次回予告
次回は、REINFORCEの実装を行い簡単な実験をします。
お楽しみに!
(続く)



