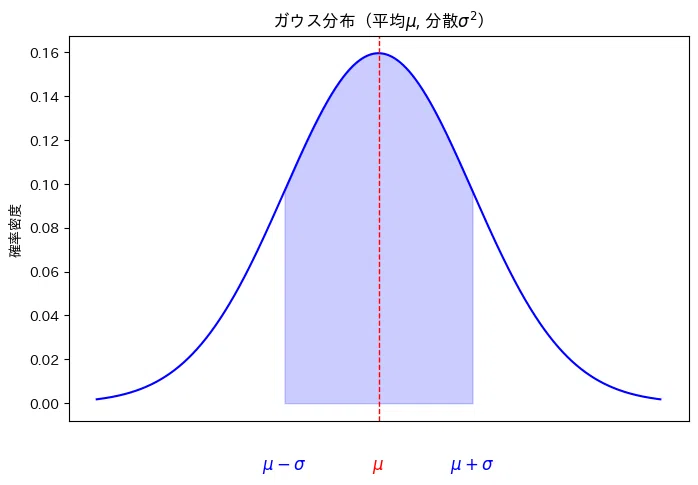
正規分布(ガウス分布)は、確率論や統計学において最も重要な分布の一つです。多くの自然現象や測定値がこの分布を使ってモデリングされています。
この分布の形状は釣鐘型で、中心付近にデータが集中し、平均値μを中心に左右対称となっています。また、分布の広がりは標準偏差σによって決まります。
しかし、こんな疑問を思ったことはありませんか?
なぜ正規分布がよく使われるのか
そもそもどうやって導出できるのか
指数関数を含むのはなぜか
この記事では、これらの質問に答えていきます。
正規分布がどのように導出されるか、またその背後にある数学的な理由について考えるには、まず「情報エントロピー」「ラグランジュ未定乗数法」「オイラー・ラグランジュ方程式」などの数学的手法が関わってきます。これらの概念について詳しくは、以下の記事を参照してください。
最大エントロピー原理
「エントロピー」という言葉は、一般的に無秩序や不確実性を意味します。情報理論において「情報の不確実性」を示す重要な概念です。
エントロピーという名前は、熱力学、統計力学、情報理論で使われ、それぞれの文脈で異なる意味を持ちますが、根底にある「乱雑さ」や「不確実性」の概念は共通しています。歴史的には、1865年にクラウジウスが熱力学でエントロピーを導入し、ボルツマンが統計力学で再解釈、1948年にシャノンが情報の不確実性を測る尺度として情報エントロピーを定義しました。
参考:https://ja.wikipedia.org/wiki/エントロピー最大エントロピー原理とは、与えられた情報や制約だけを基に(余計な仮定を加えずに)確率分布を選ぶべきだという考え方です。これについて直感的に考えるために天気の予測を例として取り上げましょう。
知らない場所の天気を予測
ある場所の天気が良いかどうかを予測したいとします。しかし、その場所に関する情報は一切ありません。日本なのか、米国なのか、はるか遠くの銀河の惑星なのかはわかりません。そんな状況で、「晴れの確率」を予測する天気予報モデルをどのように考え出せばよいでしょうか。
その場所についての情報がなく、ましてやそこでの天気について何も知らないからといって、モデルにバイアスや余計な仮定を持ち込みたくありません。知らないことは知らないと、正直になりたいとします。
つまり、このモデルは天気についてまったく無知であるという事実を反映する必要があります。では、どのような確率分布を使用すればよいでしょうか。
正規分布を使用すべきでしょうか?
しかし、天気に関しての平均も標準偏差もわからないので、正規分布を使用することはできません。
何も知らないので、ランダムに推測することしかできません。それは、コインを投げて「晴れる」「晴れない」のいずれかが出るようなものです。
つまり、一様分布です。
このように、全く情報がない状態では、一様分布が最も妥当な選択になります。この場合、「晴れる確率」と「晴れない確率」が等しくなります。どちらに対しても情報がないので、優劣をつけることができないからです。
知っている情報と確率分布
完全に無知であることを表明して正直さを保つためだとしても、コインを投げて天気を予測する方法では、役に立つモデルにはなりません。したがって、天気に関する何らかの情報が必要です。
たとえば、気温の平均と標準偏差がわかっている場合は、正規分布を使用できます。これは一様分布によるランダムな推測よりも有用でしょう。また、正規分布を使用するということは、天気に関して何らかの情報がある(完全に無知ではない)ことを前提にしているのとも言えます。
さらに、正規分布を使うことは、平均と標準偏差以外の情報は知らない(使っていない)ことにもなります。無知のレベルが変わったわけです。つまり、確率分布には、我々が「何を知っているのか(何を知らないのか)」が反映されています。
もし、知らない情報を必要とする確率分布を使っていたら、それは不誠実になるので避けるべきです。数学的に「知らないこと」を排除する必要があります。
では、「知っている情報だけ」から「誠実な確率分布」を数学的に導き出すことは可能でしょうか。バイアスを持ち込まないためにはどうすれば良いのでしょうか。
ここで、エントロピーを最大化するという概念が役に立ちます。
エントロピーを最大化する
バイアスを持ち込まないというアプローチは、エントロピーを最大化することと関係します。
例えば、一様分布は起こり得る事象が完全に不確実な分布です。つまり、エントロピーは最大化されています。唯一の制約は、確率分布の総和が1ことだけです。
正規分布の場合は、さらに平均と分散が指定された値になるという制約条件の基にエントロピーを最大化します。これによって、正規分布があのような形になることが自然と導かれます。
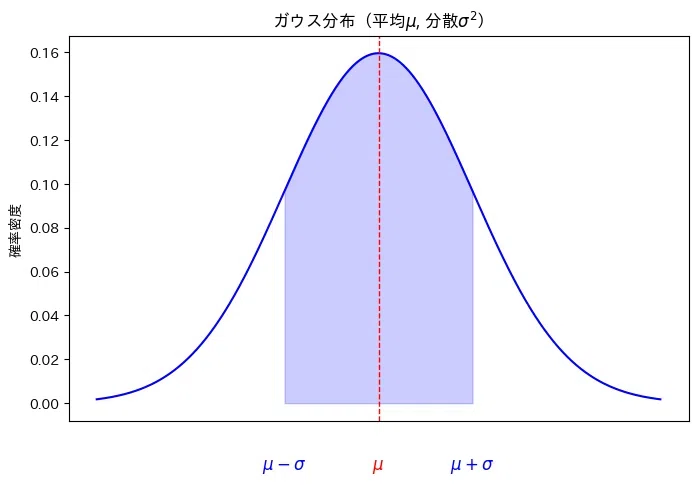
つまり、正規分布は「平均と分散のみが分かっており、それ以外の仮定や主観を持ち込まない」結果として出現するわけです。
このように制約条件付きでエントロピーを最大化して確率分布を求める手法を最大エントロピー原理と呼びます。この手法では、既知の情報(例: 平均や分散)を織り込みつつ、余分な情報やバイアスを持ち込みません。
繰り返しますが、正規分布によるモデル化は、「データの平均と分散以外は何も知らない、あるいは何も仮定しない」という姿勢をとることを意味します。あるいは、「平均と分散以外のバイアスを一切導入しない」という正直な立場をとっているとも言えます。最大エントロピー原理によって、数学的にこのような姿勢や立場が表現されます。
正規分布が使われる理由
中心極限定理と独立試行
正規分布が使われる理由の一つとして中心極限定理があります。この定理は、たくさんの独立した確率変数を足し合わせると、その和は正規分布に近づくというものです。
例えば、サイコロを一回振ると、出る目は1から6までのいずれかで、それぞれの目がでる確率は1/6です。この分布は一様分布であり、ガウス分布とは全く異なる形をしています。しかし、複数のサイコロを振り、その平均をとることを繰り返すと、その分布は一様分布から離れ、徐々に山型の形(正規分布)に近づいていきます。
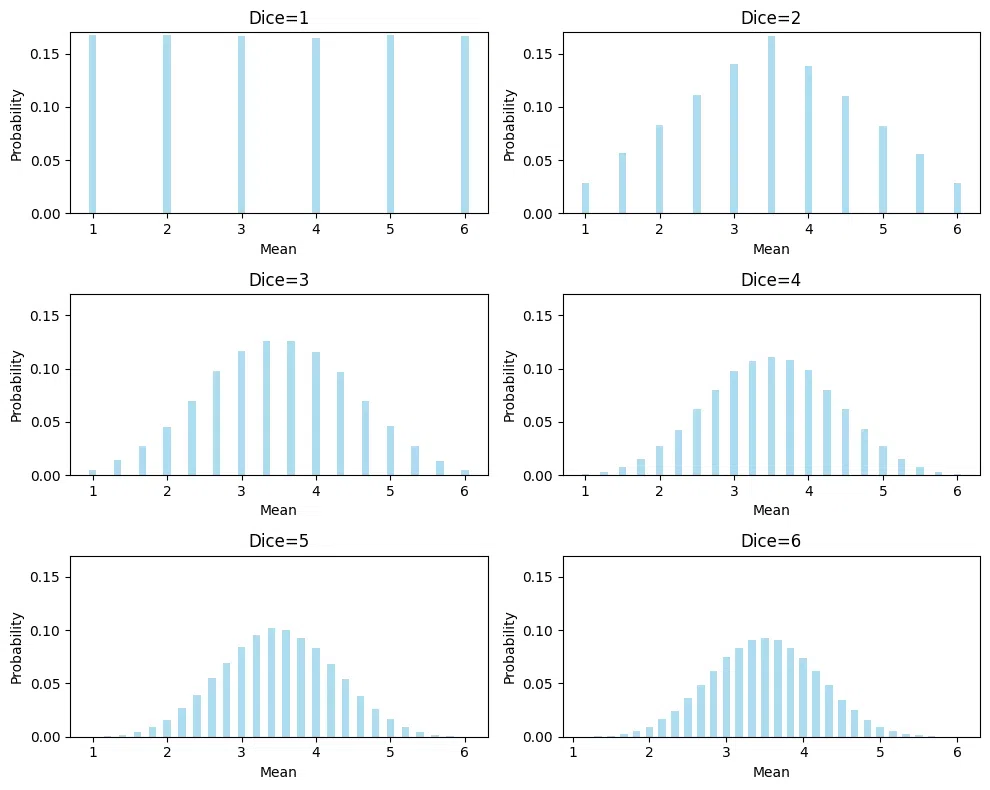 平均をとるサイコロ(Dice)の数と分布の形状の関係(10万回の試行)
こうした現象は、測定誤差やその他の複雑な要因から生じる事象でも、たくさんの測定をして分布を確認することで正規分布に近似できるということを示しています。つまり、十分な数の独立した確率変数の和が正規分布に収束するというのが中心極限定理の要点です。
十分な数の独立した同一分布の確率変数の和が正規分布に収束するというのは、最大エントロピー的な見方をすると、平均と分散以外は「無秩序」または「不確実」な分布になるということです。
一方、最大エントロピー原理による正規分布の導出では、与えられた制約条件(平均と分散)を満たす確率分布を選ぶ際に、エントロピーを最大化して最も「無秩序」または「不確実」な分布を選んでいます。これは、平均と分散が決まっているなら、それ以外の情報を仮定せず、最も広範な不確実性を許容する分布として正規分布が選ばれる、ということです。
つまり、サイコロの試行も、この最大エントロピー原理の結果として理解できます。サイコロを複数回振ってその平均をとることで、個々の結果が持つ不確実性が平均化され、最終的に正規分布に収束していくというわけです。
正規分布の乱用の危険性
ちょっと余談になりますが、何でもかんでも正規分布を適用することの危険性について解説します。
観測結果などで平均と分散以外に有用な情報がない場合に、ある程度の一致があれば正規分布を使うというのは一つのアプローチとして有効です。しかし、このアプローチには注意が必要です。
例えば、投資のリスクを計算する際に正規分布を仮定すると、通常の範囲内での価格変動はある程度の評価ができますが、突発的で極端な経済的イベントや「ブラック・スワン」と呼ばれる予測困難な事象が発生した際のリスクを過小評価する可能性があります。正規分布は、極端な値(例:大きな損失)が発生する確率を低く見積もるため、実際のリスクを正確に反映しない場合があります。
また、正規分布がデータに適合しない場合に、それを仮定することは誠実でも適切でもありません。このような場合には、もしかしたら複数のガウス分布を混合させるガウス混合分布やニューラルネットワークなど、より柔軟な分布を使う方法が必要になるかもしれません。
正規分布とは「平均と分散以外はよくわからん」という分布です。そのため「平均と分散以外はよくわからない」という理由が正直だったとしても、現実の事象が必ずしも正規分布に従うというわけではありません。よって、データをグラフで描いたりして特性を理解したり、その背後にある実際のリスクや極端な事象を反映するための工夫が求められます。
具体例:確率分布の導出
これまで直感的に説明してきだ最大エントロピーの原理を使って実際に確率分布を導出してみます。
離散一様分布を導く
「晴れかどうか」を予測するモデルのエントロピーを次のように表現します。
H=−PFlogPF−PNFlogPNF
Fは「晴れる」(Fine)、NFは「晴れない」(Not Fine)を意味します。
天気に関して全く無知だとすると条件は「確率の合計は1となること」だけです。
PF+PNF=1⟹PF+PNF−1=0
この制約条件を基に、エントロピーを最大化するためにラグランジュ未定乗数法を使います。まず、ラグランジ関数Lを次のように定義します。
L=H+λ(PF+PNF−1)
ここで、λはラグランジュ乗数です。展開すると以下になります。
L=−PFlogPF−PNFlogPNF +λ(PF+PNF−1)
次に、ラグランジュ関数の勾配がゼロなる点(∇L=0)を計算します。
∂PF∂L∂PNF∂L∂λ∂L=−logPF −1+λ=0=−logPNF−1+λ=0=PF+PNF−1=0
3番目の等式は制約条件そのものなので、偏微分するまでもないですが、ラグランジ関数を最大化する勾配の計算をしている意味で表記しています。
これを解くと次の関係が導出されます。
PFPNF=e−1+λ=e−1+λ
また、制約条件より次が成り立ちます。
PF+PNF= e−1+λ+ e−1+λ=1
よって、PF=PNF=0.5が導かれます。これは「晴れる」と「晴れない」が50-50の確率で起こることを意味し、一様分布が導かれたことになります。
我々の直感が最大エントロピー原理で正当化されたことになります。
よって、2つの事象しかない確率分布のエントロピーH(p)は、p=0.5で最大化されることがわかります。
H(p)=−plogp−(1−p)log(1−p)
この関数をプロットすると、p=0.5で最大値に達することが確認できます。
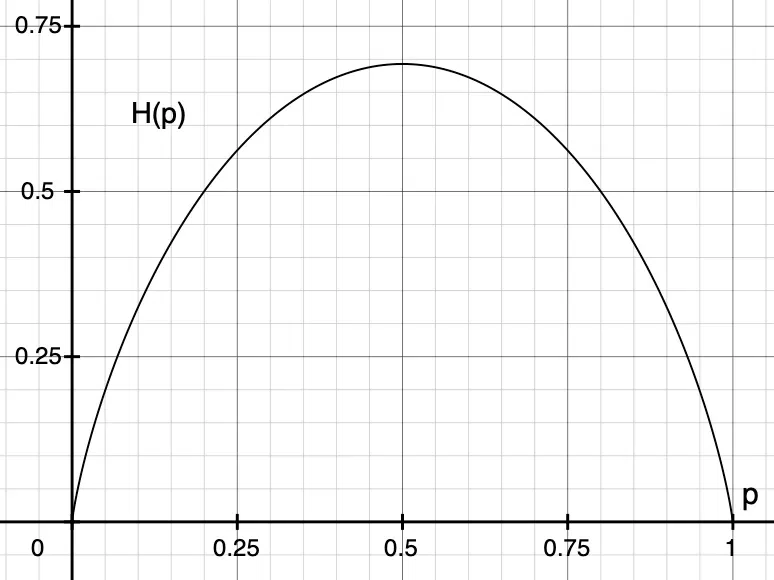 2つの事象しかない確率分布のエントロピー
なお、事象がN個ある場合でも、同様に一様分布が導かれます。この場合、一つの事象が起こる確率はN1になります。以上より、情報がない場合にエントロピーを最大化すること得られる分布は一様分布となります。
連続一様分布を導く
ある場所の気温を予測するモデルを考えます。この場所で可能な最低気温をa度、最高気温をb度とします。よって、気温xの確率分布p(x)は最低気温aと最高気温bの間で連続的になります。
この場合、確率分布p(x)のエントロピーは積分で表現されます。
H=−∫abp(x)logp(x)dx
制約条件として、確率分布の合計が1になる必要があります。
∫abp(x)dx=1
このエントロピーを最大化するために、ラグランジュ未定乗数法を使って制約付き最大化を行います。ラグランジ関数は次のように定義されます。
S[p]= H+λ(∫abp(x)dx−1)= H+∫abλp(x)dx−λ
λはラグランジュ乗数です。
また、S[p]と表記しているのは、その値が関数p(x)によって決まるからです。よって、これは汎関数(Functional)です。
エントロピーの部分を展開すると以下になります。
S[p]=∫ab(−p(x)logp(x)+λp(x))dx−λ
この汎関数S[p]を変分法によって制約付きで最適化することで、エントロピーを最大化する関数p(x)が決まります。最後のλは最適化に関係ないので無視すると、ラグランジアンは以下になります。
L(x,p,p′)=−p(x)logp(x)+λp(x)
最適な関数p(x)が満たすべきオイラー・ラグランジュ方程式は以下になります。
∂p∂L−dxd∂p′∂L=0
ここでp′=dxdp(x)は、ラグランジアンの中では使われていません。よって、オイラー・ラグランジュ方程式は次のように簡略化されます。
∂p∂L=0
これにラグランジアンLを代入します。
∂p∂(−p(x)logp(x)+λp(x))=0
この偏微分の結果として次が導かれます。
−logp(x)−1+λ=0⟹ p(x)=e−1+λ
確率分布の合計が1になるという制約を使ってλの値を求めます。
∫abp(x)dx=1⟹ ∫abe−1+λ dx=1⟹ e−1+λ ∫abdx=1⟹ e−1+λ(b−a)=1⟹ e−1+λ=b−a1
よって、最終的に得られる確率分布はp(x)=b−a1です。これは連続な一様分布であり、aからbの区間で積分すると1になります。
つまり、連続的な確率分布でも、確率に関する制約以外に情報がない場合は、最大エントロピー原理を適用するとことで一様分布が導かれることが示されました。これが「最も無知で正直な」確率分布となります。
繰り返しになりますが、だからと言ってこれが良いモデルというわけではありません。気温の予測のためには、もっと情報が必要だということです。
正規分布を導く
では、気温の平均と標準偏差がわかっている場合、最大エントロピー原理を使って確率分布を導出してみましょう。
気温の平均をμ、標準偏差をσとします。このとき、確率分布は連続的であり、エントロピーを最大化することで最も無秩序な確率分布を求める方法を考えます。
確率分布が連続であるため、エントロピーHは次のように積分で表されます。なお、ここでは最低気温や最高気温は考慮しません。よって、積分範囲は負の無限大から正の無限大です。
H=−∫−∞∞p(x)logp(x)dx
制約条件は、確率の合計が1であるのに加えて、平均μと標準偏差σが与えられていることです。
平均の制約:μ分散の制約:σ2=∫−∞∞p(x)xdx=∫−∞∞p(x)(x−μ)2dx
ただし、分散の制約に平均が含まれているので、分散の制約だけを使います。
これらの制約を満たす確率分布を最大エントロピー原理で求めるために、ラグランジュ未定乗数法を使用します。ラグランジ関数は次のように定義されます。
S[p]=H+λ1( ∫−∞∞p(x)dx−1)+λ2(σ2−∫−∞∞p(x)(x−μ)2dx)=H+∫−∞∞p(x)(λ1 −λ2(x−μ)2)dx−λ1+λ2σ2
ここで、λ1とλ2は、それぞれの制約に対するラグランジュ乗数です。
エントロピーを展開して積分をまとめると以下になります。
S[p]=∫−∞∞p(x)(−logp(x)+λ1 −λ2(x−μ)2)dx−λ1+λ2σ2
よって、ラグランジアンは次のようになります。
L(x,p,p′)=p(x)(−logp(x)+ λ1−λ2(x−μ)2)
連続一様分布と同じようにオイラー・ラグランジュ方程式の2項目が消えるので、ラグランジュ関数Lをpで偏微分することで最適化を行います。
∂p∂L=−logp(x)+λ1−λ2(x−μ)2−1=0
よって、確率分布p(x)は次の形になります。
p(x)=eλ1−λ2(x−μ)2−1
あとはλ1とλ2を求めることになります。そこで積分条件(確率の合計が1)を考慮します。
∫−∞∞p(x)dx=∫−∞∞eλ1−λ2(x−μ)2−1dx=1
ここで積分を簡単にするためにz=λ2(x−μ)で変数変換します。この場合、dz=λ2dxとなります。
∫−∞∞eλ1−λ2(x−μ)2−1dx=λ2eλ1−1∫−∞∞e−z2dz=1
この積分の計算には、ガウス積分の公式から∫−∞∞e−z2dz=πになることを利用します。
eλ1−1λ2π=1⟹eλ1−1=πλ2
これを分散の制約に当てはめます。
σ2=∫−∞∞p(x)(x−μ)2dx=∫−∞∞eλ1−λ2(x−μ)2−1 (x−μ)2dx=πλ2∫−∞∞e−λ2(x−μ)2 (x−μ)2dx
再びz=λ2(x−μ)で変数変換します。
σ2=πλ2∫−∞∞e−z2 λ2z2λ2dz= λ2π1∫−∞∞e−z2z2dz
ここで、部分積分を使ってz2を積分から取り除きます。
∫−∞∞e−z2z2dz= ∫−∞∞z(ze−z2)dz=[z(−21e−z2)]−∞∞−∫−∞∞−21e−z2dz
第一項はゼロになります。第2項はガウス積分の公式から2πとなります。よって分散は以下になります。
σ2= λ2π1∫−∞∞e−z2z2dz= λ2π1 2π=2λ21
よって、λ2= 2σ21です。これによってλ1も決まります。
eλ1−1=πλ2=2πσ21
まとめると、p(x)は以下になります
p(x)=eλ1−λ2(x−μ)2−1= 2πσ21e−2σ2(x−μ)2
以上より、気温の平均μと標準偏差σが与えられた場合に、最大エントロピー原理を使って正規分布を導出することができました。エントロピーが最大化されたので、与えられた制約(平均と標準偏差)に基づいて最も無秩序で不確実な分布です。言い換えると「与えられた制約の下で最も情報量の少ない分布」が正規分布になることがわかりました。
指数関数の理由
最大エントロピー原理を使うと以下のような確率分布が得られます。
「平均と分散」を条件にエントロピーを最大化したのが正規分布です。
「平均のみ」を条件とすると、指数分布が得られます。
データが離散的で平均を条件にすると、ポアソン分布が得られます。
他にもたくさんの分布をこの手法で導くことができます。
もう言うまでもないですが、これらの確率分布の多くに指数関数eが現れるのは、エントロピーを最大化した結果です。
(以上)