LLaMAとは

LLaMAはMetaが発表した言語モデルです。発表当時はChatGPTなどと比較すると、会話型に特化していたわけでもなく、あまり話題になっていませんでした。
ただ、論文で詳細を公開していたり、データセットとしてオープンなものだけを使っていたりと、MetaはOpenAIやGoogleとは異なるスタンスをとっていました。
それが、今ではLLaMAこそがChatGPTの強力なライバルとなり得るのではないかと考えるひともいます。
大きな変化が起きたのは、LLaMAのモデルの重みデータがリークされたからです。大きな話題となり、たくさんの人々によるさまざまな改良やファインチューニングが行われては発表されました。
たくさん起こった事象の内のいくつかを時間軸で追いながら解説しました。
2023年2月24日:LLaMAの発表
この日、MetaがLLaMAを発表しました。論文やGitHubでモデルの詳細や実験結果を発表していましたが、もともとはモデルの重みのデータまでは公開していませんでした。また、会話に特化していたわけでもなく、ChatGPTと比べると一般ユーザーが話題にすることはなかったです。
特徴としては、いくつかの異なるパラメータ数を持ったモデルで構成されるモデル群となっていることです。70億、130億、330億、650億のパラメータを持つモデルがあります。長い時間をかけて訓練を行うことで、比較的小さいモデルであるLLaMA-13B(130億パラメータ)でも、10倍以上の大きさのGPT-3(1750億パラメータ)に負けない性能を発揮します。
また、一般に公開されているデータセットのみを使って訓練をしており、Googleなどが未公開データを使っているのとは一線を画しています。
2023年3月3日:モデルの重みがリーク
Metaは応募した人だけにモデルの重みを公開していましたが、llamanonというユーザーが4chanにリーク(無断で公開)しました。これに対してMetaが犯人を追及して訴えるようなこともなく、多くの研究者たちがさまざまなファインチューニングを行いました。よって、この後に、さまざまなバージョンのLLaMAが登場します。
代表的なものだけでも次のような派生モデルがあります。
Alpaca(スタンフォード)
Vicuna(バークレー、CMU、スタンフォード、サンディエゴ、MBZUAI)
Koala by BAIR(バークレーAI研究所)
LLaMAはラマ、Alpacaはアルパカ、Vicunaはビクーニャとみんなラクダ科の動物の名前になっています。Koalaだけは例外ですが、研究所の名前がBAIRとクマに発音が似ているからでしょうか。英語ではコアラのことをKoala Bearと読んだりもします。もちろん、コアラはクマではありませんが。いずれにせよ、名前の付け方が洒落になっていて面白いですね。
これ以外にもたくさんの亜種(?)が登場しました。このため、LLaMAを巡る状況は、OpenAIのGPTやGoogleのLAMDAなどとは全く異なるものになっています。
2023年3月11日:MacBook Proで実行可能
Georgi GernanovがC++で書いたプログラムでLLaMA(70億パラメータ)をM1 ProのCPU上で走らせることに成功。
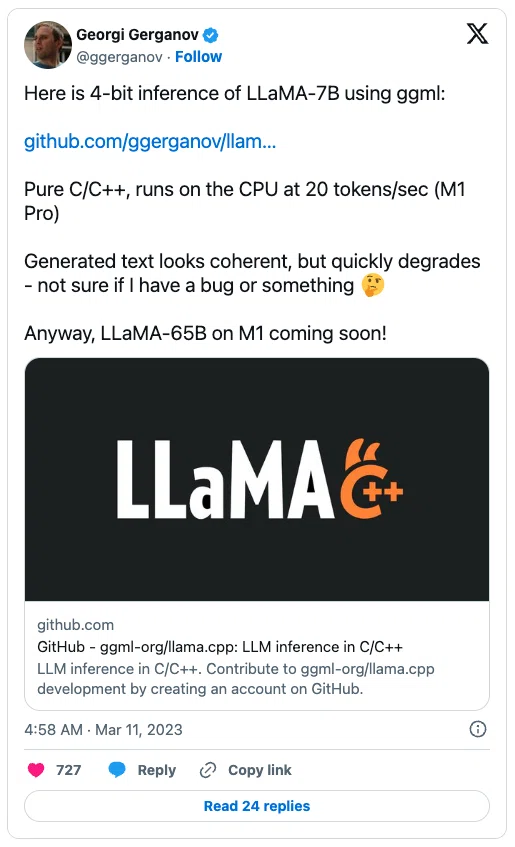
その後、このソースコードはラズベリーパイにも移植される。スピードは早くはないが、以前には考えられなかったことが実現した。
2023年3月13日:ノートPCでファインチューニング
スタンフォードのアルパカを発表。70億パラメータモデルをファインチューニングして、指示に従うように応答するようにした。

さらに亜種になるEric Wangのalpaca-loraは、一個のRTX4090(GPU)を数時間で使うだけでファインチューニングが可能に。こうなると多くの人がファインチューニングできることになる。
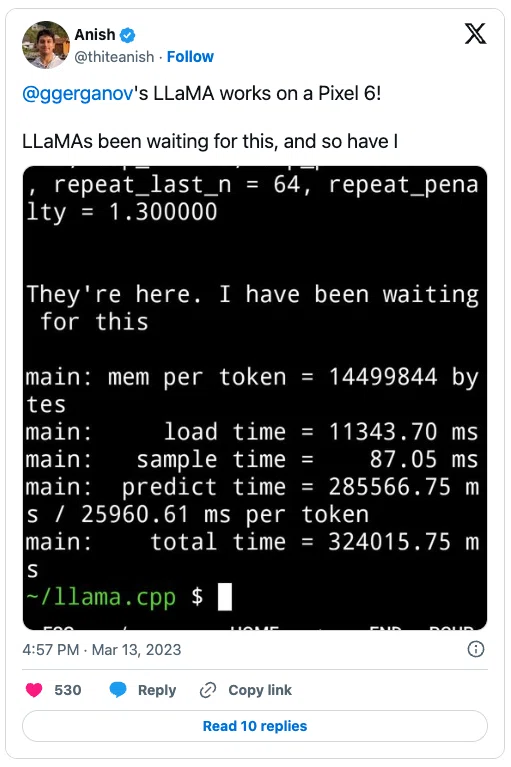
同日に、Googleのスマフォであるピクセル6でLLaMAを走らせたとの報告。
2023年3月19日:GoogleのBard同等の性能
複数の大学(バークレー、CMU、スタンフォード、サンディエゴ、MBZUAIによる Vicunaが130億パラメータでGoogleのBardやOpenAIのChatGPTの性能の90%に達する。また、90%のケースでアルパカよりも良い性能を発揮。
しかも、ファインチューニングに300ドルだけしか費やさなかった。また、追加のデータセットとして、ChatGPTとの会話を一般から収集したShareGPTを使用。
2023年3月25日:GPT4All
GPUもインターネットもいらないチャット環境としてGPT4Allが登場。

GitHubによるとWindows、Mac、Ubuntu上で実行可能とのこと。
2023年4月3日:ChatGPTとの区別ができない
バークレーのKoala(130億パラメータ)は会話型のモデルで、人間によるハンダによってChatGPTと比較されました。結果は人間が好む対応をする基準で考えるとChatGPTと区別ができないほどに良い評価になりました。
なお、ここまでで、モデルのリークからは1ヶ月しか経っていない。驚異的なスピードでさまざまな実験や開発が行われている。
この後にもOpen AssistantからRLHF(Reinforcement Learning with Human Feedback、人間のフィードバックを取り入れた強化学習)を適用した論文が発表される。RLHFはChatGPTでも使われている手法で、より人間が期待するような受けごたえができるように言語モデルを訓練することができます。
こうしてみると、クローズドなChatGPTやBardは競争優位に長いこと居残れるのだろうかと疑問にさえ思えてきます。
もしかしたらオープンソースがクローズドソースを打ち負かすことになるのかもしれません。どこかで聞いたような話ではありますが。
では、また。