Qwen3.8-27BはRTX 4090 24GBで動くのか? LM StudioからUnslothまで、ローカルLLMの限界を実機検証


こんにちは、STUDIO55技術統括の入江です。
Metaの Muse Glimmer-30B が公開されたわずか 4日後、Alibabaの Qwenから Qwen3.8-27B が公開されました。
どちらも同じ「30BクラスのローカルLLM」であり、「エージェント系AIモデル」です。
この夏、Metaと Alibabaという2社から、ローカルで動作する大型モデルが、わずか 数日の間に相次いで登場したことになります。
そして現在、世の中では「GPT-6 Astra」が大きな話題になっています。
Astra は「星」「星座」を意味する言葉です。
8月1日にOpenAI が次期主要モデルを公表し、9月3日に正式リリース。報道機関向けのブリーフィングでは、「AGI時代へようこそ」という言葉で締めくくられるほど、これまでのAI とは一線を画す機能が披露されています。
すでにコミュニティでは、「AGI はいつローカルで使えるようになるのか」といった話題まで上がっており、AI の進化に対する期待は、かなり前のめりになっています。
この記事では、これまで検証してきた Muse Glimmerに続き、Qwen3.8-27B を取り上げます。
そして、2つのエージェント系AIモデルを実際に検証することで、単に「どちらのモデルが優れているか」を比較するのではなく、AI がどのようにマシーンを処理し、外部のツールやデータとつながっていくのかという、その経路そのものに目を向けていきます。
ローカルAI を実際に扱ってみると、クラウドAI を使っているだけでは見えにくい、AI とマシーンの関係や処理の仕組みが見えてきます。
「AIならなんでもできる」と思えるほど高性能になった現在でも、実際には計算資源やメモリ、GPU、コンテキスト、ツール、そして処理時間といったコストが存在します。
つまり、AI は決して無限に何でも処理できるわけではありません。
その仕組みを理解することは、ローカルLLM を使うためだけではなく、これからAI そのものがどこへ向かおうとしているのかを考えるうえでも重要です。
エンジニア中心のコミュニティで飛び交っているさまざまなAI の話題も、こうした仕組みを知っておくことで、単なる「AIのすごい話」ではなく、その裏側で何が起きているのかという視点から読み解けるようになるはずです。
🤖Qwen3.8-27B
この夏、AIの進化が、これまで以上に速いスピードで進んでいることを、改めて実感させられる出来事が続きました。
とくに「Qwen3.8-27B」は、公開からわずか2日でコミュニティから約500種類の量子化版が公開されるなど、非常に大きな盛り上がりを見せています。
このような流れは、ある意味必然で、Qwenシリーズは従来からコミュニティでの活用を前提としたエコシステムが形成されています。それに加え、今回の Qwen3.8-27B(公式リポジトリ)は safetensors形式で18分割、合計55.56GBという非常に大きなモデルで、実質的にデータセンター向けGPU が必要とされるクラスです。
そのため、多くのユーザーは積極的に量子化版を利用したり、CPUや RAMへのオフロードを組み合わせる運用で盛り上がっています。
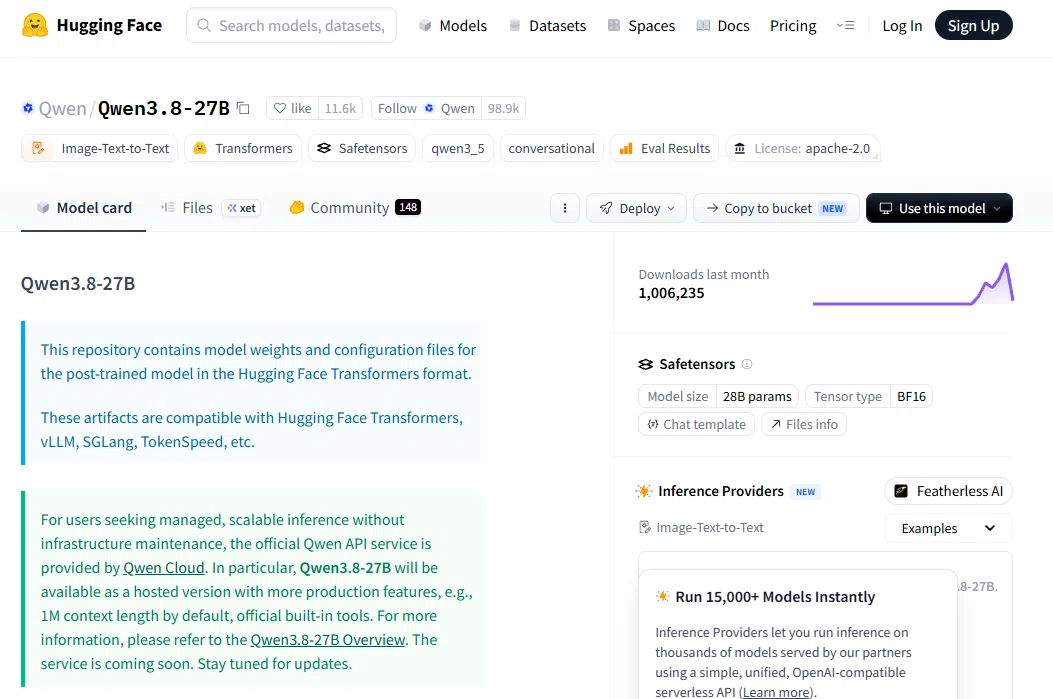
ちなみに、量子化版では Unslothの Qwen3.8-27B NVFP4 が非常に高い人気を集めています。2026年8月25日現在、630万ダウンロード、2.6Kの「いいね」を記録しています。
ただし、これには注意が必要です。
Unslothの NVFP4リポジトリには "Why no NVFP4 GGUF?" というDiscussionがあるように、このモデルは GGUF版ではなく、Safetensorsベースの NVFP4モデルです。
NVFP4 は、NVIDIAが Blackwell世代で導入した 4bitの浮動小数点フォーマットで、低ビット化によるメモリ使用量の削減と、精度低下の抑制を狙ったものです。NVFP4 をネイティブに高速処理できるハードウェア機能は、Blackwell世代(RTX 50シリーズ)から搭載されています。
私が使用しているGPUは RTX 4090で、Ada Lovelace世代 です。この RTX 4090は LLMのために用意した機材ではなく、もともとCG制作向けのGPUレンダリングに使用している業務用マシンです。
そのため、Blackwell世代向けのNVFP4ハードウェアアクセラレーションは利用できません。
つまり、新たに LLM専用の GPUを導入することなく、日常業務で使用している RTX 4090をそのまま活用できるのか ── これが、今回の検証テーマの 1つでもあります。
🔬LM Studio で検証した結果をまず伝えます
前回に続いて、まず LM Studioで Qwen3.8 を回します。
LM Studio アプリ内で「Show files」を押すと、そのモデルで用意されているファイル(量子化バリアント)の一覧が展開されるので、そこから選択します。

LM Studioでは、使用しているハードウェアに応じて、対応するモデルや推奨される量子化バリアントが表示され、この環境で現実的に動かせないものは、そもそも選択肢として出てきません。

ご覧のように、左のStaff Pick の一番上に表示があり、Full GPU Offload Possible の緑バッジが付いています。
これは、私が使用するマシーン "4090の 24GBに全レイヤーが載る" という意味です。
今回の検証に使ったモデルは、このトップに表示された「Qwen3.8 27B Q4_L_M(18.16 GB)」GGUF です。
📄MCPとドキュメントデータの解析テスト
結論からお伝えします。
MCPテストで、「Dドライブ内のデータを整理」するよう指示したところ、Muse Glimmer の場合には、「どのように整理すればよいか」を確認してきます。

一方、Qwen3.8 では追加の確認を行わず、自身の判断でフォルダを作成して整理を進めました。

このような差が、Qwen3.8 がエージェント用途を明示的に強化したモデルだと断言できるかどうかは分かりませんが、とにかく「勝手にやってくれる」といった印象があったのは確かです。
Developer Role への対応やツール呼び出しの改善なども、途中で止まらず、自律的に処理を進める方向の設計思想と整合しています。Codex のようなツール環境での利用を意識したモデルと言えるのでしょう。
この傾向は、図面PDFのテストでも共通し、前回のテストと同じ図面PDFを読ませたところ、Qwen は考えすぎて途中で停止してしまいました。
6ページある PDFで、やりとりの途中でコンテキスト長を使い切ってしまったのです。

Glimmer は、渡された PDFをそのまま処理して回答を返しましたが、Qwen3.8 は、より高い解像度で処理する経路を選択しようとした結果、その実行が環境の制約に収まらなかったようです。
要するに、能力の違いではなく、両モデルが異なる 処理経路 を選択したということです。
Qwen は処理の途中で、より適切と思われる方法を 自ら選択しようとした。状況を判断し、必要であれば処理方法を変更する。その「処理方法を自律的に選択する」性質が、図面読解で裏目に出たと解釈できます。
これは、Redditでも見かけた
「xhighは考えすぎて4倍の時間をかけて失敗した」
という報告とも、構造的な共通点を感じます。
モデルがより重い推論・処理経路を選択するほど、実行時間とリソース消費は増加します。その結果、実行環境の制約に達し、処理が完了できなくなります。
このことは、VRAM を単純に増やせば解決する問題とは少し違います。
たとえば 8GB多い GPUであれば改善する可能性はあります。しかし、2000×1414ピクセルの画像を 6枚処理できる保証があるわけではありません。仮にその処理が可能になったとしても、モデルがさらに自分の考えで高い解像度を選択すれば、同じ問題が再び起きる可能性もあります。
一方で、コミュニティには、同じ 24GBの GPUで 10万トークン規模のコンテキスト長を確保して運用している例があります。新しい GPUだから実現できたのではなく、推論時の設定を調整した結果です。
つまり問題は、ハードウェアそのものではなく、モデルが選択する処理を実行環境の範囲内へ収められるよう、利用者がどこまで制御できるか にあります。
しかし、LM Studio では、この調整が見つかりませんでした。
📝検証メモ
今回の検証では、Qwen3.8 が「各ページを高解像度で詳しく読み取る」という処理経路を自ら選択し、PDFの6ページを約2000×1414px で展開しようとしました。
設定項目として用意されているのは Reasoning Budget(8192) で、これは思考量をトークン数で制限するものです。つまり、「どのように考えるか」を制御するのではなく、「どこで打ち切るか」を決める設定と言えます。

Reddit では、mmproj-offload = false を指定し、ビジョン処理の一部をRAMへオフロードして GPUメモリに余裕を持たせる構成例も報告されています。しかし、LM Studioには同等の設定は見当たりません。
GPU Offload はオートを切れば手動設定できますが、実行中に値が勝手に変更される挙動が確認されました(例:65 → 13)。

これらの検証から、Qwen3.8 を安定して扱うには、限られたリソースを実行環境側がどれだけ効率よく管理できるかが課題になるということが分かりました。
少なくとも今回の検証では、Muse Glimmer には、実行環境に合わせて処理を調整し、安定して完了させる汎用性が感じられました。
一方、Qwen3.8は、より積極的に処理を行う代わりに、VRAM やコンテキスト長など、実行環境の影響を受けやすいという印象です。
そこで次は、モデルそのものだけでなく、それを動かす「ハーネス」の違いに着目し、「Unsloth」のフレームワークで Qwen3.8を実行することにしました。
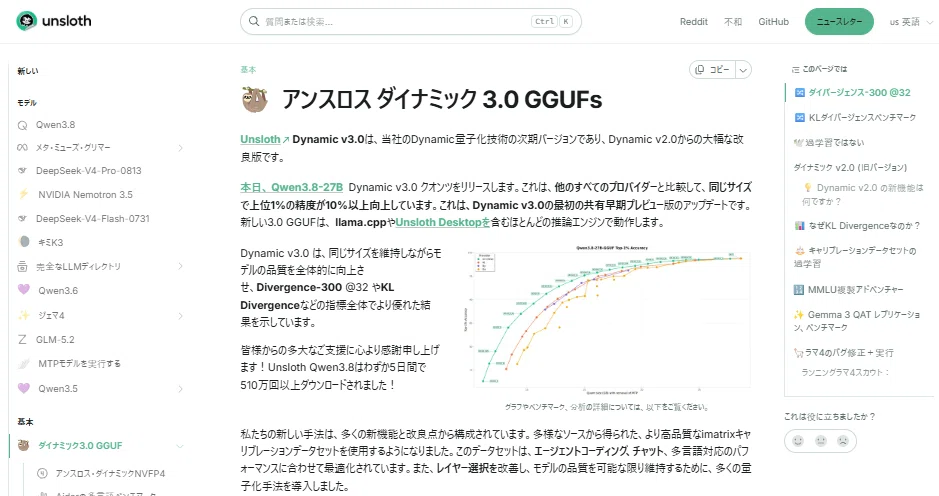
Unsloth は、単にモデルを実行するだけでなく、学習・変換・量子化・各種パラメータの調整まで扱えるため、Unsloth版のUD-Q4_K_XLを使うことで、LM Studio とは異なる実行条件で検証ができそうです。
果たして、実行環境をより細かくコントロールすることで、Qwen3.8の挙動はどこまで安定するのでしょうか。
🛠️Unsloth の検証
最初に、「Unsloth」について解説しておきます。
最近登場した「Unsloth(アンスロース)」は、Qwen3.8 をはじめとする最新LLMの推論からファインチューニングまでを一貫して行えるローカル実行環境として、大きな注目を集めています。
Unsloth の本体は、ファインチューニング用の Pythonライブラリ です。
もともとは、LoRA/QLoRA による学習を高速かつ省メモリで実行することを目的として開発され、Hugging Faceの Transformersや TRLをベースに構築されています。
現在は、主に次の 3つの形態で提供されています。
Unsloth Core — コードベース版(pip install unsloth)。これが元々の姿
Unsloth Studio — ブラウザUI。http://127.0.0.1:8888 で動く
Unsloth Desktop — Tauri製のデスクトップアプリ。←今回使うもの
なお、推論機能のバックエンドには llama.cpp が採用されています。
システムにある「GGUF 推論エンジン」のセクションに、次のようにはっきりと書かれています。
llama.cpp は現在 CUDA で動作しています。
そしてカスタム llama.cpp フォルダの指定欄も確認できます。

そのため、Extra Argumentsには llama.cpp(llama-server)へ渡すコマンドライン引数をそのまま指定できます。
実際にログを確認すると、起動時に実行された llama-server の完全なコマンドラインが記録されています。
Starting llama-server: C:\Users\Owner\.unsloth\llama.cpp\build\bin\Release\llama-server.exe
  -m ...\Qwen3.8-27B-UD-Q4_K_XL.gguf --port 59336 --parallel 4 --flash-attn on
  --no-context-shift -c 8192 -ngl -1 --fit off --metrics ...
  --mmproj ...\mmproj-F16.gguf --cache-ram 0 --ctx-checkpoints 0
  --rope-scaling yarn --yarn-orig-ctx 32768 --mmproj-offload
ここで指定されている
.unsloth\llama.cpp\build\bin\Release\llama-server.exe
が、実際にモデルの推論処理を実行している実行ファイルそのものです。
つまり、Unsloth の画面からモデルを起動しているように見えても、その裏側では llama.cpp の llama-server が実際の推論エンジンとして動作していることが、このログから確認できます。
🖼️Unslothでローカルで画像生成
そもそも「Unsloth」は、単純に LM Studioと同じ種類のハーネスではありません。
Unslothは、モデルの実行だけでなく、ファインチューニングなども含めて扱う統合的な AI実行環境であり、他のツールや推論基盤と組み合わせて利用するための土台として機能します。
さらに現在の Unsloth Desktop では、ローカルでの画像生成にも対応しています。
しかも、画像生成だけではありません。画像編集や動画生成にも対応しており、これまで ComfyUI や Forge などを組み合わせて構築していたワークフローの一部を、Unsloth上で完結させることも可能になっています。
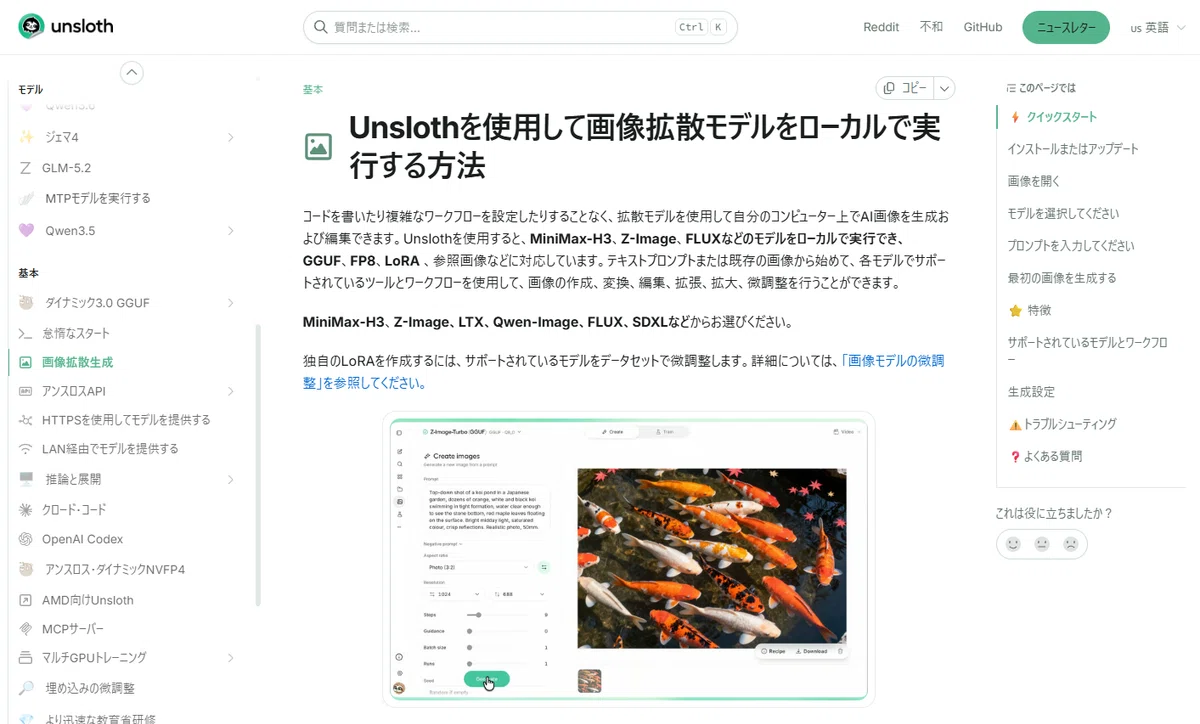
画像生成(FLUX、MiniMax-H3、Z-Image など)
画像編集(Inpainting、Outpainting、アップスケール、参照画像による生成など)
動画生成(Wan、LTX など)
LoRA の利用・学習
Unsloth は モデルを実行するためのプラットフォームとして、
DeepSeek-V4 を選べば LLM(文章生成)
FLUX を選べば 画像生成
Wan を選べば 動画生成
というように、読み込むモデルによって機能が変わります。
単なる「LLMを動かすため」のハーネスから、Unslothは、ローカルAIを扱うための「総合的な実行環境」へと、その役割を広げつつあると言えます。
📦Qwen3.8-27B-GGUF のインストール
モデルのインストールは、チャット画面上部にある「Select model」から行うことができます。
LM Studioとは異なり、該当マシーンで対応が難しいモデルも一覧に表示されます。

上記画像で、DeepSeek-V4-Flash(284.3B)と DeepSeek-V4-Pro(1573.0B)に、赤い 「OOM」マークが付いています。
OOM は Out Of Memory(メモリ不足) の略で、"このマシンでは載らない" という意味です。
LM Studio は「Full GPU Offload Possible」という緑のバッジを出しましたが、こちらは逆に「無理なもの」を警告しています。
判定が正確かどうかは別として、設計思想として一歩踏み込んでいる印象があります。
では、「Qwen3.8-27B-GGUF」から、バージョン一覧トップで "recommended" マークのある「UD-Q4_K_XL」をダウンロードします。
👉 Unsloth が最適化・配布している GGUFで、コンテキストや推論性能を考慮したチューニングが入っているバージョンです。

「UD」は、Unsloth Dynamic(Unsloth Dynamic 量子化を適用したビルド)の略です。
レイヤーごとに最適な量子化方式を選択する動的量子化を採用しており、重要な部分は高い精度を維持し、影響の小さい部分はより強く圧縮するように調整された GGUFになります。
モデルを読み込むと、次のメッセージが出ました。

内容は、mmproj をGPUではなくシステムメモリに置いた、画像入力は使えるが画像処理は遅くなる、というものです。
この配置は Redditの設定例で見た mmproj-offload = false と同じことをしています。あちらは経験のあるユーザーが手動で選んだ設定でした。
それがこちらでは既定の挙動になっています。
なぜ CPUに置かれたのかは分かりません。
24GBに収まらないと判断したのか、それとも既定の方針なのか…
🔎MCPテスト結果
Unsloth の MCPプレースホルダに、前回と同様のコマンドを入力します。
Display name:
filesystemURL or command:
npx -y @modelcontextprotocol/server-filesystem D:\mcp-test前と同じ名前・同じコマンド・同じスコープです。
👉詳しくは前の記事をご覧ください。

左下の「Test connection」を押してテストが通るかを確認し、パスが通ることを確認したうえで、「Add Servers」をクリックします。

対象とするフォルダも前回と同じにしていますが、「案件A」だけ、わざと.txt が二重に付く形で判断が必要なタイトルにしています。

結果として、
「案件A_メモ.txt.txt」を見つけて、移動時に修正すると提案してきました。判断が割れそうな内容をちゃんと拾って修正しています。


⚖️LM Studioとの挙動の違い
ここでのやりとりの挙動について、改めて注目します。
先ほどの LM Studio でのテストでは「勝手にやってくれる」動作でした。
ですが、ここでは違いました。
しっかり確認してきます。
この内容で進めてよろしいですか?また、別の整理方法をご希望でしたらお聞かせください。

じつは、この挙動はモデルの仕様ではありません。
チャット画面左の「Approve for me(私のために承認する)」設定が効いているからです。

この機能が、モデルの応答設計にまで及んでいるものになります。
設定は、クリックから項目を選択することで、自由に変えることが可能です。

👉 参考. 選択内容について
・Ask for approval:
ファイル編集・インターネット利用の前に必ず確認
・Approve for me(既定):
実行するが、認証情報アクセス・権限昇格・破壊的コマンドの前には確認
・Run automatically:
サンドボックス内なら確認なしで実行
・Full access:
無制限。確認なし、コードサンドボックスも無効
最下部の「Full access(確認なし)」を選べば、一度も確認なく一気に作業を行います。
※安全性の観点から、Full access 設定は避けておいた方が良いですが、確認がない分、かなり高速に作業を完了します。もし試しでやってみても、終わったら戻すのを忘れないように。
つまり、LM Studio とは権限設計に対する思想が正反対な仕様になります。
LM Studioは、何か操作するたびに「本当に実行しますか?」と確認してきますが、Unslothでは自分で「どこまで自動で承認するか」を決めることができます。
しかし、LM Studioでは先ほどのテストのように、確認なしで通るケースもあるため、その境界をどこで敷いているのか、こちらでは分かりません。
それに対して、Unsloth は自分で境界を敷くことができるということになります。
・LM Studioは、境界を「システムの既定のルール」が決めている設計
・Unslothは、その境界をどこに置くかを「ユーザー自身が決める」設計
📥ドキュメントの読み込み
では次に、ドキュメントの読み込みテストです。
Unsloth ではデータの読み込みは RAG機能として扱われます。

テストした上で注意しておくべきことを 2点だけお伝えします。
①ドキュメントタイトル表記
英語タイトルは正しく表示されますが、
日本語タイトルでは「_.pdf」となります。

設定の「データ」から、アップロードしたデータを削除するごみ箱があります(上記画像)。ファイル名が表示されないなら、数が増えた場合に、どれを消せばいいのか判別できなくなることになります。
そのため、
Unslothに投げるファイルは、事前に英数字名にリネームする
と覚えておくと良いかと思います。
②チャット先行のやりとり
また、チャットを先行してからドキュメントを読み込ませる手順があります。チャットなしで添付を先に行おうとすると失敗するので、ご注意ください。

Couldn't attach documents — Could not start a chat to attach them to.
(直訳)
ドキュメントを添付できませんでした — 添付先のチャットを開始できませんでした。
Couldn't start a chat for these documents
(直訳)
これらのドキュメント用のチャットを開始できませんでした。
つまり、チャットを作成した上で行う必要がある、という事です。
⚙️--mmproj-offload とコンテキスト削減の組み合わせで調整
テスト結果をお伝えすると、
前回と同じ「図面PDF」を読ませましたが、何度テストを繰り返しても、25% あたりから進まなくなります。

画面には「CPUで動かしています」と出ていました。
ただ、直し方が書いてあったのは ログの中でした。
Auto: running the vision projector on the CPU (--no-mmproj-offload); it does not fit in VRAM alongside the model at 4096 context. Image encoding gets slower.
(直訳)
Auto: ビジョンプロジェクターをCPUで実行します(--no-mmproj-offload)。コンテキスト長4096の場合、モデルと同時にVRAMに収まらないためです。その結果、画像エンコードは低速化します。
モデルを当初ダウンロードした際にも注意書きが表示されましたが、CPUで処理した場合の大幅な速度低下が、これほど大きな影響を及ぼすとは認識できていませんでした。
現在、mmproj はCPU上で動作しています。
そのため、画像処理を伴う処理は低速になることが案内されています。
ベクター形式のページであればテキスト抽出のみで処理できますが、このページは画像処理が必要なため、その恩恵を受けられません。
このような画像処理では、CPUよりもVRAM(GPU)が適切です。
💡 補足. mmproj とは
multimodal projector(マルチモーダル投影器)の略。
ビジョン対応モデルは、実は 2つの部品でできています。
本体(LLM) — テキストを扱う。Qwen3.8-27B の場合 16.4GB
mmproj — 画像を本体が理解できる形に変換する。0.9GB
画像はそのままでは言語モデルに入りません。mmproj が画像をベクトルに変換し、テキストのトークンと同じ形式に「投影」する。
だから projector です。
GGUF形式では別ファイルで配布されます。
Unsloth で mmproj-F16 は、Hugging Faceのキャッシュにあります。
C:\Users\<ユーザー名>\.cache\huggingface\hub\snapshots

ここで直接モデルを確認しても分かりますが、mmproj はF16で、BF16 ではありません。
つまり、本体を4bitに落としても、mmproj は高精度のままです。
自動判定でシステムRAM に置かれた事(--no-mmproj-offload)が原因であることは明白で、そのため画像エンコードが 50〜100倍遅くなり、索引が止まった…
LM Studioでは調整が見つかりませんでしたが、Unsloth ではなんとか経路の調整ができそうです。
そこで、
コンテキストを削って VRAM を空け、
mmproj を GPU に offloadします。
ただし 「New downloads only」 と明記されているため、既存のモデルは移動しません。いま入っている18GBは Cに残ります。
*
具体的な調整内容は以下です。
1. Context Length を下げる(37888 → 8192〜16384程度)
2. Extra Arguments に --mmproj-offload を追加。


これで、画像エンコードがGPUに載るかどうか…
ちなみに、offload は llama.cpp の用語で、「GPUに載せる」という意味です。
--mmproj-offload:mmproj を GPU に載せる
--no-mmproj-offload:GPU に載せず、システムRAM で動かす
設定を改めて ロードして、また画面に「vision projector on the CPU」の通知が出るか、あるいは エラーになるか…
左下のチェックボックス「Remember for this model」にチェックして「Load model」で保存し直します。
なんとか、うまく VRAMに載りました。

コンテキストは、8.2k とあります。
37888から下げた結果が表示されています。

KVキャッシュが 2.9GB → 0.6GB程度(コンテキストが1/4以下)になり、mmproj が約0.9GB増える、という計算から、
差し引きGPUは 18〜19GB台になるはずです。
専用GPUメモリで確認すると、19.9GB。
予想した18〜19GB台に近い値です。

これで、mmproj が GPUに載ったと考えて良さそうです。
じっさいに試してみたところ、速度は桁違い。
46秒で完了しました。
約50〜100倍!
ロードログには mmprojの行が増えています。
GGUF size: 16.4 GB, mmproj: 0.9 GB, est. KV cache: 1.1 GB, context: 8192
Appending user extra args: ['--rope-scaling','yarn','--yarn-orig-ctx','32768','--mmproj-offload']
前回は mmproj: 0.9 GB の項目自体がありませんでした(VRAM勘定に入っていなかった)。
引数が効いて、mmproj が GPU側の計算に含まれています。
16.4 + 0.9 + 1.1 = 18.4GB
タスクマネージャーの 19.9GBとも整合します。
💬読み込んだPDFの内容でチャットする
Unslothではこのような調整が可能であるため、Qwen3.8でも適切な処理経路を構成し、手動で通すことができました。
Qwen3.8 は、用途に応じて細かな調整が必要になる場面も多く、コミュニティでもさまざまなやりとりが見られます。
開発者レベルが中心であることからも、ローカルLLMの汎用性はまだ発展途上という印象ですが、エージェント系AIモデルを手元の環境で自由に動かせる現在の状況には、大きな可能性と期待を感じます。
補足としてお伝えしておくと、
読み込んだドキュメントの内容についてチャットする際は、Context Length を 16384 まで引き上げた状態で動作を確認しました。
計算上:
・16.4(モデル)+ 0.9(mmproj)+ 2.2(KV 16384)= 19.5 GB
・VRAM Budget 21.2 GB
あくまで参考値ではありますが、mmproj が約 0.9 GB のVRAMを使用した状態で、どこまで Context Length を伸ばせるかについては、最終的には実測で確認するしかありません。
その調整の目安について、以下に記載しますので、参考にして下さい。
🧮予算の立て方(KVキャッシュ)
コンテキストの予算を考える際は、まず KVキャッシュを見積もりの起点にします。
「KVキャッシュ(Key-Value Cache)」とは、Attentionの計算で生成される K(Key)とV(Value) を保存し、後続の生成ステップで再利用する仕組みです。
各層のAttentionでは、入力から Kと Vを射影して生成し、それらを層ごとにメモリへ蓄積します。過去のトークンに対応する Kと Vは再計算する必要がないため、キャッシュしておくことで、以降の生成ステップからそのまま参照できます。
つまり、コンテキスト長を増やすほど、KVキャッシュに必要なVRAMも増えていきます。
そのため、コンテキストを必要以上に大きくすると、KVキャッシュがVRAMを圧迫し、モデル本体をVRAMに収められなくなることがあります。
そこで、KVキャッシュの予算を立てておくのです。
一般的に、KVキャッシュのサイズは次の要素によって決まります。
コンテキスト長 — 長くなるほど比例して増加
モデルの層数・Attentionヘッド構成 — モデル固有
KV Cacheのデータ型(Dtype) — f16が基本。q8_0にすると、おおむね半分程度まで削減可能
KVキャッシュはコンテキスト長に対してほぼ比例するため、まずは実測値から1トークンあたりの増加量を求めます。
今回の Qwen3.8-27Bでは、
37,888トークン → 2.9 GB
8,192トークン → 1.1 GB
という実測値が得られました。
この差分から、
2.9 − 1.1 = 1.8 GB
となります。
コンテキスト長の差 は、
37,888 − 8,192 = 29,696トークン
なので、約29.7kトークン増加することで、KVキャッシュが約1.8GB増えています。
ここから概算すると、
29.696 k(KVキャッシュ) ÷ 1.8 GB(コンテキスト) ≒ 0.0606 GB / k
つまり、
約0.061 GB / 1kトークン
約61 MB / 1kトークン
となります。
Qwen3.8-27B / KV Cache f16 では、
1kトークンあたり約0.061 GB(約61MB)の増加と、予想を立てることができます。
ただし、固定のオーバーヘッドが 0.4〜0.5GB ほどあるようですので、これはあくまで目安として見ます。
🧮予算の立て方(コンテキスト長)
VRAM から見たコンテキスト長の予算は、次の式で概算できます。
KV ≒ 0.5 + コンテキスト長(k) × 0.064 GB
例

VRAM Budget(21.2 GB)
 − モデル本体(16.4 GB)
 − mmproj(0.9 GB)
 = 3.9 GB がKVに使える上限
3.9 GB を上の式に代入すると、
0.5 + n × 0.064 = 3.9 → n ≒ 53k
つまり、理論上は約53,000トークンまで格納できる計算になります。
ただし、この値には 画像エンコード時に必要となる一時バッファは含まれておらず、その分の VRAM消費は別途考慮する必要があります。
また、この式はあくまで概算であり、実際の使用可能なコンテキスト長はモデルや実行条件によって変動します。
これも、あくまで目安です。
最も確実なのは、ログを確認することです。
設定を変更してモデルをリロードすると、Unslothが自動で計算した est. KV cache が表示されます。
ここまでの計算式は、あくまで「だいたいこのあたり」という目安を付けるためのものです。最終的な判断は、実際のログに表示される値を基準にしてください。
🤔なぜ、Muse Glimmerは動いてQwen3.8は動かなかったのか
ここまで検証してきて、ひとつ気になることがあります。
なぜ、Muse GlimmerはLM Studioでも難なく扱えたのに、Qwen3.8-27Bではコンテキストが溢れてしまったのか。
最後にその違いをまとめます。
✅ 同じ30Bでも、必要なメモリは同じではない
どちらも 30B前後のモデルです。
VRAM 24GBという同じ環境で試している以上、最初は単純に「モデルサイズの違い」だと思っていました。しかし、実際にUnslothで細かく数値を調整していくと、どうもそれだけでは説明できません。
結論からいうと、
パラメータ数が近い=必要 VRAMも近い、ではない
ということです。
✅ 一番大きいのは、モデルの「構造」の違い
Muse Glimmer は約29.6Bですが、かなり特殊な構造になっています。
特に大きいのが GQA(Grouped-Query Attention)で、Q/KVヘッドが 32 / 2。つまり16個の Queryヘッドで1つの KVヘッドを共有します。
Meta の資料でも、この構造によって KVキャッシュを大きく削減できると説明されています。さらに、Attentionも全層が Full Attentionではなく、3層のSliding Window + 1層のFull Attention という構成です。
これに対して、Qwen3.8-27B では、今回実測したように、コンテキストを伸ばすと KVキャッシュがかなり大きく増えます。
Muse Glimmer
30BなのにKVキャッシュを抑えやすい構造
Qwen3.8-27B
27Bでもコンテキストを伸ばすとKVがVRAMを圧迫する
✅ 画像処理の経路の違い
Muse Glimmerは最初からローカルのエージェント用途を意識して設計されたモデルで、専用のPerception Encoderを持っています。
Meta自身も「consumer hardwareで動かす」ことを設計目標の一つとして挙げています。
一方、今回の Qwen3.8では、単純に「モデル本体がVRAMに入ればOK」ではなく、
モデル本体
+ KVキャッシュ
+ mmproj / 画像処理
+ 推論ランタイムのワークスペース
+ 画像エンコード時の一時バッファ
まで考えないといけません。
だから、RTX 4090の 24GBという物理的な VRAM容量は同じでも、実際にモデルへ渡せる「自由なVRAM」は全然違う わけです。
ここで重要になるのが、パラメータ数ではなく、モデルの構造そのものです。
これは単純に、
「LM StudioよりUnslothのほうが優れている」
という話ではありません。
むしろ、
モデルによって、必要とされる「処理経路」が違う。
ということです。
🎯GPU性能から「メモリ活用」へ
このようなことから、コミュニティではさまざまな工夫が続いています。
そこで最近目立つのが、「GPUだけを主役にしない」方向への最適化です。
つまり、ボトルネックが単純な演算性能から、「モデルをどのメモリ階層にどう収めるか」へ移りつつある ということです。
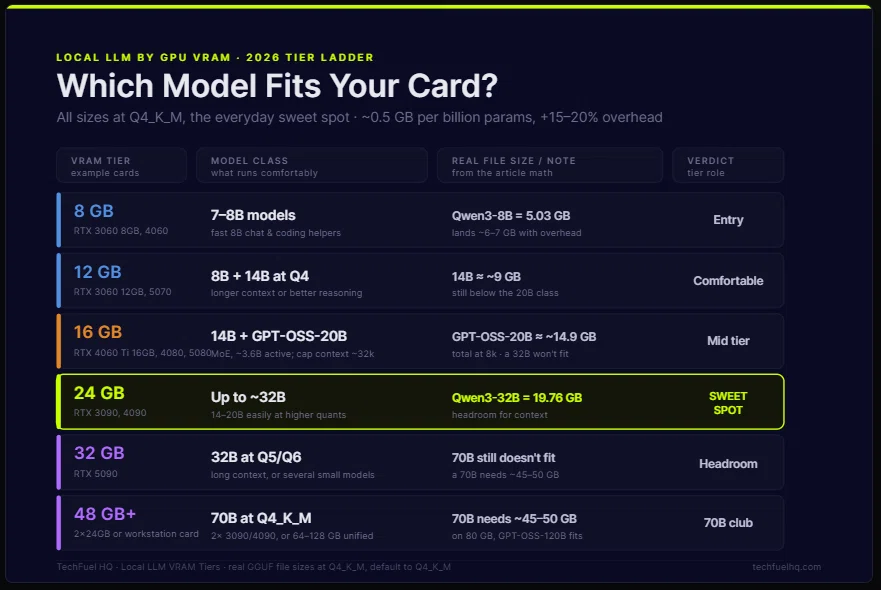
特に MoE(Mixture of Experts)モデルでは、推論時に実際に使用するのは一部のエキスパートだけですが、モデル全体を保持するためのメモリは必要になります。そこで、llama.cpp では非アクティブなエキスパートをシステムRAMへオフロードする --n-cpu-moe のような仕組みが用意されています。
さらに、テンソル単位で VRAMと RAMへの配置を調整する --override-tensor などもあり、「すべてをVRAMに載せる」のではなく、利用可能なメモリ全体をどう組み合わせるかという発想が広がっています。
コミュニティでは、極端な量子化やテンソル配置の工夫によって、これまで24GB級のVRAMが必要と考えられていた35Bクラスのモデルを、より少ないVRAMで動かす事例まで登場しています。
極端な動的量子化 — 1-bit級まで圧縮しながら、実用的な精度を維持する方向
テンソル配置の制御 — どの層をVRAMに置き、どこをシステムRAMへオフロードするかを調整
ランタイム側の対応 — 新しいアーキテクチャが登場すると、まず llama.cpp 側で対応が進み、その後 LM Studioや Ollamaなどにも実装が広がっていく
こうして見ると、現在のローカルLLMの最適化は、単純な「ハイエンドGPU向けの高速化」だけではなく、
むしろ、手元にあるVRAM、システムRAM、そしてそれらの間のメモリ帯域を含めた「メモリ階層全体に、モデルをどう詰め込むか」という技術になりつつあります。
つまり、「巨大化競争」から「効率化競争」へと少しずつ移っていると注目します。
🚀ローカルLLMが促すマシンの進化
クラウドのAIサービスを使っていると、こうした違いはほとんど意識することがありません。
モデルを選択して、入力すれば、それで動きます。
しかしローカルLLM では事情が違います。
どのモデルを使うのか。
どの量子化を選ぶのか。
どれだけのコンテキストを確保するのか。
KVキャッシュをどのDtypeで持つのか。
画像処理をどこで行うのか。
VRAMとシステムRAMをどう使い分けるのか。
そして、どのランタイムを使うのか。
こうした条件によって、同じ GPUでも結果が変わります。
そして、この「処理経路をどう構成するか」という考え方は、現在のメモリ価格の高騰とも無関係ではないように思います。
これまでの PCやワークステーションでは、より高性能な GPUを搭載することが、そのまま性能向上につながるという考え方が比較的分かりやすいものでした。
しかしローカルLLMでは、少し構図が変わります。
高性能な GPUを複数搭載していても、モデルの構造や必要なメモリ容量によっては、その性能を十分に活かせないケースがあります。
一方で、GPUだけに依存せず、大容量のユニファイドメモリを搭載したマシンに注目が集まるのも、こうした背景があるからでしょう。
つまり、これからのAI向けマシンでは、
「どれだけ速いGPUを持っているか」
だけではなく、
「モデルをどのメモリに、どのように配置できるか」
という視点が、より重要になってくるのかもしれません。
これは、単なる GPU性能競争とは少し違う進化です。
VRAM、システムRAM、ユニファイドメモリ、そしてそれらをつなぐメモリ帯域。
限られたリソースをどのように組み合わせ、モデルをどう動かすのか。
ローカルLLMの普及は、ソフトウェア側の最適化だけでなく、「AIを動かすマシンそのものの設計思想」にも変化を促しているように感じます。
- #AI
- #生成AI
- #AI活用
- #動画
- #AI予想
- #AIエージェント
- #セキュリティ
- #ai動画
- #3DCG
- #ローカルLLM
- #トークン
- #メモリ
- #gpu
- #ローカルAI
- #AIセキュリティ
- #AI技術
- #AIモデル
- #推論
- #コンテキスト
- #Astra
- #ハーネス
- #GPT6Astra
- #コンテキストエンジニアリング
- #LMStudio
- #VRAM
- #Qwen3
- #リポジトリ
- #rtx
- #LocalLLM
- #RTX5090
- #AIモデル比較
- #unsloth
- #KVキャッシュ
- #ユニファイドメモリ
- #MuseGlimmer
- #ランタイム
- #ローカルAI構築
- #NVFP4
- #glimmer
- #mmproj
- #AIランタイム
- #reasoningbudget
- #gpuoffload