AIの答えを輪の多い網にまとめたら、効いていたのはルールで、ルールの損に見えた分の多くは正解表にあった




前回は、資料を網でつないで「分からない」と控える方法を比べました。網は輪のない小さな形でした。
今回は、小さなAI(Gemma-2 2B)が答えた何千もの「X は Y の一種か」を、輪のとても多い1つの因子グラフにまとめました。そのうえで、自信の低い答えを控える(selective prediction)性能を比べました。同じグラフを loopy BP で解く場合と、p-bit 方式(ギブスサンプリング、ソフトで再現)で解く場合に差が出るかも見ています。実験は4段(E4-0〜E4-3)で、途中で正解表そのものも見直しました。最後に E5 として、網に入れるルールを AI 自身が作ったときの損を、2つの分野(ものの分類・病気の分類)で測りました。
結論を先に書きます。
-
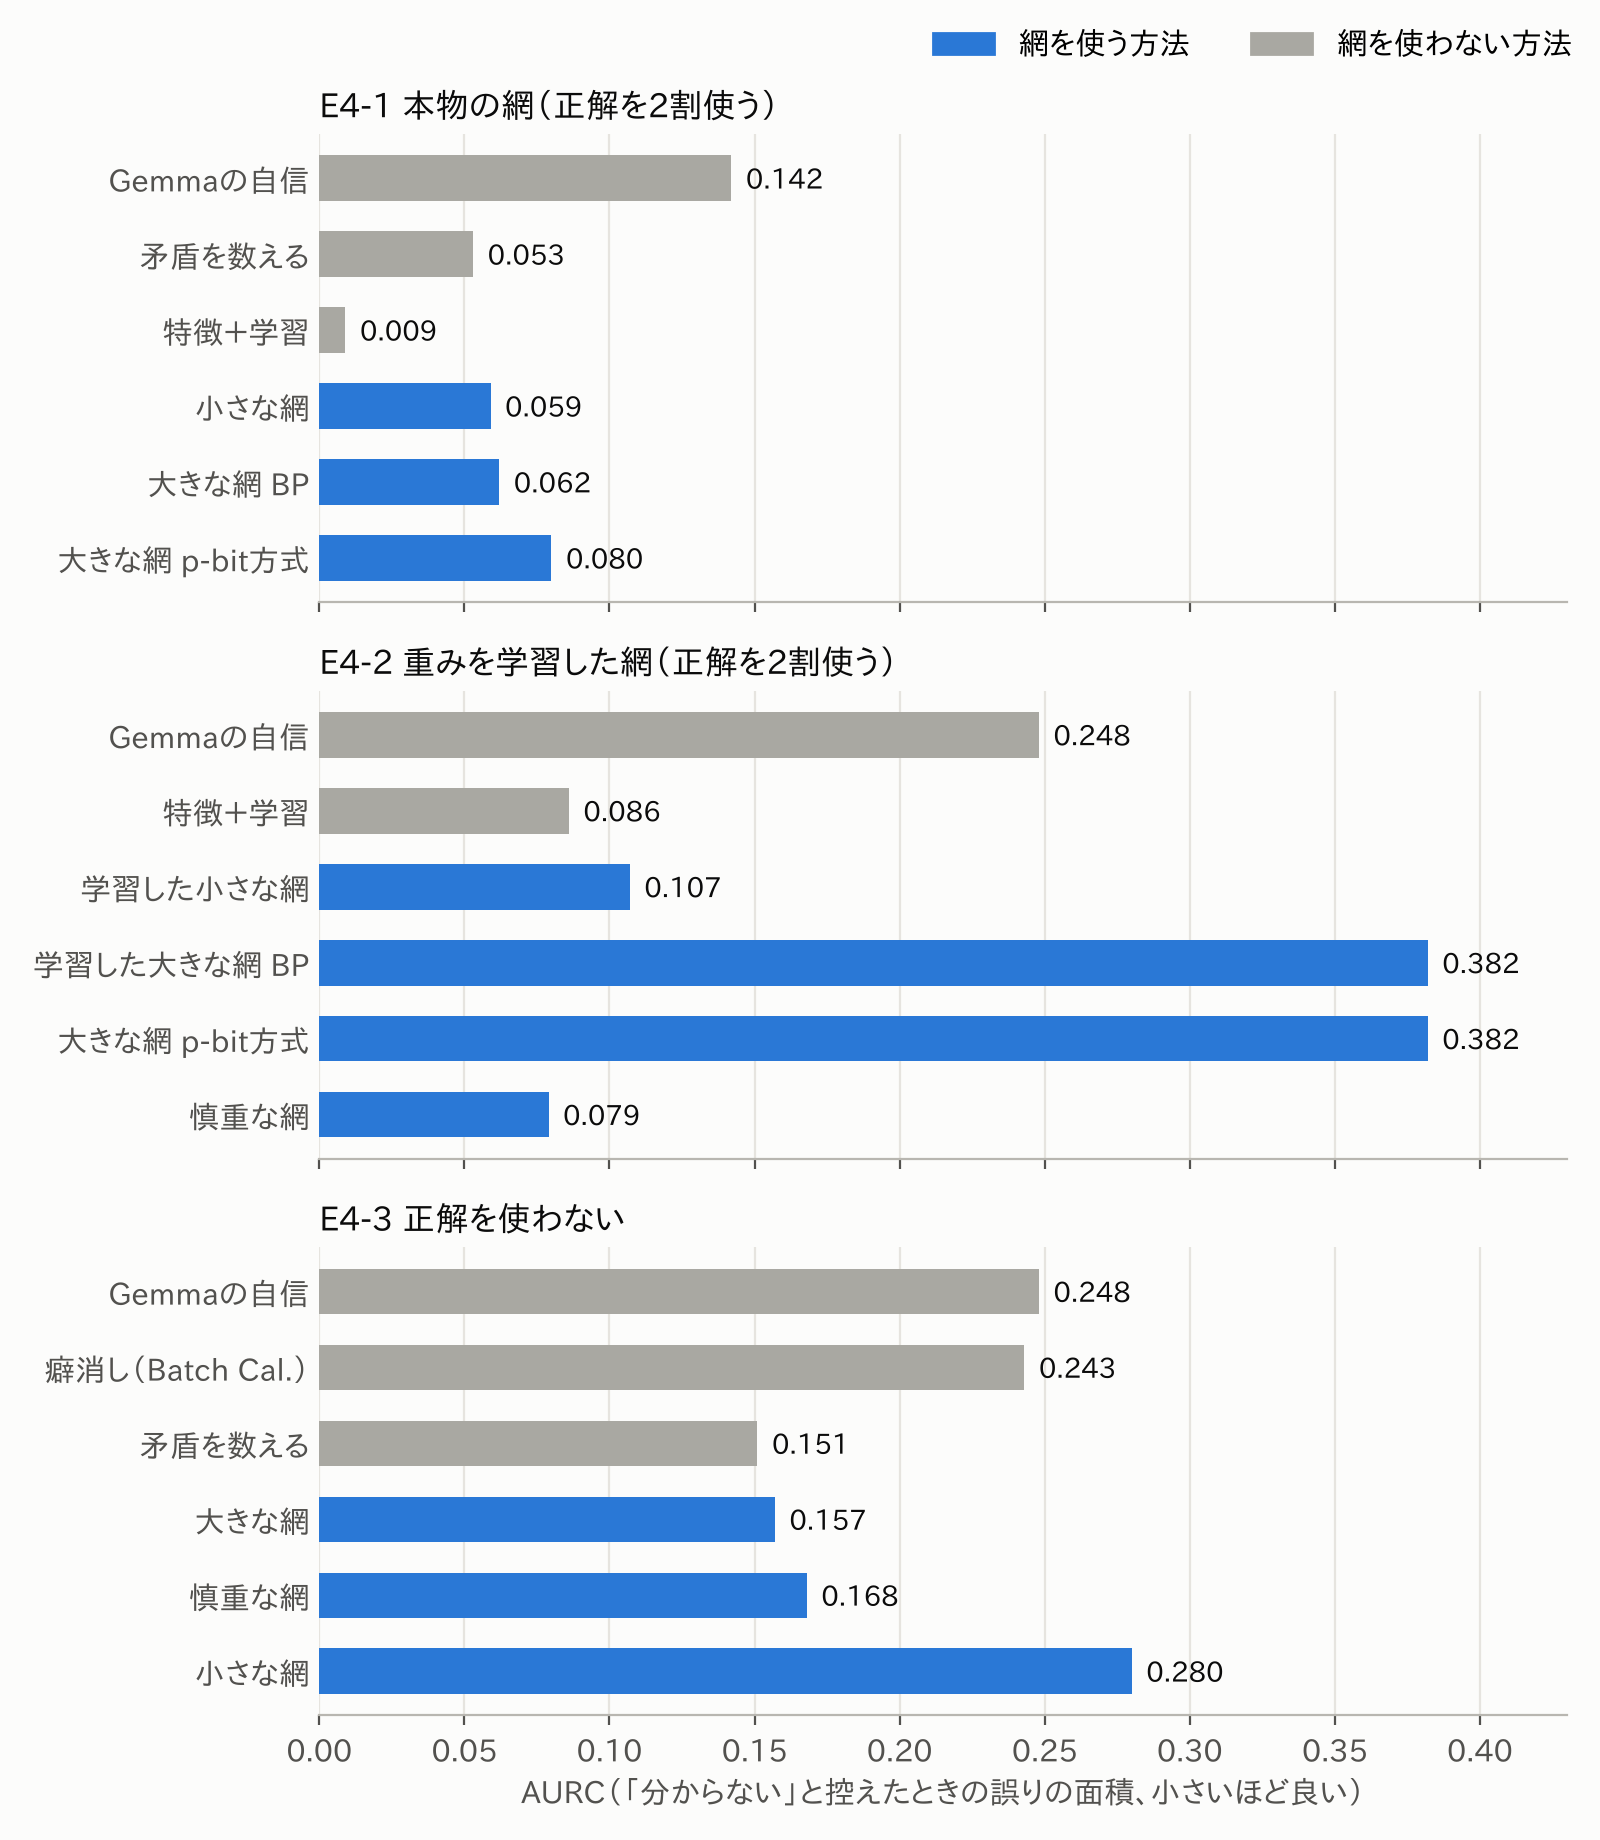
網の解き方(BP か p-bit 方式か)では、正しさは分かれませんでした。 作り物の網(32条件×5回)では30条件で同着、2条件で BP が上でした。本物の網でも同着です。
-
正解が少しある場面では、網は「特徴+ロジスティック回帰」と並ぶのがやっとでした。 使い回す分類の知識まで網の中で動かすと、疑いが積み重なって倒れます(AURC 0.382)。分類の知識を固定した「慎重な網」が一番良く、特徴+LR とは同着でした(0.079 対 0.086。11/11訂正:特徴を勾配ブースティングで組み合わせると、WordNet の正解では 0.038 で網より良い。冒頭の訂正を参照)。
-
正解がまったくない場面(E4-3)では、網は Gemma の自信や正解なしの癖消しにはっきり勝ちました(0.248→0.157)。ただ、同じルールで矛盾を数えるだけの方法と同着でした(0.151)。
-
正解表(WordNet)を見直すと、読み方が変わりました。 「Gemma が一番信じたうそ」の約3分の1は、常識では正しい答えでした。常識で採点し直すと、網(慎重な網・小さな網)が特徴+LR より良く見える方へ動きます。
-
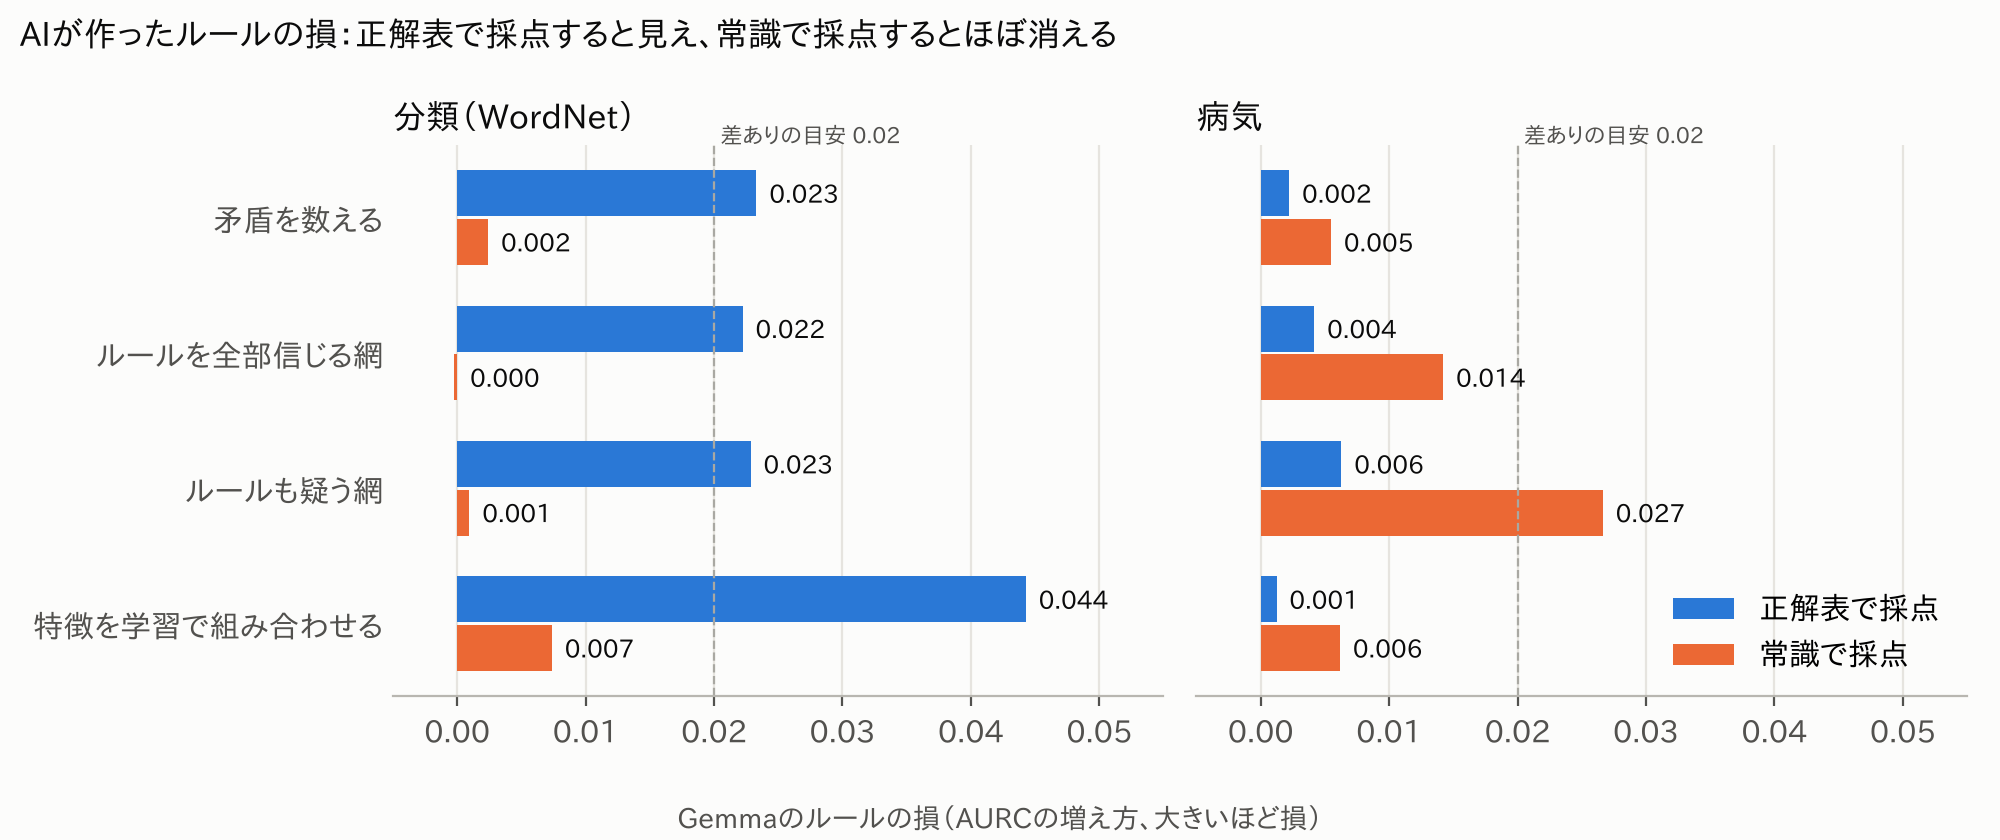
AI が作ったルールの外れの損は、正解表で採点すると見えますが、常識で採点するとほぼ消えました(E5)。 分類では、Gemma の「一種」のルールは WordNet で見ると3つに2つが外れで、AURC で 0.02〜0.04 の損が出ます。常識で採点すると差は 0.000〜0.007 になりました。病気では、正解表で見ても損はほとんどありませんでした。
-
ルールも疑う網は、AI 自身のルールでは効きませんでした。 分類では疑う量がほぼ出ず(全部信じる網と同じ)、病気では5回とも悪くなりました。強く信じたルールだけを残すのも悪化でした。
まとめると、効いていたのは網の計算の仕方ではなく、ルールそのものでした。AI が作ったルールは思ったより頑丈で、注意が要ったのはむしろ正解表の外れのほうでした。
コードと結果は GitHub にあります。
https://github.com/mst-design2020/akane-e2-experiments (analysis/e4/・analysis/e5/、plans/E4-*.md・plans/E5*.md、results/E4/・results/E5/、Gemma の答えは data/E4-*_answers_gemma-2-2b-it.json・data/E2-8_answers_gemma-2-2b-it.json)
物差し
どの方法も主張ごとに p = P(本当) を出し、答え = [p > 0.5]、自信 = |p − 0.5| の低い順に控えます。AURC(risk–coverage 曲線の下の面積、小さいほど良い)と、答える割合 100/90/70/50% の正しさを見ます。名詞を5通りにくじで分け、2割を調整用、8割を評価用にしました。判定は実験前に固定し、AURC の差 0.02 以上で5回中4回以上同じ向きなら差あり、それ以外は同着とします。
網の形
主張
ルールの形は4つで、どれも禁止の形が1つだけです。
| ルール | 主張 | 禁止の形 |
|---|---|---|
| 受け継ぎ | (x∈A, A⊂B, x∈B) | (1,1,0) |
| 両立しない | (x∈A, x∈B, A∩B=∅) | (1,1,1) |
| 逆向き不可 | (A⊂B, B⊂A) | (1,1) |
| 一種なら両立する | (A⊂B, A∩B=∅) | (1,1) |
分類の知識(A⊂B、A∩B=∅)もルールとして固定せず、Gemma の答えとして網に入れています。決めているのは論理の形だけです。BP は log-odds 形で、ダンピング 0.5、最大 500 回にしました。p-bit 方式は、グラフの色分けごとに同時に更新するギブスサンプリングで、1万スイープのうち最初の1割を捨てます。
E4-0:作り物の網
主張 N=2,000 の d-正則グラフ(d=2,3,4,6)に「同じ側/反対側」のルールを置き、外れ率 ε=1,3,10,30% でくじで逆にしました。強さは正しい値 ½log((1−ε)/ε) と、その2倍(信じすぎ)の2通りです。N=20 のグラフで厳密な周辺確率とも比べました。
- 正しさ(AURC):BP と p-bit 方式(鎖1本・1万スイープ)は30/32条件で同着、2条件で BP が上。
- 小さな網での周辺確率のずれ(d=6, ε=30%, 信じすぎ):BP 0.103、p-bit 方式 0.012。BP は確かにずれますが、AURC は同着でした(0.111 vs 0.110)。
- 強いルールを信じすぎた所では、鎖1本の p-bit 方式が谷にはまりました(d=3, ε=1%, 2倍:1万スイープで 0.152、BP は 0.000)。
E4-1:WordNet×Gemma
- 名詞1,500(一語・小文字・名詞の意味が1つ・wordfreq の Zipf 2.5 以上・46分類のうち2つ以上に入る)。分類は WordNet の synset 46個です。
- 候補は名詞ごとに正しい分類を最大4つと、関係ない分類を3つ(正しい分類と下位語を共有しないもの)にしました。
- Gemma への聞き方は "Is the following statement true? Answer Yes or No only.\nStatement: Robin is a type of bird." で、Yes と No の logit の差を取ります。
- グラフは1つの連結成分です。分類どうしの主張1つに、最大957本のルールがつながります。
| 方法 | AURC | 100% | 50% |
|---|---|---|---|
| ① Gemma の自信 | 0.142 | 81.9% | 88.3% |
| ② 破れるルールを数える | 0.053 | 82.0 | 97.7 |
| ③ 特徴+LR | 0.009 | 93.6 | 99.8 |
| ④ 1語ずつの小さな網(BP) | 0.059 | 81.6 | 96.1 |
| ⑤ 大きな網(BP) | 0.062 | 82.3 | 95.5 |
| ⑥ 大きな網(p-bit 方式、鎖4本) | 0.080 | 82.3 | 93.9 |
- ⑤は①に勝ち(5/5)、④と同着、③に負け(0/5)。
- ⑤と⑥は同着です。1回だけ p-bit 方式が谷にはまり 0.144、残り4回は周辺確率の差が 0.001 以内でした。
- 分類どうしの主張は、網に入れると悪化しました(両立しない:0.009→0.063)。
結果を見たあとの確認(参考):③の強さの大半は、Gemma の「いいえ」寄りの癖(はい 28.8%、本当は 43%)の補正と、破れるルール数を重み付きで使うことから来ていました。
E4-2:重みを学習した網
E4-1 の弱点(うそ候補が易しい)を直し、重みを学習しました。
- 名詞1,681×46分類を全部聞きました(80,377問)。うそ候補は名詞ごとに3つです。
- (G) Gemma が一番 Yes と言った間違いの分類
- (H) 兄弟・おじの分類(TaxoGlimpse の難しい側)
- (E) 関係ない分類
- 重みは Jiang ほか 2012 と同じく、擬似尤度をロジスティック回帰で近似して決めました。調整用の名詞の主張について、説明変数を「λ×logit+b+Σ_t W_t ×(周りを Gemma の答えに固定したとき、本当にすると破れる数 − うそにすると破れる数)」とします。W<0 は 0 にしました。学習した値は λ 0.065〜0.081、b 0.91〜1.08、W_受け継ぎ 0.18〜0.32、W_両立しない 1.38〜1.50 です。
- 慎重な網(⑤'):分類どうしの主張を Gemma の値に固定し、BP で入ってくるメッセージを受けないようにします。
- p-bit 方式(⑥):β = 1, 0.8, 0.6, 0.45 の4本で温度を入れ替え(parallel tempering)、β=1 の鎖を数えます。
| 方法 | AURC | 100% | 50% |
|---|---|---|---|
| ① Gemma の自信 | 0.248 | 69.5% | 77.1% |
| ② 自信+LR 補正 | 0.251 | 69.8 | 77.9 |
| ③ 特徴+LR | 0.086 | 77.1 | 93.0 |
| ④ 学習した小さな網 | 0.107 | 79.0 | 89.6 |
| ⑤ 学習した大きな網(BP) | 0.382 | 45.9 | 60.9 |
| ⑤' 慎重な網 | 0.079 | 79.0 | 93.5 |
| ⑥ p-bit 方式(温度入れ替え) | 0.382 | 45.6 | 60.8 |
| ⑦ 強さ1つを格子で | 0.151 | 69.8 | 85.7 |
- ⑤は「ほぼ全部 Yes」に倒れました。うそを当てた割合は G 0%、H 3〜11%、E 3〜13% です。②・③・④に 5/5 で負けました。
- 分類どうしの主張の場を補正なしの logit にしても倒れました(0.18〜0.21、結果を見たあとの確認)。分類どうしの主張は多くの名詞から疑いを受け、それが積み重なります(loopy BP の数えすぎ。Weller 2015、McDowell ほか 2009 の慎重な集団分類と同じ形)。
- ⑤' は ③ より5回とも小さい値でしたが、差は 0.007 なので同着です(11/11訂正:③ を勾配ブースティングにすると 0.038 で、⑤' の負け。冒頭の訂正を参照)。
- G(Gemma が一番信じたうそ)を見抜いた割合(WordNet の正解で):① 31%、③ 53%、⑤' 54%。この数字は後の「正解表の見直し」で大きく変わります。
- ⑤ と ⑥ の周辺確率の差は平均 0.004 で、温度の入れ替えは1回も受理されませんでした。主張1万個超で温度4段は粗すぎます。
E4-3:正解をまったく使わない
E4-2 では、網は正解を2割使う特徴+LR に勝てませんでした。網はルールで動くので、正解がない場面なら出番があるかもしれません。E4-2 と同じ Gemma の答えと網を使い、正解は評価だけに使いました。
一番近い先行研究は Platanios ほか(NeurIPS 2017)です。NELL の分類器6つの答えを、分類表のルールと一緒に確率論理で解き、正解なしで各分類器の誤り率を推し量っています。今回は答える側が1つの小さなAIで、ルールの中身(どれが一種か)もそのAIの答えです。また「分からない」と控える力を測っています。
| 方法(全部、正解なし) | AURC | 100% | 50% |
|---|---|---|---|
| ① Gemma の自信 σ(ℓ) | 0.248 | 69.5% | 77.1% |
| ② 矛盾を数える(W=1) | 0.151 | 70.2 | 84.3 |
| ③ 網なしの癖の推し量り(Dawid–Skene 型 EM) | 0.253 | 69.6 | 77.1 |
| ④ 正解なしの大きな網(EM+BP、W=2) | 0.157 | 73.1 | 81.0 |
| ⑤ 正解なしの慎重な網 | 0.168 | 80.1 | 84.4 |
| ⑥ 正解なしの小さな網 | 0.280 | 64.8 | 71.7 |
| ⑦ Batch Calibration(Zhou ほか 2024) | 0.243 | 69.2 | 76.1 |
- ③④⑤⑥は、logit を種類ごとに10段に分け、「本当のとき/うそのときに各段が出る割合」と本当の割合を EM で推し量ります。始めは Gemma の答えをそのまま信じる所からです。
- 網ありの EM で、本当の割合を周辺確率の平均で更新すると、網の押しを二重に数えて暴走しました(作り物で確認)。そこで「Gemma の答えを見ない網だけのモデルで、種類ごとの平均が周辺確率の平均と合う偏り」を合わせる形にしました。これも正解は使いません。
- 判定:④は①・③・⑦に5回とも勝ち(差 約0.09)。④対②、⑤対④は同着。③対①、⑦対①も同着で、正解なしの癖消しはこのデータではほとんど効きませんでした。
- 推し量った本当の割合は、物の主張 0.453(本当は 0.430)、両立しない 0.965(0.969)と近い一方、一種 0.255(0.026)は大きくずれました。使い回す知識の正しさは、正解なしの網では推し量れませんでした。
- 参考:ルールの強さ W=4 では 0.132 でしたが、W を選ぶのに正解が要るので主張には使いません。
正解表の見直し
ここまでの正解は、WordNet の階層から機械的に取ったものです。Gemma が作った「一種」のルールを WordNet で採点すると、「はい」と言った144組のうち正しいのは48組(33%)でした。この数字が低すぎないかを確かめるため、正解表を見ずに、常識で700個を判定し直しました。内訳は G 200・H 200・E 100・正しい側 200 で、無作為に選んでいます。基準は「X のどれかの普通の意味で、X is a type of C が正しいか」です。
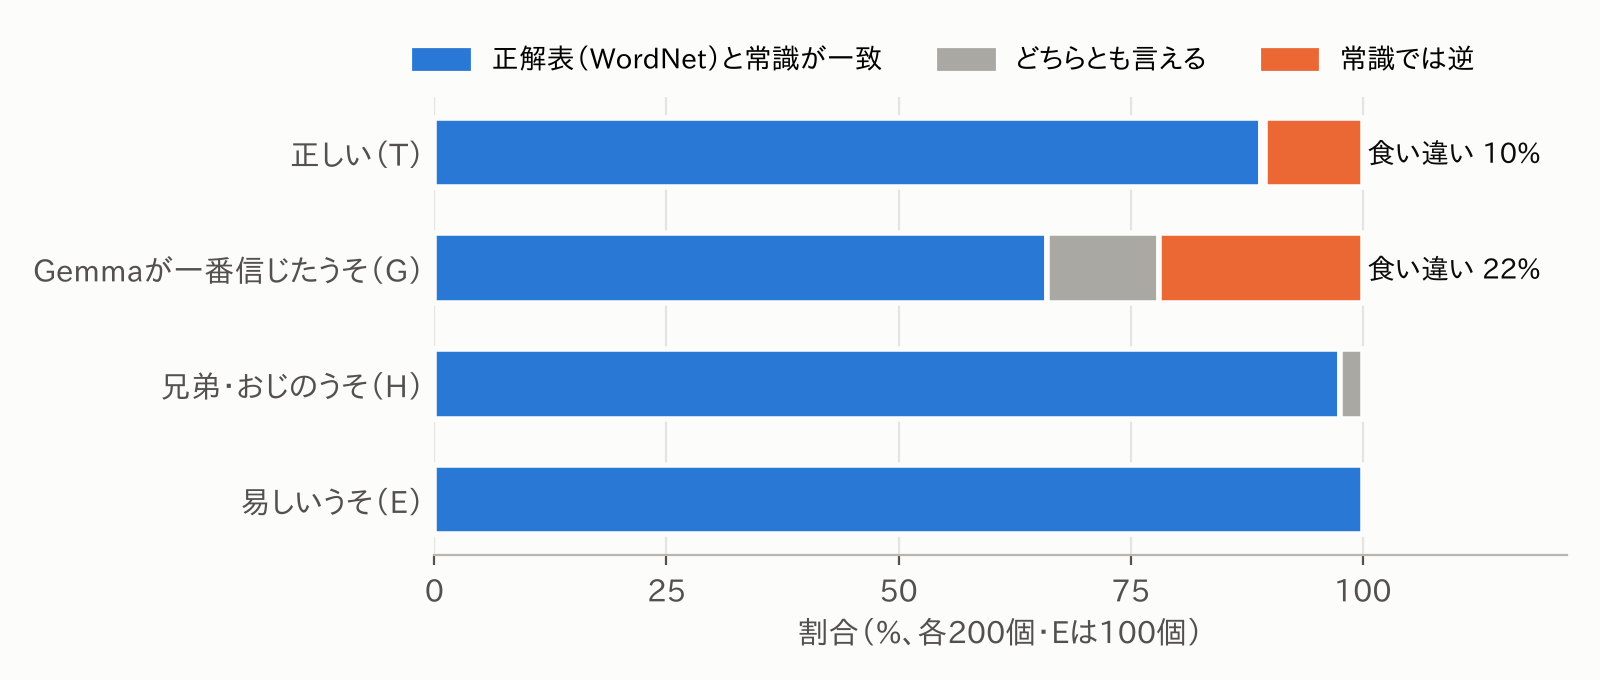
- G(Gemma が一番信じたうそ)の22%は、常識でははっきり正しい答えでした。どちらとも言えるものも12%あります。例は agua→drink、velvet→material、economist→worker、mariposa→insect です。WordNet が言葉の意味を狭く1つに決めているためです。
- H・E はほぼ本当にうそでした。
- 逆に、正しいとされた側の約1割は、常識では外れでした(jeep→container、stupid→person など、珍しい意味によるもの)。
- 「一種」のルールも同じで、外れとされた96組のうち15〜20組は常識では正しく(vegetable→food、metal→material、car→machine、person→mammal など)、正しい割合は約45〜50%になります。それでも、144組のうち19組は逆向きにも「はい」と言っており(animal→mammal と mammal→animal など)、はっきりした外れも多くあります。
この700個で、E4-2 の方法を採点し直しました(5回の平均)。
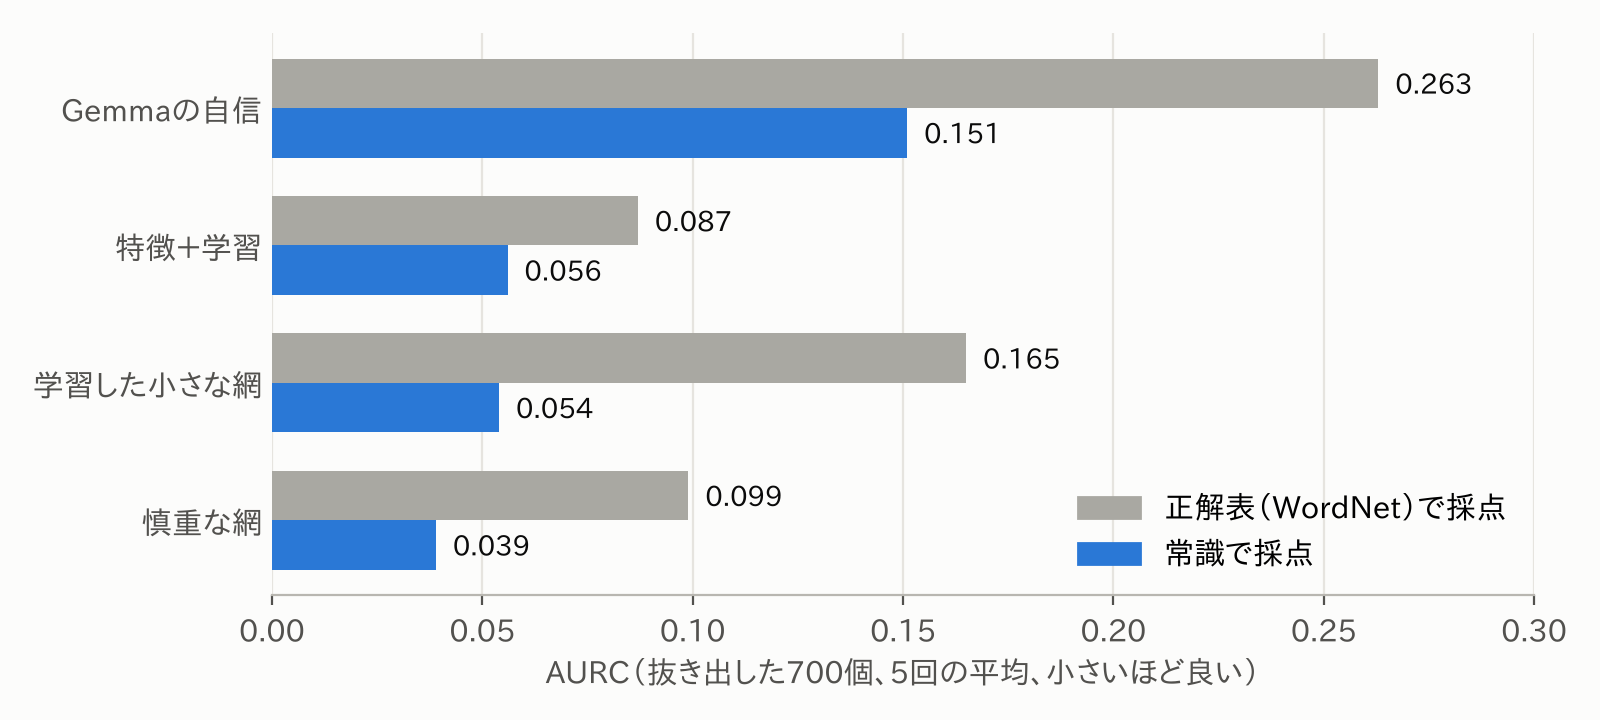
| 方法 | AURC(WordNet) | AURC(常識) | G の正しさ(WordNet→常識) |
|---|---|---|---|
| ① Gemma の自信 | 0.263 | 0.151 | 28%→60% |
| ③ 特徴+LR | 0.087 | 0.056 | 50%→76% |
| ④ 学習した小さな網 | 0.165 | 0.054 | 38%→70% |
| ⑤' 慎重な網 | 0.099 | 0.039 | 49%→80% |
- WordNet で採点すると ③ が一番ですが、常識で採点すると ⑤' が一番になり、④ も ③ と並びます。⑤' は ③ より5回とも小さいですが、差は 0.013〜0.027 で、事前の基準では同着のままです。
- 見立て:③ は WordNet の正解で学習しているので、正解表の癖ごと覚えます。網はルールで動くので、癖の影響を受けにくいのだと考えています。
- 「G はどの方法でもほとんど直らない」という前の読みは言い過ぎでした。
E5:AIが作ったルールの外れは、どれだけ損か
E4 の網のルール(A⊂B、A∩B=∅)は Gemma の答えから作っています。その外れが答え直しにどれだけ響くかを測りました。Gemma の答えはそのままで、ルールだけを入れ替えます。新しく AI に聞く必要はありません。計画と予想は結果を見る前に plans/E5_rule_errors.md、plans/E5-2_disease.md に書きました。
近い先行研究との違い:TaxoGlimpse(Sun ほか 2024)や LLM-Hype は AI の分類の知識の外れの割合を測っています。BeliefBank(Kassner ほか 2021)や ConCoRD(Mitchell ほか 2022)はルールで答えを直しますが、ルールは正しいと置いています。Snorkel(Ratner ほか 2017)は外れを含むルール(ラベル関数)を扱いますが、ルールは人が書きます。「AI 自身が作ったルールの外れが、そのルールでの答え直しにどれだけ効くか」を、正解表と常識の2つの物差しで測ったものは見当たりませんでした。
入れ替えるルール
| 記号 | ルール |
|---|---|
| R0 | なし |
| R1 | 正しいルール(正解表のとおり) |
| R2 | Gemma のルール(Yes−No の logit の符号のとおり) |
| R3 | R2 の外れを 2・5・8割、くじで正解表に直す |
| R3a / R3b | 外れの片方の種類だけを全部直す |
| R4 | Gemma の |logit| が大きい半分だけ残し、残りはルールなし |
比べる方法(物の主張だけを評価)
- ② 矛盾を数える:Gemma の logit に、そのルールで「本当にすると破れる数 − うそにすると破れる数」を強さ1で足す
- ③ ルールを全部信じる網:分類どうしの主張をルールの Yes/No に固定(E4-2 の慎重な網と同じ作り)
- ④ ルールも疑う網:分類どうしの主張を Gemma の確率 σ(ℓ) のまま固定。E2 から試してきた「ルールも疑う BP」に当たります
- ⑤ 特徴+LR(E4-2 と同じ。矛盾の数はそのルールで数える)
網の重みは E4-2 と同じく調整用2割で学びます。採点は正解表と常識の2通りです。常識の判定は、E4 の見直しの700個(分類)と、抜き出し702個(病気)に、2つの AI(Claude と Gemini)が別々に付けました。人の判定ではありません。2つの一致は約9割(分類で3択 87%、病気で「どちらとも=正しい」とすると 87%)でした。
分類(WordNet、E4-2 の 80,377問)
Gemma の「一種」の Yes は144組で、WordNet で正しいのは48組です。「両立しない」は 928組中 56組が外れでした。
| ルール | ② 数える | ③ 信じる網 | ④ 疑う網 | ⑤ 特徴+LR | ③(常識) | ⑤(常識) |
|---|---|---|---|---|---|---|
| R0 なし | 0.248 | 0.251 | 0.251 | 0.194 | 0.154 | 0.107 |
| R1 WordNet | 0.128 | 0.056 | 0.056 | 0.043 | 0.046 | 0.051 |
| R2 Gemma | 0.151 | 0.079 | 0.079 | 0.087 | 0.046 | 0.058 |
| R3 5割直す | 0.137 | 0.071 | 0.072 | 0.072 | 0.050 | 0.059 |
| R3a 一種だけ直す | 0.130 | 0.060 | 0.060 | 0.044 | 0.043 | 0.051 |
| R3b 両立しないだけ直す | 0.155 | 0.076 | 0.078 | 0.089 | 0.048 | 0.066 |
| R4 強い半分だけ | 0.161 | 0.134 | 0.130 | 0.085 | 0.090 | 0.068 |
(AURC、5回の平均。① Gemma の自信は WordNet 0.248/常識 0.152)
- Gemma のルールの損(R2−R1、WordNet で採点):② 0.023、③ 0.022、④ 0.023、⑤ 0.044。どれも 5/5 で差ありです(11/11追記:⑤を勾配ブースティングにすると 0.021)。
- 同じ損を常識で採点すると:② 0.002、③ 0.000、④ 0.001、⑤ 0.007。どれも差なしでした。Gemini の判定で採点しても −0.004〜+0.004 で、同じ結論です。
- 損のほぼ全部は「一種」のルールの外れから来ます(R3a で R1 並み)。外れとされた96組を Gemini に見せると、はっきり正しい32組、どちらとも49組、違う15組でした(vegetable→food、car→machine、person→mammal など)。
- ④ 疑う網は ③ と同じでした(差 0.001〜0.004)。Gemma の「一種」の答えはほぼ両端(logit ±8 前後)で、疑う量がほとんど出ません。
- R4 は R2 より悪くなりました(③ で 0.134 対 0.079、5/5)。外れが混ざっていても、ルールが抜ける損のほうが大きいようです。半分答えたときの正しさで言うと、③ は R1 96.8%、R2 92.5%、R4 87.2% です。
- E4-2 の慎重な網では、分類どうしの主張に物の主張用の補正をかけていたので、「一種」のルールの中身が効いていなかったかもしれない、と心配していました。③ R2 は 0.079 で E4-2 の ⑤' と同じでした。物の主張の結果には影響していませんでした。
病気(E2-8 の Gemma の答え、Human Disease Ontology)
病気600×分類22の主張3,304、つながりのルール527本(どの条件でも同じ)、分類の組231 を使い、「両立しない」のルールだけを入れ替えました。Gemma の「両立しない」は DOID と 83.5% 一致し、外れは38組(言い過ぎ10、見逃し28)です。地理も候補にしましたが、Gemma の地理のルールは 99% 正しく、外れがほとんどないので外しました。
| ルール | ② 数える | ③ 信じる網 | ④ 疑う網 | ⑤ 特徴+LR | ③(常識) | ④(常識) | ⑤(常識) |
|---|---|---|---|---|---|---|---|
| R0 なし | 0.046 | 0.047 | 0.047 | 0.027 | 0.253 | 0.253 | 0.190 |
| R1 DOID | 0.036 | 0.031 | 0.031 | 0.024 | 0.202 | 0.202 | 0.178 |
| R2 Gemma | 0.038 | 0.035 | 0.037 | 0.025 | 0.216 | 0.229 | 0.185 |
| R3a 見逃しだけ直す | 0.035 | 0.030 | 0.032 | 0.024 | 0.199 | 0.210 | 0.178 |
| R3b 言い過ぎだけ直す | 0.039 | 0.036 | 0.038 | 0.026 | 0.219 | 0.233 | 0.185 |
| R4 強い半分だけ | 0.041 | 0.038 | 0.040 | 0.026 | 0.227 | 0.241 | 0.186 |
(① Gemma の自信は DOID 0.050。常識の列は食い違いを多めに取った抜き出しなので、値そのものは DOID の列と比べられません)
- DOID で採点すると、Gemma のルールの損は 0.001〜0.006 で、どれも差なしでした。そもそもこの分野はルールの効き目が小さいです(③ R0 0.047→R1 0.031)。
- 常識で採点すると、②③⑤ は差なし。④ 疑う網だけ 0.027 の損(5/5) が出ました。同じ抜き出しを DOID で採点しても 0.023(5/5)なので、常識のせいではありません。病気の組への Gemma の自信は弱く(|logit| の中央値 約4)、その弱い確率のまま組を置くと網が悪くなります。
- 外れた38組を見ると、DOID の「両立しない」の決め方(DOID の中に両方に入る病気が1つもない)の狭さも出ていました。たとえば心臓の病気とウイルス感染は、表の上では両立しないことになっています。Claude の判定では、見逃し28組のうち常識でも両立しないのは7組でした。
- Gemini は組78組を全部「違う」とし、組の判定には使えませんでした。主張の判定で採点し直すと、④ だけ 0.024(5/5)で、Claude と同じ結論です。
予想の答え合わせ
結果を見る前に書いた予想は、分類で4つ中2つ、病気で4つ中1つ当たりました。外れたのは「④ 疑う網は損が小さい」「⑤ は損が小さい」「R4 は R2 より損が小さい」などです。外れもそのまま計画書に残しています。
読み方
- 解き方より、網の作り。 BP と p-bit 方式は、作り物でも本物でも正しさで分かれませんでした。p-bit の良さがあるとすれば速さ・電力で、シミュレーションでは測れません。倒れたのは解き方ではなく、使い回す知識まで網で動かす作りのせいでした(BP も温度入れ替えも同じ所に倒れました)。McDowell ほか 2009 の「慎重な集団分類」と同じ形です。
- 網の計算より、ルール。 正解なしでも、矛盾を数えるだけで網と同じくらい良くなりました。網でまとめる上乗せは見えません。
- AI が作ったルールは思ったより頑丈。 E5 では、損に見えた分の多くが正解表の意味の狭さから来ていました。外れたルールを捨てるより、全部使うほうが良い結果でした。ルールも疑う網は、わざと外したルール(E2-9)では保険として働きましたが、AI 自身のルールでは、自信が両端すぎるか弱すぎるかで役に立ちませんでした。
- ルールと正解表の外れが、順位を動かす。 Gemma の「一種」のルールは半分前後が外れていました。正解表(WordNet)も、意味の狭さのせいで「うそ」の一部が実は正しい答えでした。正解表を替えるだけで方法の順位が入れ替わったので、WordNet のような正解表で方法を比べるときは、正解表の外れを先に見ておく必要があります。TaxoGlimpse・LLM-Hype などは AI の分類の知識の外れの割合を測っています。LoCo-LMs・BeliefBank・ConCoRD などはルールが正しいと置いています。今回は、その間の「AI自身が作ったルールの外れと、正解表の外れが、答え直しの比べにどれだけ効くか」が大きいことが見えました。次の E5 で、ここを正面から測りました。
言えないこと
- 網が良いとは言えません。
- 分野1つ(WordNet)、モデル1つ(Gemma-2 2B)、英語だけです。vertebrate など4分類を外しています。
- 正解表の見直しは、判定が1人分で、700個の抜き出しです。G・H を多めに取っているので、AURC の値そのものは本番の全体とは比べられません。特徴+LR は WordNet の正解で学習したままです。
- E4-2 の重み学習は近似です。⑤' は名詞の主張で学んだ λ, b を分類どうしの主張にも使ったため、分類どうしの主張そのものの AURC は悪くなりました(一種 0.892)。
- ③と網の重み(E4-2)は、どちらも同じ2割の正解を使っています。
- E4-3 の EM は50回で落ち着き切っていません(最後の変化 0.01)。ルールの強さ W は決め打ちです。
- 温度入れ替えは4段だけです。
- E5 の常識の判定は2つの AI によるもので、人や専門家の判定ではありません。抜き出しの採点で、病気の組の判定は1つの AI 分だけです。ルールの外れ・「外れを直す」の向きも正解表で決めています。分野は2つ、モデルは1つ、英語だけです。
再現
cd analysis/e4
python e40.py                                   # E4-0(CPU 約20分)
NLTK_DATA=<wordnet> python e41_data.py          # 問いを作る(ノートで使ったものと同一)
NLTK_DATA=<wordnet> python e42_data.py
python e41.py e41_data.json ../../data/E4-1_answers_gemma-2-2b-it.json out41.json   # 約70分
python e42.py e42_data.json ../../data/E4-2_answers_gemma-2-2b-it.json out42.json   # 約65分
python e43.py e42_data.json ../../data/E4-2_answers_gemma-2-2b-it.json out43.json   # E4-3、約20分
cd ../.. && python analysis/e4/relabel/e42_relabel.py                              # 正解表の見直し
cd analysis/e5
python e5.py ../e4/e42_data.json ../../data/E4-2_answers_gemma-2-2b-it.json labels/sample_labeled.json out5.json   # E5(1分以内)
python e52.py ../../data/E2-8_answers_gemma-2-2b-it.json labels_E5-2/E5-2_labels_claude.json out52.json          # E5-2(1分以内)
Gemma の答えは colab/E4-1_isa_gemma.ipynb、colab/E4-2_isa_all_gemma.ipynb(L4、E4-2 は約30分)で取りました。
参考文献
- Jiang・Lowd・Dou "Learning to Refine an Automatically Extracted Knowledge Base using Markov Logic", ICDM 2012
- Pujara ほか "Knowledge Graph Identification", ISWC 2013
- McDowell ほか "Cautious Collective Classification", JMLR 2009
- Weller "Bethe and Related Pairwise Entropy Approximations", UAI 2015
- Murphy・Weiss・Jordan "Loopy Belief Propagation for Approximate Inference: An Empirical Study", UAI 1999
- Sun ほか "Are Large Language Models a Good Replacement of Taxonomies?"(TaxoGlimpse), VLDB 2024. https://arxiv.org/abs/2406.11131
- Nikhar ほか "All-to-all reconfigurability with sparse and higher-order Ising machines", Nature Communications 2024
- Miller "WordNet: A Lexical Database for English", CACM 1995
- Gemma Team "Gemma 2: Improving Open Language Models at a Practical Size", 2024. https://arxiv.org/abs/2408.00118
- Platanios・Poon・Mitchell・Horvitz "Estimating Accuracy from Unlabeled Data: A Probabilistic Logic Approach", NeurIPS 2017. https://arxiv.org/abs/1705.07086
- Dawid・Skene "Maximum Likelihood Estimation of Observer Error-Rates Using the EM Algorithm", Applied Statistics 1979
- Zhou ほか "Batch Calibration: Rethinking Calibration for In-Context Learning and Prompt Engineering", ICLR 2024. https://arxiv.org/abs/2309.17249
- Wen ほか "Unsupervised Elicitation of Language Models", 2025. https://arxiv.org/abs/2506.10139
- Ji ほか "LLM-Hype: A Targeted Evaluation Framework for Hypernym-Hyponym Identification in Large Language Models", VLDB 2025 Workshop LLM+Graph
- Calanzone ほか "Logically Consistent Language Models via Neuro-Symbolic Integration", 2024. https://arxiv.org/abs/2409.13724
- Kassner ほか "BeliefBank: Adding Memory to a Pre-Trained Language Model for a Systematic Notion of Belief", EMNLP 2021
- Mitchell ほか "Enhancing Self-Consistency and Performance of Pre-Trained Language Models through Natural Language Inference"(ConCoRD), EMNLP 2022
- Ratner ほか "Snorkel: Rapid Training Data Creation with Weak Supervision", VLDB 2017. https://arxiv.org/abs/1711.10160
- Schriml ほか "The Human Disease Ontology 2022 update", Nucleic Acids Research 2022
一般向けの説明は note に書きました。E4-0〜E4-2:https://note.com/mst_design2020/n/nd323ba54cf92 /E4-3・正解表の見直し・E5:https://note.com/mst_design2020/n/n222a0ecf386d

Discussion