記事一覧
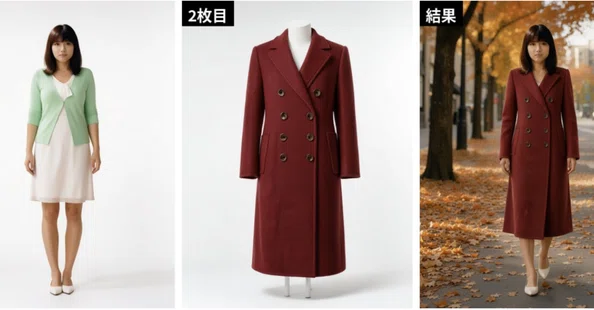
FLUX 3 Image Kleinプロンプトの書き方
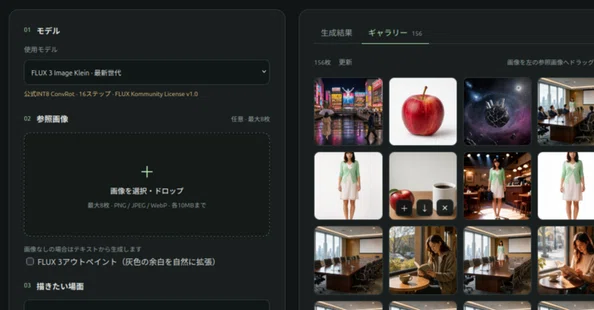
FLUX 3 Image Klein を Diffusers で 8GiB の VRAM で動かすために使っている手法をまとめ
ローカルLLMは北摂弁がわかるか? Qwen3.8-NFとGemma4-31Bの日本語力くらべ
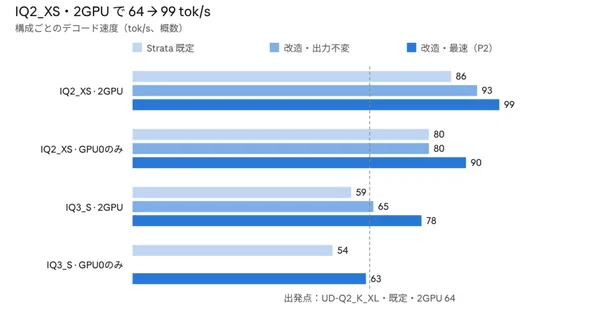
MoE推論エンジン Strata を 64→99 tok/s にした記録
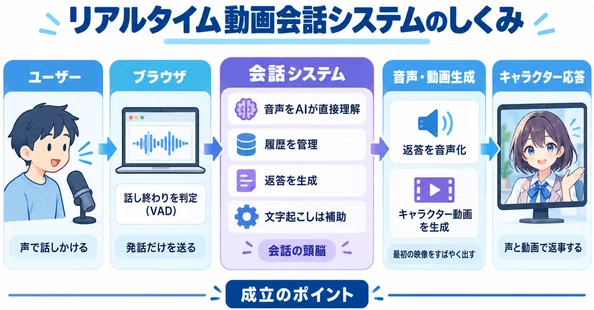
リアルタイム動画会話システムのしくみ
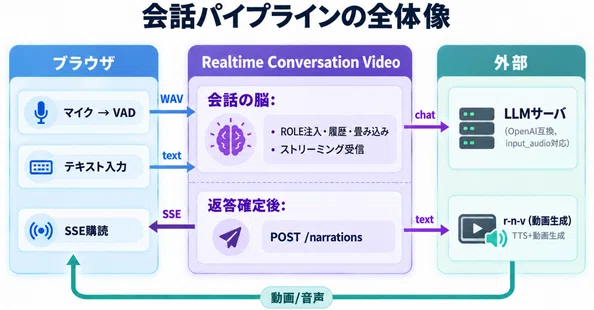
リアルタイム会話アプリのパイプライン設計詳解 — 低遅延化とKVキャッシュ
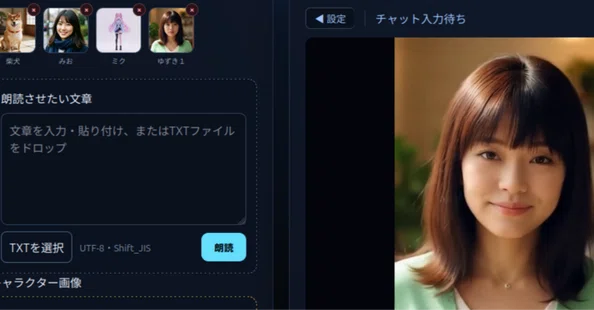
LTX2.5でリアルタイム動画、低VRAMと32GVRAM対応編
LTX-2.5を、diffusers直組みでリアルタイム化した話
生成AI推論を速くするための設計ノート
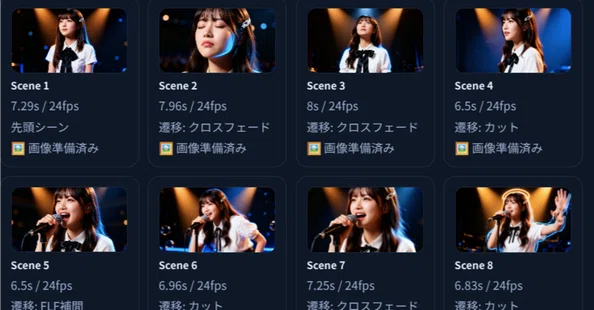
Minimax-H3のリップシンク用にボーカルを適切に分割する方法
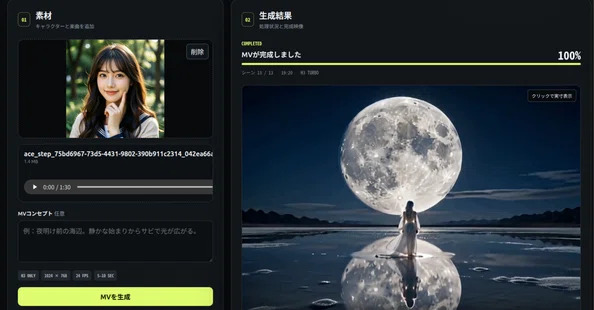
MiniMax-H3 参照画像プレフィックスキャッシュの使い方-高速化技術
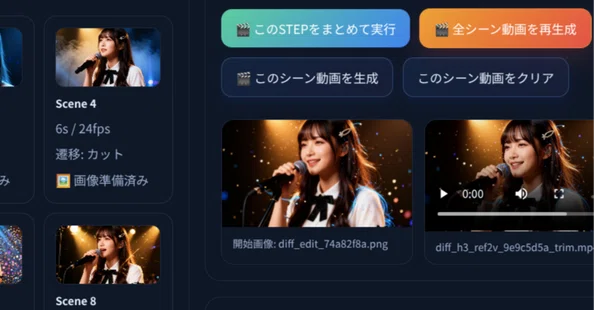
Minimax−H3の長尺音楽リップシンク手法
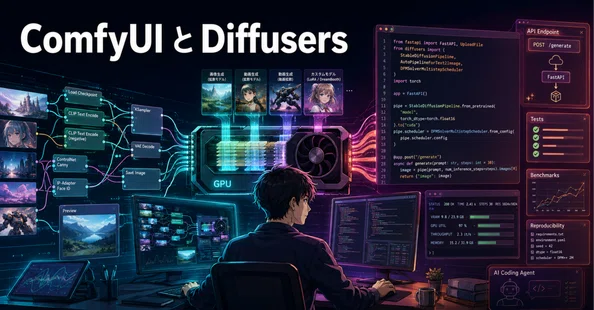
なぜ今も Diffusers なのか
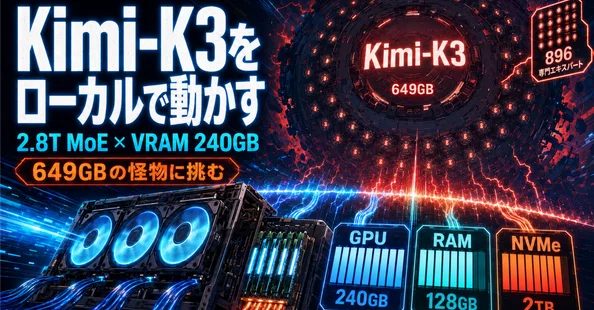
Kimi-K3(2.8T MoE)をローカルで動かす — VRAM 240GB + RAM 128GB + NVMe 2TB でどこまでいけるか
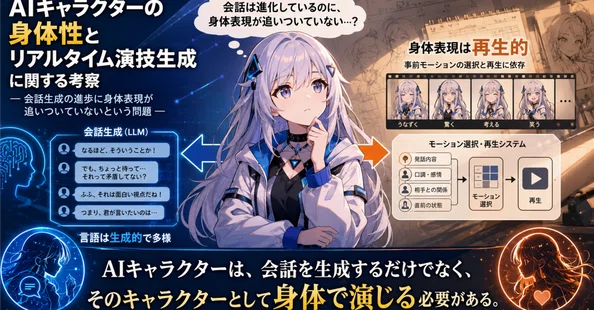
AIキャラクターの身体性とリアルタイム演技生成に関する考察
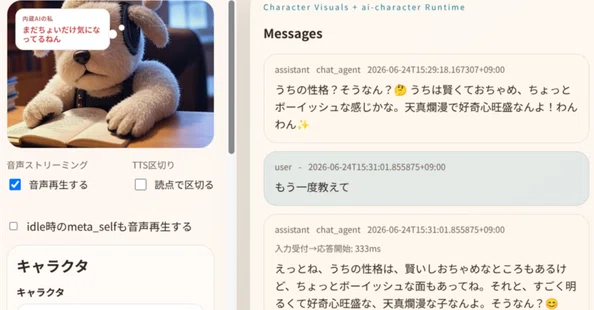
キャラクターの「物語」からBig Five性格診断を自動抽出してみた
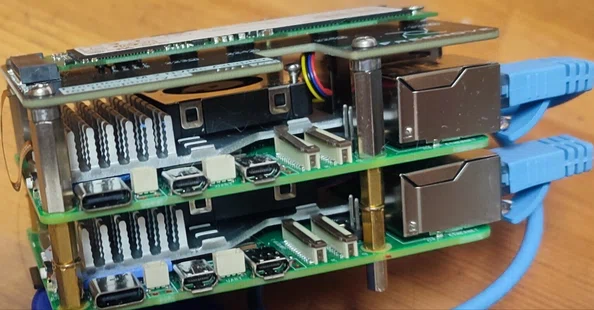
Rasberry-Pi5のCPUだけでllama.cppの性能を絞り出す方法
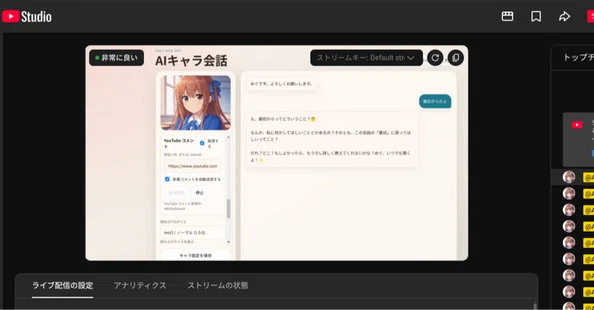
連載:AIキャラの作り方ー(Day-4)最終回
FLUX 3 Image Kleinプロンプトの書き方
FLUX 3 Image Klein を Diffusers で 8GiB の VRAM で動かすために使っている手法をまとめ
ローカルLLMは北摂弁がわかるか? Qwen3.8-NFとGemma4-31Bの日本語力くらべ
MoE推論エンジン Strata を 64→99 tok/s にした記録
リアルタイム動画会話システムのしくみ
リアルタイム会話アプリのパイプライン設計詳解 — 低遅延化とKVキャッシュ
LTX2.5でリアルタイム動画、低VRAMと32GVRAM対応編
LTX-2.5を、diffusers直組みでリアルタイム化した話
生成AI推論を速くするための設計ノート
Minimax-H3のリップシンク用にボーカルを適切に分割する方法
MiniMax-H3 参照画像プレフィックスキャッシュの使い方-高速化技術
Minimax−H3の長尺音楽リップシンク手法
なぜ今も Diffusers なのか
Kimi-K3(2.8T MoE)をローカルで動かす — VRAM 240GB + RAM 128GB + NVMe 2TB でどこまでいけるか
AIキャラクターの身体性とリアルタイム演技生成に関する考察
キャラクターの「物語」からBig Five性格診断を自動抽出してみた
Rasberry-Pi5のCPUだけでllama.cppの性能を絞り出す方法
