前回は、線形回帰をPyTorchで実装しました。今回はロジスティック回帰について解説します。
線形回帰との違いはなんでしょうか。
「回帰」という名前がついてはいますが、やっていることは「分類」になります。
ロジスティック回帰とは
二項分類
ロジスティック回帰に関しては例を紹介した方がわかりやすいでしょう。
例えば、あるメールの文章からそのメールがスパムであるかどうかを予測します。これはロジスティック回帰の問題として考えることができます。
つまり、ロジスティック回帰は、「はい」「いいえ」の答えを期待する質問に答えるのにための手法です。
他にも、クレジットカードの取引のデータからそれが詐欺かどうかを判断するのも「はい」「いいえ」の二つの可能性のどちらかを選ぶことになるのでロジスティック回帰の問題として考えることができます。
「この患者は特定の病気を持っていますか?」といった質問も同様です。
つまりは、ロジスティック回帰では、与えられたデータを二つの可能なカテゴリ(クラス、Class)のどちらか一つに分類しています。よって、問題のタイプとしては、二項分類(Binary Classification)になります。
では、二つの可能性をどのように区別して判断するのでしょうか。
確率を予測
ロジスティック回帰では、直接に「はい」「いいえ」を予測するわけではありません。ロジスティック回帰は、データを見てそれが特定のクラスに属する確率を計算します。
先ほどの例で言えば、
メールがスパムである確率
取引が詐欺である確率
患者が病気である確率
などになります。
そして、その確率が特定の閾値を超えた場合(例えば50%を超えた場合)、ロジスティック回帰はそのメールをスパム、その取引を詐欺、その患者を病気と判断します。
問題によりますが、ロジスティック回帰は、さまざまな特性(年齢、性別、購入履歴など)を考慮に入れて、これらの確率を計算します。これにより、より具体的かつ個別化された予測が可能となります。
ここからは具体的に、扱う問題を定義して解説します。
問題定義
正解データ
二つのカテゴリであればなんでも良いので、次のようなサンプルデータを考えます。
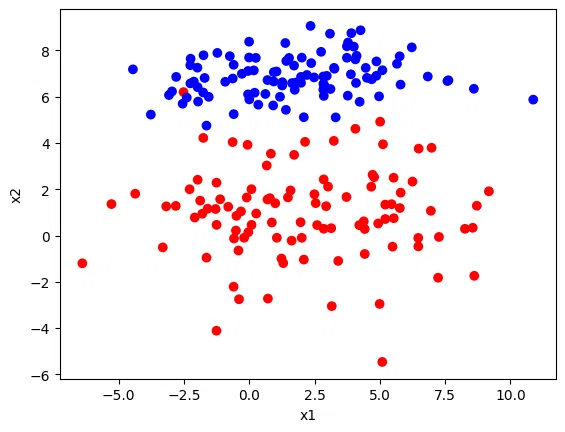
カテゴリを次のように定義します。
🔵 クラス1
🔴 クラス2
これで各点がクラス1である確率を計算できれば良いわけです。確率が50%より大きかったらクラス1であると判断していることにしましょう。
入力値と出力値
では、確率を予測するために使える情報はなんでしょうか。上図を見ると点がある位置によってクラスが分かれているようです。
そこでx1とx2による位置を入力値としてクラス1である確率を予測するとします。つまり、下図のようにクラスが分からないデータを入力値として各点のクラスを予測することになります。
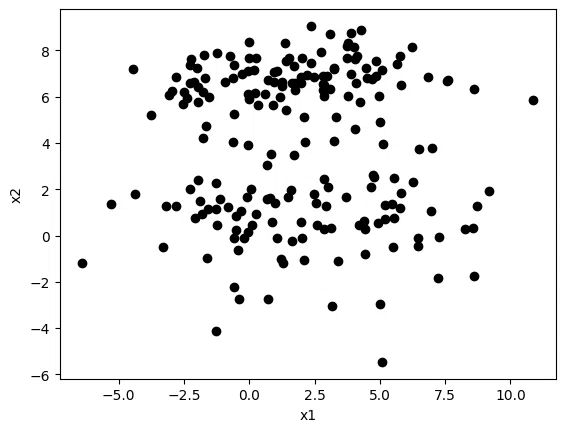
つまり、入力値(各点の位置)を入れると予測値(クラス1の確率)を出力するモデルを考えます。
入力値: x予測値: p^=[x1x2]=モデル(x)
pは確率ですが、予測値なので^を付けてp^としています。
もし、p^>0.5ならクラス1、さもなければクラス2と予測します。
では、どうすれば各点の位置からクラス1の確率を計算することができるのでしょうか。
解決アプローチ
線形回帰
この問題は線形回帰で解決できるでしょうか。
入力値: x出力値: z=[x1x2]=線形回帰モデル(x)
単純な線形回帰モデルを考えます。二つの入力値x1,x2のそれぞれに重みを掛けて足し合わせてバイアスを加えます。
それを次のように定義します。
z=Wx+b=[w1w2 ][x1x2]+b=w1x1+w2x2+b
これはPyTorchの nn.Linear を使えば計算できます。入力値が二つで出力が一つなので以下のように定義できます。
ただし、このままだと問題が生じます。
線形回帰モデルの出力zは範囲に制限のない実数なので、そのままでは確率として解釈することができません。
−∞<z<∞
つまり、問題は線形回帰モデルは任意の値を出力できるのに対し、確率の値は 0 と 1 の間に制限される必要があることです。
したがって、何らかの方法で出力zを確率に対応させる要があります。
ロジット
逆に、確率から制限の無い実数値に対応させる方法を考えてみます。
つまり、確率が高いほど、正の無限大に向かう値にマッピングします。また、確率が低いほど、負の無限大に向かう値にマッピングします。
そこでまず、オッズを考えます。オッズはクラス1の確率pに対して次のように定義します。
オッズ=1−pp
このように、オッズはクラス1の確率pとクラス1でない確率(クラス2の確率)1−pの比になっています。
クラス1のオッズは、確率pが1に近づくと正の無限大に近づきます。確率からオッズへの変換は単調であり、確率が増加するにつれてオッズも増加します。また、逆に、オッズが減少すると確率も減少することになります。
したがって、確率とオッズの間で相互に変換できます。
しかし、確率pが0に近づくとオッズも0に近づくので、このままでは確率pを無制限の実数に対応させることはできません。
そこで、オッズの自然対数を計算します。 この値をロジット(logit)と呼びます。
logit=logodds=log1−pp
この値の範囲は、負の無限大から正の無限大までになります。
これは、次のように理解できます。オッズは確率p=0.5で1となります。また、確率pが0.5より小さくなるとオッズの値は1より小さくなります。確率pが0に近づくとオッズも0に近づきます。このため、オッズの対数であるロジットは確率pが0.5より小さくなると負の無限大へと向かって減少していきます。
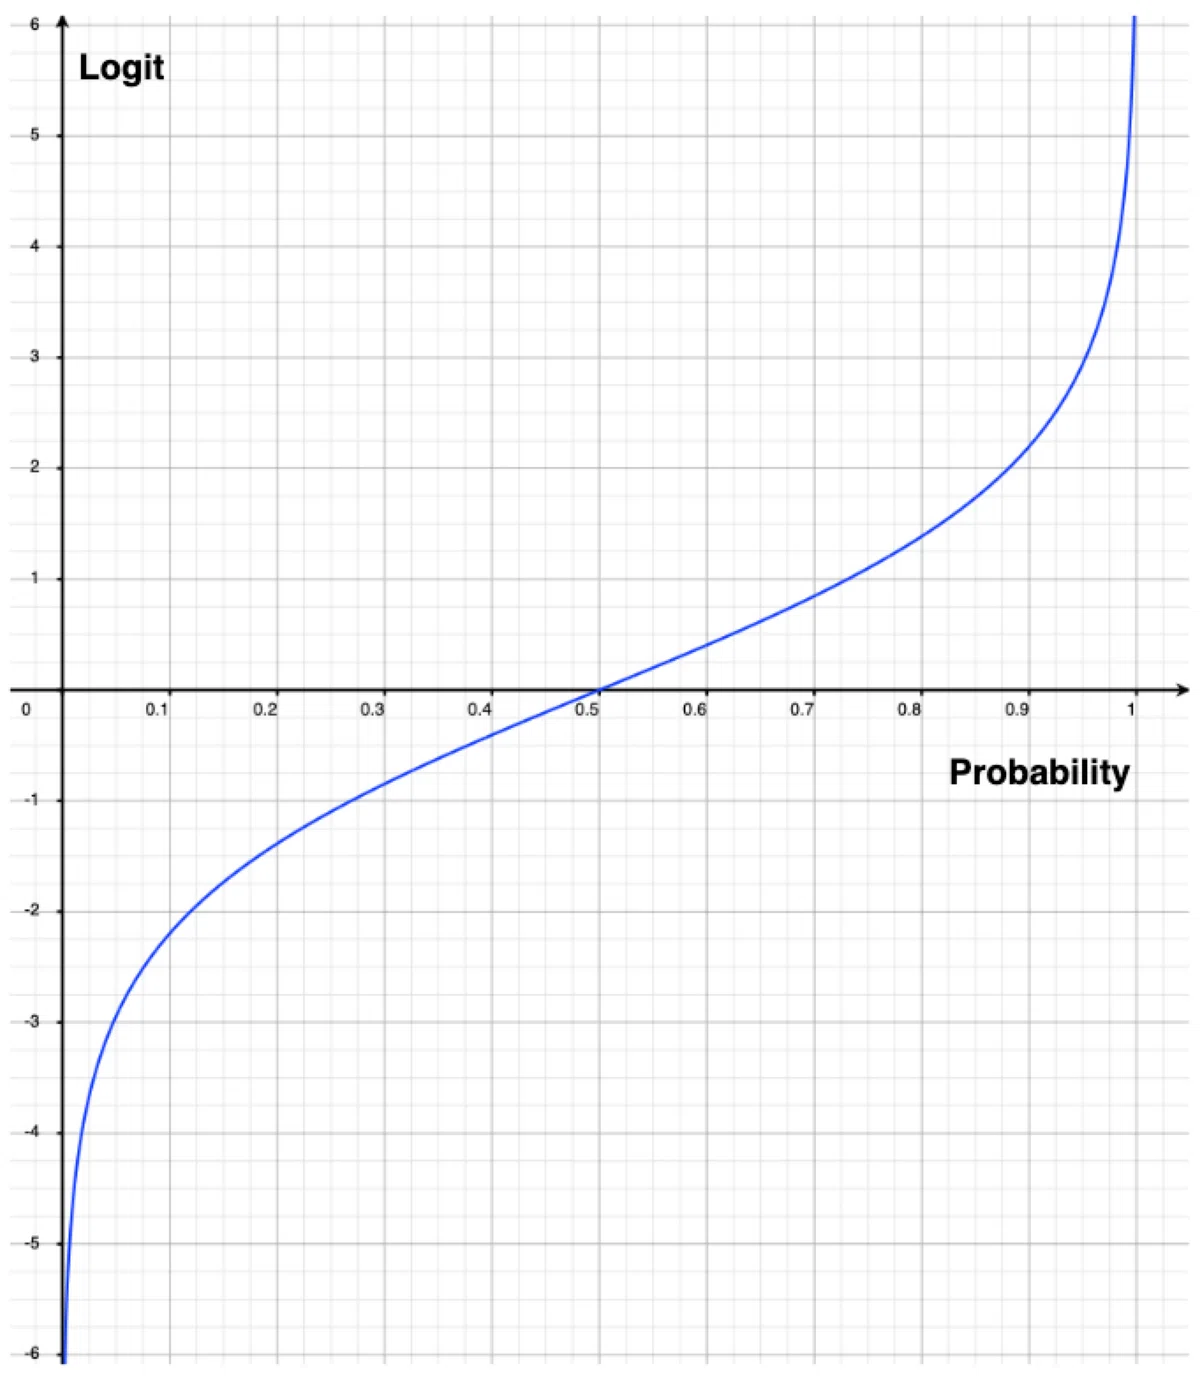 確率とロジットの関係
こうすることで確率pが0から1の値を取ると、対応するロジットは負の無限大から正の無限大の値を取ることになります。また、逆のマッピングも可能です。
よって、オッズとロジットの間の変換も単調であり、相互に変換が可能です。ということは、確率とオッズとロジットの間で相互に変換が可能となります。
つまり、線形回帰モデルからの出力zをロジットと見做せば、zから確率pへの変換が可能であることがわかります。
シグモイド
ロジットから確率への変換式を求めましょう。
線形回帰モデルからの出力zをもう一度ここに定義します。
z=Wx+b
これをロジットとみなします。ロジットは以下のように定義されていました。
logit =logodds =log1−pp
よって、
z=log 1−pp
両辺に指数関数eを適用すると、
ez= 1−pp
確率pの式として書き直すと、
p= 1+e−z1
これはロジットを確率の値にマッピングする式であり、シグモイド(Sigmoid)関数と呼びます。シグモイド関数はよくシグマσを使って表現されます。
p=σ(z)= 1+e−z1
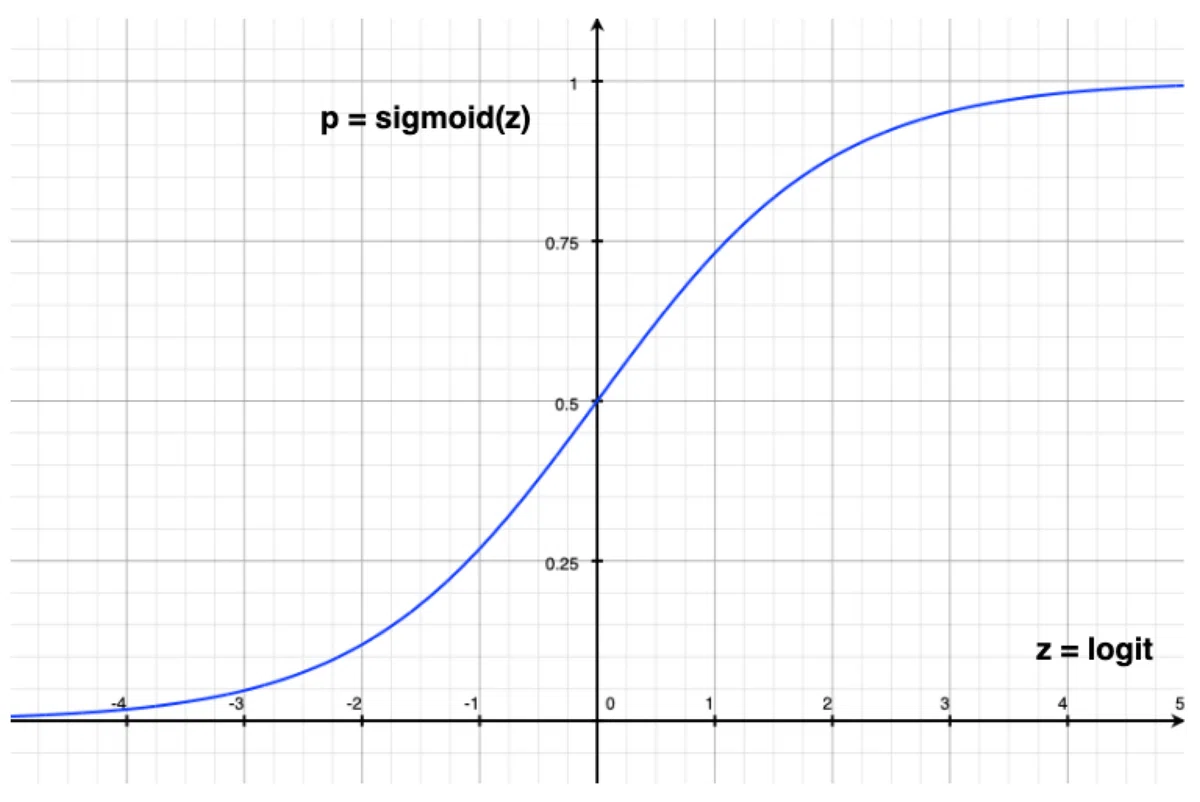
簡単にまとめると「シグモイド関数でロジットを0から1の値に圧縮する」とも言えますが、確率とオッズとロジットの関係が分かっているとより意味がはっきりします。モデルがより大きなロジットの値を予測することが、より高い確率を予測することに対応しているわけです。
また、シグモイド関数をロジスティック関数と呼ぶこともあります。よく、シグモイド関数とロジスティック関数は同じ意味で使われますが、実際にはロジスティック関数は次のように汎用な定義になっています。
f(x)=1+e−k(x−x0)L
ロジスティック関数もシグモイドと同じように上図のようなS字の曲線を描きます。ただし、L,k,x0の値によってはロジスティック関数からの出力は0から1の間に収まるとは限りませんし、中間点や曲線の傾きも変わってきます。
x0は中間点
Lはf(x)の最大値
kは曲線の傾きに影響
L=1,k=1,x0=0の場合には、ロジスティック関数はシグモイド関数になります。
PyTorchでは、nn.Sigmoid をシグモイド関数として使うことができます。
ロジスティック回帰
これまでの議論をまとめるとロジスティック回帰は線形回帰とシグモイド関数を組み合わせたモデルになります。
入力値: xロジット: zWzp^=[x1x2]=線形回帰モデル(x)=[w1w2]=Wx+b=σ(z)
これで、p^>0.5ならクラス1、さもなければクラス2と予測できます。
あとは、損失関数を決めて訓練するのみです。
損失関数
ベルヌーイ分布
二項分類は要するにコインの表が出る確率を予測するのと同じです。コインの表をクラス1とし、裏をクラス2と考えれば違いはありません。フェアなコインの場合は表・裏の確率はどちらも50%になりますが、その他の問題ではこの確率は状況により様々です。
一般に、このような二値に関する確率分布をベルヌーイ分布(Bernoulli Distribution)と呼びます。
ベルヌーイ分布は、次のように定義されます。
Ber(p^,y)=p^y(1−p^)(1−y)
ここで、y=1はクラス1、y=0はクラス2を意味します。これはケースに分けて考えるとわかりやすくなります。
Ber(p^,y)={p^1−p^ if y=1 if y=0
例えば、クラス1が60%の確率をもつベルヌーイ分布をグラフにしたら下図になります。
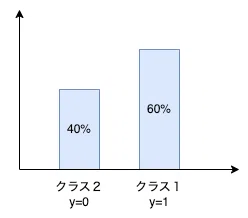
このような分布に従うデータからランダムに選んで結果を確かめることをベルヌーイ試行と呼びます。
二項分布
ベルヌーイ試行を複数回行なった結果は、二項分布に従います。二項分布の定義についてはこちらを参照してください。
例えば、ベルヌーイ試行を3回繰り返して、y1=1,y2=0,y3=1 という結果になったとします。各ベルヌーイ試行はランダムに選んだデータによるものなので、独立しています。つまり、1番目の結果が2番目の結果に影響するとことはありません。
よって、y1=1,y2=0,y3=1 という結果になった場合、その組み合わせに対する予測確率は次のように計算できます。
Ber(p1^,y1=1)×Ber(p2^,y2=0) ×Ber(p3^,y3=1)
p1^, p2^, p3^は、それぞれのベルヌーイ試行に対してモデルがクラス1を予想した確率です。
例えば、p1^=0.6, p2^=0.2, p3^=0.8だと、
Ber(p1^,y=1)×Ber(p2^,y=0) ×Ber(p3^,y=1)=0.6 ×(1−0.2)×0.8=0.384
となります。この確率が高いほど、予測の精度が良いことになります。
当然ですが、各ベルヌーイ試行に対して予測精度が高ければ全体としての予測精度が高くなります。
例えば、p1^=0.99, p2^=0.01, p3^=0.99だと、
Ber(p1^,y=1)×Ber(p2^,y=0) ×Ber(p3^,y=1)=0.99×(1−0.01)×0.99≈0.97
つまり、この値が大きくなるようにモデルが各入力値に対して正確な確率を予測できるように訓練すれば良いわけです。
バイナリクロスエントロピー
確率の値は1より小さく、また1 未満の値を何度も乗算すると非常に小さな数になったりすることがあります。コンピューターには維持できる精度に限界があるため、0になってしまう可能性があります。また、どれか一つでも正解のクラスの確率が0だと全体の確率が0になってしまいます。
よって、自然対数を取ることで掛け算を足し算に変更します。
ベルヌーイ試行をn回繰り返したとすると、
log Ber(p1^,y1)×Ber(p2^,y2)× … × Ber(pn^,yn)= log Ber(p1^,y1)+logBer(p2^,y2)+⋯+logBer(pn^,yn)=i=1∑NlogBer(pi^,yi)
機械学習の損失関数は、その値を小さくするように訓練するので、マイナスを掛けます。また、nが増えると損失値がどんどん膨らむので、平均を計算します。これをバイナリクロスエントロピー損失関数(Binary Cross-Entropy Loss)と呼びます。
BCELoss=−N1i=1∑NlogBer(pi^,yi)
この損失値が小さくなるようにモデルの訓練を行えばロジスティック回帰のモデルを最適化できることになります。
ちなみに、Ber(pi^,yi)をさらに展開すると次のようになります。
BCELoss=−N1i=1∑NlogBer(pi^,yi)=−N1i=1∑Nlogpi^yi(1−pi^)(1−yi)=−N1i=1∑N[logpi^yi+log(1−pi^)(1−yi)]=−N1i=1∑N[yilogpi^+(1−yi)log(1−pi^)]
随分と複雑に見えますが、心配ありません。PyTorchでは nn.BCELoss を使うとこの計算ができます。
次回はロジスティック回帰の実装を行います。
(続く)


