前回は、スペクトラル・クラスタリングに必要なラプラシアン行列を準備するところまで解説しました。
今回は、このラプラシアン行列を固有値分解して、クラスタリングのための特徴量を抽出するところまでを紹介します。
特に「固有値0をめぐる冒険」のセクションの解説に力を入れました。
ただし、そこまで詳細を必要としない方は、飛ばしても全体的にスペクトラル・クラスタリングの概要が理解できるように配慮しました。
ラプラシアン行列の固有値分解
ラプラシアン行列は固有値分解できる
ラプラシアン行列Lは正方行列(列数と行数が同じ)です。これは隣接行列Wがn×nあることから理解できます。また、対称行列でもあることは、ラプラシアン行列の生成方法からわかります。
一般に、対称行列は固有値と固有ベクトルによって固有値分解できます。
なお、固有値と固有ベクトルに関してはこちらで解説しています。また、固有値分解はこちらで解説しています。証明などが気になる方は参照してください。
よって、ラプラシアン行列Lを以下のように固有値分解できます。
L=QΛQ−1
ここで、Λ(大文字のラムダ)は、固有値を対角線上に並べた対角行列です。
Λ=λ10⋮00λ2⋮0……⋱…00⋮λn
この固有値の集合λ1,λ2,…,λnを固有値スペクトル(eigenvalue spectrum)と呼びます。
スペクトラル・クラスタリング(spectral clustering)は、ラプラシアン行列の固有値分解を利用して特徴量を抽出し、その特徴量を使ってクラスタリングを行う手法です。その名前は、ラプラシアン行列の「固有値スペクトル」に基づいて処理を行うことから付けられています。
また、行列Qは固有ベクトルを並べたのものです。i番目の列ベクトルは、i番目の固有値に対応しています。
Q=[v1 v2… vn]
ここで、viはi列目の列ベクトルであり、その成分を以下のように表記します。
vi=vi1vi2⋮vin
なお、固有値と固有ベクトルの関係は以下になります。
Lvi=λivi
これは固有ベクトルviを行列Lで変換すると、viがλi倍になるという意味です。つまり、固有ベクトルは、行列Lの変換における「特別な方向」を表します。また、その方向への変化の大きさが固有値です。
次に、ラプラシアン行列と固有ベクトルの関係をもう少し深掘りしていきます。
ラプラシアン行列と固有ベクトルの関係
ラプラシアン行列に限らない話ですが、任意のスカラーcと固有ベクトルviとの積(cvi)も固有ベクトルになります。
L(cvi)=cLvi=cλivi=λi(cvi)
このため、固有ベクトルをいくらでも作ることができます。つまり、ある固有値に対する固有ベクトルは無数に存在します。そこで通常は、固有ベクトルの大きさ(ノルム)が1になるように正規化します。
∥vi∥=vi12+vi22+…+vin2=1
こうすると、固有ベクトルからスカラー倍の自由度が取り除かれるので、固有ベクトルが一意に決まります。また、固有ベクトルのスケールが統一されます。
また、ラプラシアン行列Lは対称行列なので、 異なる固有ベクトルは必ず直交します。対称行列の固有値が直行することの証明はこちらにあります。
つまり、異なる固有ベクトルの内積は0になります。正規化と合わせると、固有ベクトル間の内積を次のようにまとめられます。
vi⋅vj=vi⊤vj={01(i=j)(i=j)
すると、行列Qとその対称行列Q⊤に関して、次の関係が満たされます。
QQ⊤=Q⊤Q=I
これは、Qを転置すると、その逆行列が計算できるということです。
Q⊤=Q−1
よって、行列Qは直交行列です。
ラプラシアン行列Lは対称行列である。
→ 対称行列の異なる固有ベクトルは必ず直交する。
→ 直行する固有値ベクトルを集めた行列Qは直行行列である。
以上より、固有値分解をL=QΛQ⊤と表現できます。
L=QΛQ⊤=[v1 v2… vn] λ10⋮00λ2⋮0……⋱…00⋮λn v1⊤v2⊤⋮vn⊤=λ1v1v1⊤+λ2v2v2⊤+…+λnvnvn⊤
この各項vivi⊤は行列です。
vivi⊤=vi1vi2⋮vin[vi1vi2…vin]=vi1vi1vi2vi1⋮vinvin vi1vi2 vi2vi2⋮ vinvi2……⋱… vi1vin vi2vin⋮ vinvin
これらの行列を固有値でスケールして組み合わせたのがラプラシアン行列Lです。よって、固有値と固有ベクトルはラプラシアン行列(グラフの構造)の特徴を表す上で重要です。
この関係は後でまた登場します。
次は、固有値が0になることに関して深掘りしますが、このセクションは飛ばしてもスペクトラル・クラスタリングの概要は理解できるように構成したので、飛ばしても大丈夫です。興味がある方はどうぞ。
固有値0をめぐる冒険
ラプラシアン行列において、固有値0となる固有ベクトルの数を知ると、グラフの連結に関する特徴がわかります。しかし、これを理解するにはいくつかのことを証明する必要があります。
まずは、ラプラシアン行列の固有値は必ず0以上になることを証明します。
固有値は必ず0以上になる
あるベクトルxを使って次の2次式を計算をします。
x⊤Lx= x⊤(D−W)x= x⊤Dx−x⊤Wx=i=1∑nDiixi2−i=1∑nj=1∑nWijxixj
なお、Wの対角成分はゼロ(Wii=0)なので、2行目の和はj=iとしても良いのですが、煩雑なのでそのままにしておきます。
抽象的なので3x3の行列で計算してみます。
[x1 x2 x3]D11000D22 000D33x1x2x3−[x1 x2 x3]W11W21W31W12W22W32W13W23W33x1x2x3=[x1 x2 x3]D11x1D22x2D33x3−[x1 x2 x3]W11x1+W12x2+W13x3W21x1+W22x2+W23x3W31x1+W32x2+W33x3=D11x12+D22x22+D33x32−(x1j=1∑3W1jxj+x2j=1∑3W2jxj+x3j=1∑3W3jxj)=i=1∑3Diixi2−i=1∑3j=1∑3 Wijxixj
よって、上式の関係が確認できました。
なお、Diiは、ノードiに対するエッジの重みの総和でした。
Dii=j=1∑nWij
これを使うと、上式は次のように書き換えられます。
x⊤Lx=i=1∑nDiixi2−i=1∑nj=1∑nWijxixj=i=1∑nj=1∑nWijxi2−i=1∑nj=1∑nWijxixj= i=1∑nj=1∑nWij(xi2−xixj)
このように一つにまとめると、各ij成分について考えることができます。
また、類似度グラフは無向グラフなので、ラプラシアン行列は対称行列です。よって、上式でiとjを入れ替えると、次の関係があります。
i=1∑nj=1∑nWij(xi2−xixj)=j=1∑ni=1∑nWji(xj2−xjxi)=i=1∑nj=1∑nWij(xj2−xixj)
これを利用して、次のように書き換えます。
x⊤Lx=i=1∑nj=1∑nWij(xi2−xixj)= 21(i=1∑nj=1∑nWij(xi2−xixj)+i=1∑nj=1∑nWij(xj2−xixj))=21i=1∑nj=1∑nWij(xi2−2xixj+xj2)=21i=1∑nj=1∑nWij(xi−xj)2
Wijが0以上になるカーネルを使うのが条件なので、Wij(xi−xj)2は常に0以上です。これによって、任意のベクトルxに対して、以下が成り立ちます。
x⊤Lx≥0
このような行列の性質を半正定値(Positive Semidefinite)と呼びます。任意のベクトルに対して成立するので、この性質は固有ベクトルにも当てはまります。
vi⊤Lvi= vi⊤λi vi =λi vi⊤vi= λi≥0
ここで固有値ベクトルが正規化されているものとして、vi⊤vi=∥vi∥2=1であることを利用しました。
よって、ラプラシアン行列の固有値は常に0以上であることが証明されました。
固有値0は必ず存在する
次に、ラプラシアン行列では固有値0が必ず存在することを理解します。
例えば、n×nのラプラシアン行列に対して、n個の成分を持つ定数ベクトルを考えます。
c= 11⋮1
正規化はしていませんが、正規化してもしなくとも以下の話は同じです。
ラプラシアン行列Lをこの定数ベクトルcに適用すると0になります。
Lc=(D−W) c=0
これは、Lcのi行だけに注目して、次のように示すことができます。
j=1∑n(Dij−Wij)=(j=1∑nDij−j=1∑nWij)=(Dii−Dii)=0
つまり、Lc=0⋅c=0が成り立ちます。これはどんなラプラシアン行列でも成立します。
仮に、固有値0に対応する固有ベクトルが1つだけしかない場合は、この定数ベクトルを正規化したものが、その固有ベクトルとなります。つまり、ラプラシアン行列には必ず固有値0が存在し、それに対応する固有ベクトルが少なくとも1つ存在します。
しかし、ラプラシアン行列には固有値0に対応する固有ベクトルが複数存在するものもあります。つまり、固有値0に対応する固有ベクトルが2つ以上あることになります。この場合、その固有ベクトルは定数ベクトルにはなりません。
両方とも定数ベクトルだと正規化すれば同じになってしまいます。
以上より、ラプラシアン行列には固有値0に対応する固有ベクトルが必ず1つ以上あることになります。
これについてもう少し考察します。
固有値0が意味すること
固有値0に対応する固有ベクトルをvとします。
Lv=0
vは、次のように定義しています。
v=v1v2⋮vn
よって、以下の2次式も0になります。
0=v⊤Lv=21i=1∑nj=1∑nWij(vi−vj)2
この関係は固有値0の固有ベクトルならば必ず成り立つので、各ijの組み合わせに対して少なくともWij=0か(vi−vj)2=0のどちらかが成立する必要があります。
もう少しイメージが湧くようにノード間の連結を考えます。
固有ベクトルのi番目とj番目の要素viとvjは、それぞれどこかのノードに対応した数値です。それぞれノードをノードiとノードjと呼ぶことにします。
仮に、ノードiとノードjが結合しているとするとWij>0となります。この場合、固有値0の固有ベクトルが上式を満たすためには、vi−vj=0となる必要があります。
これらの関係は、固有値が0の固有ベクトルの成分に関して成り立ちます。よって、エッジで連結しているノードに関して、固有値が0の固有ベクトルの成分が等しくなる必要があります。
もう少し具体的に、これまで簡単なグラフに当てはめてみます。
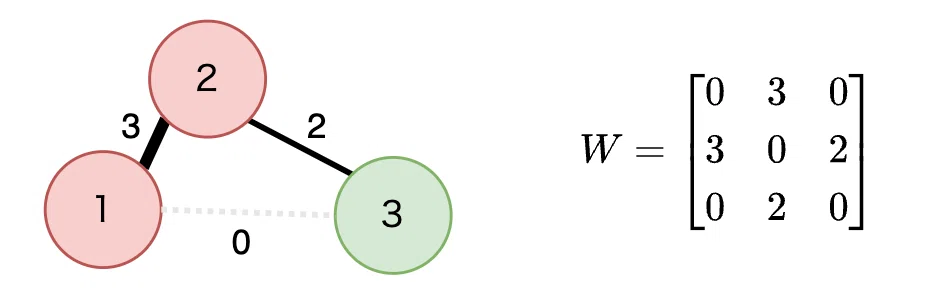
ノード1とノード2はつながっているので、W12>0です。よって、固有値が0の固有ベクトルの成分ではv1=v2が成り立ちます。
さらに、ノード2とノード3がつながっているので、W23>0です。よって、v2=v3も成立します。
つまり、このグラフでは固有値が0の固有ベクトルは定数ベクトルです。正規化したら以下になります。
v=31111
また、このグラフは全体が連結しています。
前回にも説明しましたが、連結とは「ノードが直接的か間接的につながっていること」です。あるノードからエッジをたどって到着できるノードは連結されていると考えます。
一方で、全結合は全てのノードが直接的につながっているグラフです。
つまり、グラフ全体が連結しているならば、固有値が0の固有ベクトルの成分が全てが等しくなります。これが固有ベクトルが定数ベクトルになるケースです。この場合は、固有値が0の固有ベクトルは一つだけ存在します。
複数の連結成分がある場合
グラフが2つに別れている場合、ラプラシアンは次のような構造を持ちます。
L=[LG100LG2]
ここで、LG1とLG2は、それぞれの連結成分(サブのグラフ)G1とG2のラプラシアン行列です。また、体格以外の部分は全て0です。これは、連結成分間にエッジがないためです。
そして、各連結成分の行列LG1とLG2に対して、必ず固有値0の固有ベクトルが存在します。これは、行列LG1とLG2をそれぞれ別のグラフを代表していると考えると納得できます。
簡単な例を挙げると、G1に属するノードは{1,2}、G2に属するノードは{3,4,5}とします。すると、固有値0に対応する固有ベクトルは次のようになります。ここでは正規化していません。
v1=11000,v2=00111
これらの固有ベクトルはそれぞれの連結成分を反映しています。連結しているノードに関連する成分は定数ですが、連結していないノードに関しては0になります。また、互いに直交しています。
また、これら2つの固有ベクトルを結合すると定数ベクトルになります。
c=v1+v2=11111
よって、定数ベクトルが常にLc=0を満たすこと関して矛盾していません。
以上をまとめると、固有値0には次の意味があります。
ラプラシアン行列Lの固有値が0になる固有ベクトルの数をzとすると、そのグラフにはz個の連結成分がある。
なお、固有値0の多重度(重複度)はグラフの連結成分の数に等しいのは、グラフ理論におけるラプラシアン行列の基本的な性質として扱われます。
つまり、この例のようにz=1ならば、グラフ全体が連結しています。また、z=2ならば、グラフは2つの連結成分に別れていることになります。
そして、固有値が0の固有ベクトルが2つ以上(多重度が2以上)ある場合でも、固有ベクトルは直交する異なるベクトルです。
実際に計算してみる
上例のラプラシアン行列の固有値を求めてみます。
import numpy as np

# ラプラシアン行列
L = np.array([
    [ 3, -3,  0],
    [-3,  5, -2],
    [ 0, -2,  2]
])

# 固有値と固有ベクトルを計算
eigenvalues, eigenvectors = np.linalg.eig(L)
Qを一意に決めるために、通常は固有値は大きさによって順番に並べます。「大きい値から小さい値」か「小さい値から大きい値」のどちらかになります。
実は、スペクトラル・クラスタリングでは固有値が小さいものが重要なので、ここでは固有値は小さい値から大きい値へと並べます。
λ1≤λ2≤⋯≤λn
小さい方から順番に並べて表示します。
# 固有値を昇順にソート
sorted_indices = np.argsort(eigenvalues)

# ソートした結果を使って固有値と固有ベクトルを並び替え
eigenvalues_sorted = eigenvalues[sorted_indices]
eigenvectors_sorted = eigenvectors[:, sorted_indices]

print('sorted eigenvalues:')
print(eigenvalues_sorted)
print()
print('sorted eigenvectors:')
print(eigenvectors_sorted)
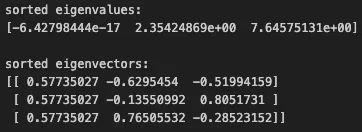
まず、固有値は次のようになりました。
λ1λ2λ3≈−6.43×10⁻¹⁷(ほぼゼロ)≈2.35≈7.65
理論的には、ラプラシアン行列の固有値は常に0以上になるのですが、コンピュータの数値計算には精度に限度があるので非常に小さな負の値になっています。これは0とみなします。
行列Qはこうなっています。数値は約しています。
Q=0.580.580.58 −0.63 −0.14 0.77 −0.52 0.81 −0.29
よって、固有ベクトルは以下になります。
v1v2v3= 0.58 0.58 0.58 (定数ベクトル)=−0.63−0.14 0.77 =−0.52 0.81−0.29
グラフ全体が連結しているので、固有値0の固有ベクトルは一つだけであり、全ての成分が等しくなっていることが確認できました。また、固有ベクトルは正規化されているので、その値は1/3≈0.58になっています。
クラスタリングとの関係
なお、クラスタリングを行う際には、固有値0に対応する固有ベクトルは、クラスタリングには不要です。グラフ全体の連結性を示すだけで、クラスタの細かい構造を反映しないからです。
連結グラフの場合:固有値0に対応する固有ベクトルは、すべての成分が等しい定数ベクトルです。この情報は「グラフ全体が連結している」ことを示すだけで、クラスタリングの目的である「ノードをグループに分ける」ための詳細な情報は含まれていません。
非連結グラフの場合:固有値0の多重度は連結成分の数に等しく、それぞれの固有ベクトルは各連結成分を表します。しかし、これも「どのノードがどの連結成分に属しているか」を示すだけで、各連結成分内の細かいクラスタリングには役立ちません。
つまり、クラスタリングの目的においては、固有値0に対応する固有ベクトルは不要な情報です。
クラスタリングを行う
特徴量はどこから来るのか
ラプラシアン行列は、固有値と固有ベクトルによって表現されました。
L=QΛQ⊤=λ1v1v1⊤+λ2v2v2⊤+…+λnvnvn⊤
ここで、固有値が0になっている項は無くなります。つまり、固有値0に対応する固有ベクトルは、グラフの特徴を表現するラプラシアン行列にとって意味がありません。よって、スペクトラル・クラスタリングでは、固有値0の固有ベクトルの情報は特長量として使われません。
そこで、クラスタリングのための特徴量は「正の固有値を持つ固有ベクトル」から獲得します。しかし、残ったすべての固有ベクトルを使うわけでもありません。
優先される固有ベクトルを必要なだけ使います。
スムーズな特徴量とは
ベクトルxがある特定の特徴量を表すとします。
x=x1x2⋮xn
この各成分は各ノードにおける特定の特徴量を数値化したものです。
特徴量ベクトルxのスムーズさを評価するために、ラプラシアン行列Lを使った2次式を考えます。
x⊤Lx=21i=1∑nj=1∑nWij(xi−xj)2
これは「固有値0をめぐる冒険」のセクションで導かれたものと同じ式です。
この2次式の値が小さいほど、特徴量ベクトルxがスムーズであることを意味します。スムーズさとは、ノード間の特徴量の差が小さく、値が滑らかに変化していることを指します。
例えば、エッジの重みWijが大きいところでは、ノードiとノードjが強く関連していますが、(xi−xj)2が小さいほどスムーズだと評価できます。
逆に、(xi−xj)2が大きいとノード間の特徴量の差が強調され、スムーズではなく、ノイズや過剰な変動を含む可能性があります。これは、クラスタリングの性能を低下させる可能性があります。
では、よりスムーズな特徴量を得るためには、どの固有ベクトルからの情報を使うべきでしょうか。
優先される固有ベクトルとは
ラプラシアン行列の固有値分解をもう一度見直します。
L=QΛQ⊤=λ1v1v1⊤+λ2v2v2⊤+…+λnvnvn⊤
この式が示しているのは、ラプラシアン行列に含まれるすべてのノードに関する情報は、固有ベクトルの組み合わせで表現されていることです。
よって、クラスタリングに必要な情報が得るには、固有ベクトルから適切に特徴量を抽出することが必要です。しかし、すべての固有ベクトルを使用すると、グラフの規模が大きい場合に次元数が増大し、計算コストが膨大になります。
ここで重要なのは、どの固有ベクトルをどれだけ使えば、クラスタリングに適した特徴量を得るのに十分なのかを決定することです。
そこで任意の特徴量ベクトルxを固有ベクトルを基底として展開してみます。
x=i=1∑ncivi
ここで、ci=vi⊤xは係数です。つまり、特徴量ベクトルxを各固有値ベクトルを軸とした空間で表現しています。
これを使ってスムーズさを評価します。
x⊤Lx=(i=1∑ncivi)⊤L(j=1∑ncjvj)=(i=1∑ncivi)⊤(j=1∑nλjcjvj)=i=1∑nj=1∑nλjcicjvi⊤vj=i=1∑nλici2
これにより、固有値が大きい成分が二次形式において支配的になり、ノード間の局所的な違いが強調されることを意味します。つまり、固有値が大きい固有ベクトルを特徴量に含めるとスムーズさが失われる可能性が高くなります。
したがって、スペクトラル・クラスタリングでは、小さい固有値に対応する固有ベクトルを優先的に使用して特徴量を抽出し、ノード間の関係性を適切に反映したクラスタリングを実現します。
特徴量ベクトルを作る
最終的にスペクトラル・クラスタリングでは、k-meansクラスタリングを使います。これによって、クラスタ数kを指定することができます。
固有値と対応する固有ベクトルを次のように想定します。
0=λ1≤λ2≤⋯≤λn,v1, v2,⋯, vn
固有値が0となる固有ベクトルは必ず1つは存在します。そこで、固有値0に対応する全ての固有ベクトルを除外します。
例えば、λ1とλ2が0だったら、固有ベクトルv1とv2は除外します。そして、残った固有ベクトルの中で、固有値が小さい方からk個の固有ベクトルv3, v4,⋯, vk+2を選択します。
スペクトラルクラスタリングでは、ノードをk個のクラスタに分割することが目的であり、k個の独立した(直行した)特徴があれば十分です。また、次元数をk個に制限することで次元削減となり、大きく複雑なグラフに対して計算コストを抑えられます。
選択した固有ベクトルを列ベクトルとしてまとめ、以下のような特徴量行列を作成します。
特徴量行列=[v3 v4… vn]=v3,1v3,2⋮v3,nv4,1v4,2⋮v4,n……⋱…vk+2,1vk+2,2⋮vk+2,n
この行列の各行が、それぞれのノードに対応する新しい特徴量ベクトルを表します。この特徴量は、ノード間の関係を低次元(k次元)で示し、類似性の計算が効率的に行えるようになります。
こうして得られた特徴量ベクトルは、固有値が小さい成分を利用して構築されており、グラフ上のスムーズな変動を捉えるため、ノード間で特徴量が似た値を持つように設計されています。これによって、グラフ全体の構造が反映されつつ、ノイズや過剰な変動が抑制されます。これがクラスタリングの精度が向上に寄与します。
最後に、この特徴量行列をk-meansクラスタリングに入力することで、ノードを k個のクラスタに分割できます。
問題が生じるケース
なお、スペクトラル・クラスタリングでは指定されたクラスタ数よりも使える固有ベクトルが少ないとクラスタリングがうまくいかない可能性があります。
例えば、グラフに連結成分が多すぎる場合には、固有値が0の固有ベクトルが増え、正の固有値を持つ固有ベクトルが指定されたクラスタ数kよりも少なくなることがあります。この場合、クラスタ数に対応する十分な次元を確保できず、クラスタリングが失敗する可能性があります。
このような場合は、最適なクラスタ数kを見つけるために、エルボー法やシルエット係数を活用すると成功するかもしれません。
また、グラフ構造を簡素化するために、不要なエッジやノードを削減する前処理を行うことが有効な場合もあります。これはノードの連結の閾値などを見直したり、孤立したノードを除外したりします。
これらの方法でも改善が難しい場合には、他のクラスタリング手法を試すことを検討する必要があるでしょう。
次回予告
次回は、scikit-learn の SpectralClustering で実験を行います。
お楽しみに!


