メインコンテンツへスキップ
見出し画像

画像生成AIの進化史⑫DDPMの生成過程

    前回は、DDPM(Denoising Diffusion Probabilistic Models)における拡散過程について、理論から実装まで詳しく解説しました。

    今回は、その続きとして、生成過程(逆拡散過程)の実装を中心に掘り下げていきます。

    特に、前回提示した「損失関数は具体的にどう実装されるのか?」という疑問に焦点を当て、理論とコードがどう対応しているのかを明らかにします。

    さらに、以下の疑問にも答えます。

    • なぜ、ガウス分布でモデル化された生成過程がノイズを削除できるのか

    • ランダムに選ばれたステップttのノイズ付き画像xt\boldsymbol{x}_tで学習する理由とは

    論文「Denoising Diffusion Probabilistic Models」(ノイズ除去 拡散確率モデル、DDPM)からの情報をもとに、PyTorchによる実装例を交えながら、DDPMの生成過程をより深くに理解していきましょう。

    拡散過程の実装のおさらい

    拡散過程からノイズも返す

    前回の記事では、DDPMにおける拡散過程(順方向のノイズ付加)の実装を紹介しました。まずは、コードを簡単に振り返ります。

    import torch
    
    # ------------------------------------------------------------
    # デバイス設定
    # ------------------------------------------------------------
    if torch.backends.mps.is_available():
        device = "mps"  # Appleシリコン
    elif torch.cuda.is_available():
        device = "cuda" # NVIDIA GPU
    else:
        device = "cpu"  # CPU
    print(f"Using device: {device}")
    
    # ------------------------------------------------------------
    # 分散スケジュール
    # ------------------------------------------------------------
    beta_1 = 1e-4
    beta_T = 0.02
    T      = 1000
    
    betas = torch.linspace(beta_1, beta_T, T).to(device)
    alphas = 1.0 - betas
    alpha_bars = torch.cumprod(alphas, dim=0)  # 累積積
    
    # ------------------------------------------------------------
    # 拡散過程 Q(x_t | x_0) からサンプリングする順方向の処理
    # ------------------------------------------------------------
    def sample_q(
        x_0: torch.Tensor,  # 画像データ(バッチ、チャンネル、高さ、幅)
        t: torch.Tensor,    # ステップ数(バッチサイズ分のテンソル)
    ):
        # 画像データx0 と同じ形状(バッチ、チャンネル、高さ、幅)のノイズを生成
        epsilon = torch.randn_like(x_0).to(device)
    
        # tに対応するalpha_barを取得(4次元テンソルに変形)
        alpha_bar_t = alpha_bars[t].view(-1, 1, 1, 1)
    
        # ノイズを加えた画像を生成
        x_t = (alpha_bar_t.sqrt() * x_0 + (1 - alpha_bar_t).sqrt() * epsilon)
    
        # ラベルとしてノイズも返す
        return x_t, epsilon

    この関数は、時刻 t において、元画像x0\boldsymbol{x}_0にガウスノイズϵ\boldsymbol{\epsilon}を加えることで、ノイズ付き画像xt\boldsymbol{x}_tをサンプリングするものです。

    拡散過程では、分散スケジュールβt\beta_tにより、ノイズはステップが進むごとに徐々に増えていき、最終的には標準正規分布に近づきます。前回は、これを理論的にそして数値的に確認しました。

    ただし、この関数は、逐次的にノイズを付加するのではなく、与えられたステップに対するノイズを付加しています。

    実は、上記のコードは前回とは違って、sample_q がノイズ付き画像 x_t と同時にノイズ epsilon も返しています。

    ここが今回の解説のポイントとなります。

    ノイズ予測モデルの訓練

    これまでは説明を簡潔にするために「生成過程は、元の画像を予測する」といった表現を使ってきました。しかし、実際に予測するのは、画像xt\boldsymbol{x}_tに含まれているノイズだけです。つまり、このノイズϵ\boldsymbol{\epsilon}を利用して元の画像x0\boldsymbol{x}_0を再構成するという仕組みになっています。

    よって、ノイズ予測モデルを訓練するための「正解ラベル」として、元の画像に付加されたノイズが必要になります。

    なお、このノイズは常に標準正規分布に従うものであり、スケジュールのステップttによって付加される割合(スケール)だけが変化します。

    そのため、ノイズ予測モデルには、ノイズが加えられた画像xt\boldsymbol{x}_tとステップttが入力として与えられます。ノイズの付加方法にはステップごとの明確な規則(スケジュール)があるため、このパターンは学習可能です。

    あとは、モデルが学習データの画像の特徴をうまく捉えられるようになれば、与えられたxt​\boldsymbol{x}_t​とttから、加えられたノイズϵ\boldsymbol{\epsilon}を予測できるようになります。

    そして、ノイズ予測モデルの出力に基づいて、段階的なサンプリングを行うことで元の画像を復元していきます。学習済みのモデルは、これを利用して画像生成を行います。

    次は、この生成過程をどのように実装していくのかを見ていきましょう。

    DDPMの訓練ループの実装

    DDPMの生成過程における学習では、ランダムに選ばれたステップttにおけるノイズ付き画像xt\boldsymbol{x}_tを入力として、元の画像x0\boldsymbol{x}_0を復元することを目指してモデルを訓練します。

    ではなぜ、ステップttをランダムに選んで学習するのでしょうか?

    これは、以下の2つ理由から合理的な設計といえます。

    逐次的な学習における問題点

    仮に、各画像に対してすべてのステップの拡散画像x1, x2,…, xT\boldsymbol{x}_1, \boldsymbol{x}_2, \ldots, \boldsymbol{x}_Tを逐次的に生成し、それぞれに対して損失を計算する方法を考えてみます。

    例えば、画像xt\boldsymbol{x}_tからxt−1\boldsymbol{x}_{t-1}を再構築するといったことをすべてのステップに対して繰り返します。

    これは一見、Transformer や RNN における系列学習に似ており、妥当な戦略に思えるかもしれません。

    しかし、拡散過程におけるステップによるシーケンスは、言語のように意味を構成するものではありません。それらはあくまでランダムなノイズによって人工的に破壊された中間状態のシーケンスです。

    拡散過程は、ランダムなマルコフ連鎖であり、一つ前のステップ以外とは関係を持たず、そこからシーケンス全体の文脈を学ぶという目的には合っていません。

    ランダムステップ学習の利点

    さらに、連続したステップの画像は非常に似ており、バッチ内に類似したデータが集中すると、勾配の方向が偏る危険性があります。これは、モデルが特定の画像データに過剰適応してしまうことを意味し、学習の不安定化や収束の遅延を招く可能性があります。

    つまり、毎バッチごとに方向が大きく異なるパラメータ更新が起きかねません。

    それに対して、ステップttをランダムに選んで学習データを構築する手法では、バッチ内の画像データに多くのバリエーションが生じると同時に、付加されているノイズ量にもバラツキが生まれます。

    よって、バッチ内の学習データの多様性を高め、勾配の方向性をより一般化されたものにし、学習の安定性と効率性の向上に寄与するというわけです。

    任意のステップから復元できることの意味
    最終ステップのノイズ画像xT\boldsymbol{x}_Tから段階的に元の画像x0\boldsymbol{x}_0を再構成ができるのであれば、任意のxt\boldsymbol{x}_tからもx0\boldsymbol{x}_0を復元できることが求められます。

    これは、任意の時点におけるノイズ量と画像の関係をモデルが学習できるべきであるという前提を意味しており、ランダムなステップから学習する手法の妥当性をさらに裏付けています。

    このような理由から、DDPMでは学習中にステップttをランダムに選び、対応するxt​\boldsymbol{x}_t​を構築して損失を計算する設計が採用されていわけです。

    PyTorchで訓練ループを実装

    DDPMの訓練では、ノイズ予測モデル(以下のコードでは model)が学習の主役となります。以下に、model が実装済みであるとして、訓練ループを示します。

    model = ....
    optimizer = torch.optim.Adam(model.parameters(), lr=2e-4)
    
    model.train()
    for epoch in range(1,epochs+1):
        for x_0, _ in dataloader:
            # 画像データをデバイスに転送
            x_0 = x_0.to(device)
    
            # ランダムなステップ t を選び、ノイズ付き画像 x_t を生成
            t = torch.randint(0, T, (x_0.size(0),), device=device)
            x_t, epsilon = sample_q(x_0, t)  # ノイズをラベルとして返す
    
            # ノイズ予測と損失計算
            noise_pred = model(x_t, t)
            loss = F.mse_loss(noise_pred, epsilon)
    
            # パラメータの更新
            optimizer.zero_grad()
            loss.backward()
            optimizer.step()
        
        print(f"Epoch {epoch}/{epochs}, Loss: {loss.item():.4f}")

    このループでは、ラベルとしてのノイズ epsilon と、モデルが予測したノイズ noise_pred の平均二乗誤差(MSE)を損失関数として使用しています。つまり、標準的な回帰タスクとして学習が行われているわけです。

    なお、論文では、model としてU-Net をベースにした構造を採用しています。

    私たちのニューラルネットワークのアーキテクチャは、PixelCNN++ のバックボーンに従っており、Wide ResNet に基づいた U-Net です。

    Our neural network architecture follows the backbone of PixelCNN++ [52], which is a U-Net [48] based on a Wide ResNet [72].

    https://arxiv.org/abs/2006.11239

    これは、UNet 構造にResNetに由来する残差ブロックを組み込んで、勾配伝播の安定性を確保したものです。このアーキテクチャの詳細は次回の記事で解説します。

    なぜガウス分布で生成できるのか

    さてこれまでに、「損失関数は具体的にどう実装されるのか?」と「ランダムに選ばれたステップttのノイズ付き画像xt\boldsymbol{x}_tで学習する理由とは」に答えてきました。

    まとめると、DDPMの生成過程は「元画像を学習する」のではなく、「ノイズを学習する」わけです。そして、学習されたノイズ予測モデルを用いて、ノイズ除去を行いながらサンプリングを実行することで、最終的に画像を復元します。

    しかし、この生成過程の「サンプリング」はどう行われるのでしょうか。

    これは、「なぜ、ガウス分布でモデル化された生成過程がノイズを削除できるのか」という疑問にも関連します。ここで再びELBOが登場します。

    既にELBOから実装したこと

    DDPMの学習の目的は変分下限(Evidence Lower Bound, ELBO)の最大化です。ELBOは次のように定義されました。

    log⁡Pθ(x0)≥Ex1:T∼Q(x1:T∣x0)[log⁡P(xT)+∑t=1Tlog⁡Pθ(xt−1∣xt)Q(xt∣xt−1)]\log P_\theta\bigl(\boldsymbol{x}_0\bigr) \ge \mathbb{E}_{\boldsymbol{x}_{1:T} \sim Q\bigl( \boldsymbol{x}_{1:T} \mid \boldsymbol{x}_0 \bigr)} \biggl[ \log P(\boldsymbol{x}_T) + \sum\limits_{t=1}^T \log \frac{P_\theta\bigl(\boldsymbol{x}_{t-1} \mid \boldsymbol{x}_t \bigr)}{Q\bigl( \boldsymbol{x}_t \mid \boldsymbol{x}_{t-1} \bigr)} \biggr]

    QQが拡散過程による確率分布で、PθP_\thetaが生成過程によるものです。PθP_\thetaにθ\thetaが付いているのは、ニューラルネットワークのパラメータ(重み、バイアスなど)の集まりを意味します。

    この式の右辺をELBOと呼び、これがモデルの対数尤度log⁡Pθ(x0)\log P_\theta\bigl(\boldsymbol{x}_0\bigr)の下限になっています。よって、ELBOを大きくする(最大化する)ことは、モデルの対数尤度log⁡Pθ(x0)\log P_\theta\bigl(\boldsymbol{x}_0\bigr)を高めることにつながります。

    つまり、Pθ(x0)P_\theta\bigl(\boldsymbol{x}_0\bigr)を高めることになり、生成モデルがデータの分布をよりよく反映していることになります。

    ここまでの実装では、ELBOの構成要素のうち、次の部分はすでに対応済みです。

    • 拡散過程Q(x1:T∣x0)Q\bigl( \boldsymbol{x}_{1:T} \mid \boldsymbol{x}_0 \bigr): sample_q() によって実装

    • 最終画像の分布⁡P(xT)⁡P(\boldsymbol{x}_T):標準正規分布仮定により定数項として処理

    • 生成過程Pθ(xt−1∣xt)P_\theta(\boldsymbol{x_{t-1}} \mid \boldsymbol{x}_t):ノイズ予測モデルを利用して実現

    一つずつ見ていきます。

    拡散過程Q(x1:T∣x0)Q\bigl( \boldsymbol{x}_{1:T} \mid \boldsymbol{x}_0 \bigr)
    上記の期待値は、拡散過程に従ってサンプリングされる変数に関するものです。

    Ex1:T∼Q(x1:T∣x0)[…]\mathbb{E}_{\boldsymbol{x}_{1:T} \sim Q\bigl( \boldsymbol{x}_{1:T} \mid \boldsymbol{x}_0 \bigr)} \bigl[ \ldots \bigr]

    つまり、拡散過程QQに従って、ステップ11からステップTTまでのノイズ付加を行う処理を使うことで得られる期待値であり、この処理はsample_q() によってすでに実装されています。

    最終画像の分布⁡P(xT)⁡P(\boldsymbol{x}_T)
    DDPMの理論では、最終的なノイズ付き画像xT\boldsymbol{x}_Tが標準正規分布に従うことが前提となっています。また、そのように拡散過程QQは実装されています。

    さらに、生成過程PθP_\thetaにおいても、標準正規分布からサンプリングされた画像xT\boldsymbol{x}_Tを出発点とするため、この仮定はすでに組み込まれています。

    生成過程Pθ(xt−1∣xt)P_\theta(\boldsymbol{x_{t-1}} \mid \boldsymbol{x}_t)
    ノイズ予測モデル(ニューラルネットワーク)は、Pθ(xt−1∣xt)P_\theta(\boldsymbol{x_{t-1}} \mid \boldsymbol{x}_t)の一部です。つまり、これは部分的に実装されていることになります。ただし、xt\boldsymbol{x}_tからxt−1\boldsymbol{x_{t-1}}サンプリングする仕組みは実装されていません。

    なお、前述したように生成過程はガウス分布でモデル化されています。

    Pθ(xt−1∣ xt)=N(xt−1;μ0(xt,t),Σθ(xt,t))P_\theta(\boldsymbol{x}_{t-1} \mid \boldsymbol{x}_{t}) = \mathcal{N} \bigl(\boldsymbol{x}_{t-1} ; \boldsymbol{\mu}_0(\boldsymbol{x}_t, t), \Sigma_\theta(\boldsymbol{x}_t, t)\bigr)

    よって、ELBOの中でPθ(xt−1∣xt)P_\theta(\boldsymbol{x_{t-1}} \mid \boldsymbol{x}_t)が関連する部分をより深く理解することは「なぜ、ガウス分布でモデル化された生成過程がノイズを削除できるのか」という疑問の答えを見つけるヒントとなるはずです。

    ELBOから損失関数を導出する

    ELBOの式を再掲します。

    ELBO=Ex1:T∼Q(x1:T∣x0)[log⁡P(xT)+∑t=1Tlog⁡Pθ(xt−1∣xt)Q(xt∣xt−1)]\text{ELBO} = \mathbb{E}_{\boldsymbol{x}_{1:T} \sim Q\bigl( \boldsymbol{x}_{1:T} \mid \boldsymbol{x}_0 \bigr)} \biggl[ \log P(\boldsymbol{x}_T) + \sum\limits_{t=1}^T \log \frac{P_\theta\bigl(\boldsymbol{x}_{t-1} \mid \boldsymbol{x}_t \bigr)}{Q\bigl( \boldsymbol{x}_t \mid \boldsymbol{x}_{t-1} \bigr)} \biggr]

    また、右辺の2項目から、生成過程Pθ(xt−1∣xt)P_\theta(\boldsymbol{x_{t-1}} \mid \boldsymbol{x}_t)と拡散過程Q(x1:T∣x0)Q\bigl( \boldsymbol{x}_{1:T} \mid \boldsymbol{x}_0 \bigr)は、以下のKLダイバージェンスで関連づけられているのがわかります。

    Ex1:T∼Q(x1:T∣x0)[∑t=1Tlog⁡Pθ(xt−1∣xt)Q(xt∣xt−1)]= Ex1:T∼Q(x1:T∣x0)[−∑t=1Tlog⁡Q(xt∣xt−1)Pθ(xt−1∣xt)]= −DKL(Q(x1:T∣x0)∥Pθ(x1:T∣x0))\begin{aligned} &\mathbb{E}_{\boldsymbol{x}_{1:T} \sim Q\bigl( \boldsymbol{x}_{1:T} \mid \boldsymbol{x}_0 \bigr)} \biggl[ \sum\limits_{t=1}^T \log \frac{P_\theta\bigl(\boldsymbol{x}_{t-1} \mid \boldsymbol{x}_t \bigr)}{Q\bigl( \boldsymbol{x}_t \mid \boldsymbol{x}_{t-1} \bigr)} \biggr] \\[3ex] =\ &\mathbb{E}_{\boldsymbol{x}_{1:T} \sim Q\bigl( \boldsymbol{x}_{1:T} \mid \boldsymbol{x}_0 \bigr)} \biggl[ -\sum\limits_{t=1}^T \log \frac{Q\bigl( \boldsymbol{x}_t \mid \boldsymbol{x}_{t-1} \bigr)}{P_\theta\bigl(\boldsymbol{x}_{t-1} \mid \boldsymbol{x}_t \bigr)} \biggr] \\[5ex] =\ &-\text{D}_{\text{KL}}\bigl(Q(\boldsymbol{x}_{1:T} \mid \boldsymbol{x}_0 \bigr) \| P_\theta\bigl( \boldsymbol{x}_{1:T} \mid \boldsymbol{x}_0 \bigr) \bigr) \end{aligned}

    KLダイバージェンスの一般式は、DKL(Q∥P)=EQ[log⁡QP]\text{D}_{\text{KL}}(Q\|P) = \mathbb{E}_Q\left[\log \frac{Q}{P} \right]です。

    よって、ELBOを最大化するには、このKLダイバージェンスを最小化する必要があります。

    DKL(Q(x1:T∣x0)∥Pθ(x1:T∣x0))=Ex1:T∼Q(x1:T∣x0)[−∑t=1Tlog⁡Pθ(xt−1∣xt)Q(xt∣xt−1)]\begin{aligned} &\text{D}_{\text{KL}}\bigl(Q(\boldsymbol{x}_{1:T} \mid \boldsymbol{x}_0 \bigr) \| P_\theta\bigl( \boldsymbol{x}_{1:T} \mid \boldsymbol{x}_0 \bigr) \bigr) \\[2ex] &= \mathbb{E}_{\boldsymbol{x}_{1:T} \sim Q\bigl( \boldsymbol{x}_{1:T} \mid \boldsymbol{x}_0 \bigr)} \biggl[ -\sum\limits_{t=1}^T \log \frac{P_\theta\bigl(\boldsymbol{x}_{t-1} \mid \boldsymbol{x}_t \bigr)}{Q\bigl( \boldsymbol{x}_t \mid \boldsymbol{x}_{t-1} \bigr)} \biggr] \end{aligned}

    これがゼロに近づくほど、順方向の拡散過程QQと逆方向の生成過程PθP_\thetaが、確率分布として似てくることになります。

    つまり、画像x0\boldsymbol{x}_0に対して、拡散過程によって得られるノイズ付加の遷移分布Q(x1:T∣x0)Q(\boldsymbol{x}_{1:T} \mid \boldsymbol{x}_0)と生成過程によって得られるノイズ除去の遷移分布Pθ(x1:T∣x0)P_\theta(\boldsymbol{x}_{1:T} \mid \boldsymbol{x}_0)が一致するように学習することが目標です。

    簡単にまとめると、拡散モデルの学習とは「ノイズを加える過程」と「ノイズを取り除く過程」による画像シーケンスの分布が同じになるように学習することです。

    DDPMではこれを、ノイズ予測モデルが「ノイズ付き画像のノイズを予測する」ことで達成されます。

    しかし、この定義式をそのまま使うと、すべてのステップt=1,…,Tt=1, \ldots,Tにおけるノイズ付きデータのサンプルを繰り返し生成して期待値を計算する必要があるため、非常に非効率で計算コストが高くなってしまいます。

    すべてのステップの期待値を計算するという点で、ボルツマンマシンのように学習が困難になります。しかし、変分オートエンコーダが単純な分布を使って効率化したように、DDPMもガウス分布を用いることでこの問題を解決しています。

    そこで、DDPMの論文では、次のようにELBOの式を変形しています。

    ELBO=EQ[log⁡P(xT)+∑t=1Tlog⁡Pθ(xt−1∣xt)Q(xt∣xt−1)]=EQ[log⁡P(xT)+∑t>1Tlog⁡Pθ(xt−1∣xt)Q(xt∣xt−1)+log⁡Pθ(x0∣x1)Q(x1∣x0) ]=EQ[log⁡P(xT)+∑t=1Tlog⁡Pθ(xt−1∣xt)Q(xt−1∣xt,x0)⋅Q(xt−1∣x0)Q(xt∣x0)+log⁡Pθ(x0∣x1)Q(x1∣x0)]=EQ[log⁡P(xT)Q(x1∣x0)+∑t=1Tlog⁡Pθ(xt−1∣xt)Q(xt−1∣xt,x0)⋅Q(xt−1∣x0)Q(xt∣x0)+log⁡Pθ(x0∣x1)]=−  DKL(Q(xT∣x0)∥Pθ(xT))−∑t>1TDKL(Q(xt−1∣xt,x0)∥Pθ(xt−1∣xt)) +EQ[log⁡Pθ(x0∣x1)]\begin{aligned} &\text{ELBO} = \mathbb{E}_{Q} \biggl[ \log P(\boldsymbol{x}_T) + \sum\limits_{t=1}^T \log \frac{P_\theta\bigl(\boldsymbol{x}_{t-1} \mid \boldsymbol{x}_t \bigr)}{Q\bigl( \boldsymbol{x}_t \mid \boldsymbol{x}_{t-1} \bigr)} \biggr] \\[2ex] &= \mathbb{E}_{Q} \biggl[ \log P(\boldsymbol{x}_T) + \sum\limits_{t>1}^T \log \frac{P_\theta\bigl(\boldsymbol{x}_{t-1} \mid \boldsymbol{x}_t \bigr)}{Q\bigl( \boldsymbol{x}_t \mid \boldsymbol{x}_{t-1} \bigr)} + \log \frac{P_\theta\bigl(\boldsymbol{x}_{0} \mid \boldsymbol{x}_1 \bigr)}{Q\bigl( \boldsymbol{x}_1 \mid \boldsymbol{x}_{0} \bigr)} \biggr] \\[3ex] &= \mathbb{E}_{Q} \biggl[ \log P(\boldsymbol{x}_T) + \sum\limits_{t=1}^T \log \frac{P_\theta\bigl(\boldsymbol{x}_{t-1} \mid \boldsymbol{x}_t \bigr)}{Q\bigl( \boldsymbol{x}_{t-1} \mid \boldsymbol{x}_{t}, \boldsymbol{x}_{0}\bigr)} \cdot \frac{Q\bigl( \boldsymbol{x}_{t-1} \mid \boldsymbol{x}_{0}\bigr)}{Q\bigl( \boldsymbol{x}_{t} \mid \boldsymbol{x}_{0}\bigr)} \\[3ex] &\qquad\quad+ \log \frac{P_\theta\bigl(\boldsymbol{x}_{0} \mid \boldsymbol{x}_1 \bigr)}{Q\bigl( \boldsymbol{x}_{1} \mid \boldsymbol{x}_{0}\bigr)} \biggr] \\[3ex] &= \mathbb{E}_{Q} \biggl[ \log \frac{P(\boldsymbol{x}_T)}{Q\bigl( \boldsymbol{x}_{1} \mid \boldsymbol{x}_{0}\bigr)} + \sum\limits_{t=1}^T \log \frac{P_\theta\bigl(\boldsymbol{x}_{t-1} \mid \boldsymbol{x}_t \bigr)}{Q\bigl( \boldsymbol{x}_{t-1} \mid \boldsymbol{x}_{t}, \boldsymbol{x}_{0}\bigr)} \cdot \frac{Q\bigl( \boldsymbol{x}_{t-1} \mid \boldsymbol{x}_{0}\bigr)}{Q\bigl( \boldsymbol{x}_{t} \mid \boldsymbol{x}_{0}\bigr)} \\[3ex] &\qquad\quad + \log P_\theta\bigl(\boldsymbol{x}_{0} \mid \boldsymbol{x}_1 \bigr) \biggr] \\[5ex] &= -\;\text{D}_{\text{KL}}\bigl(Q(\boldsymbol{x}_{T} \mid \boldsymbol{x}_0 \bigr) \| P_\theta\bigl( \boldsymbol{x}_{T} \bigr) \bigr) \\[3ex] &\qquad - \sum\limits_{t >1}^T \text{D}_{\text{KL}}\bigl(Q(\boldsymbol{x}_{t-1} \mid \boldsymbol{x}_t, \boldsymbol{x}_0 \bigr) \| P_\theta\bigl( \boldsymbol{x}_{t-1} \mid \boldsymbol{x}_t \bigr) \bigr)  \\[3ex] &\qquad+ \mathbb{E}_Q\biggl[\log P_\theta\bigl(\boldsymbol{x}_{0} \mid \boldsymbol{x}_1 \bigr) \biggr] \end{aligned}

    長くなるので、Ex1:T∼Q(x1:T∣x0)\mathbb{E}_{\boldsymbol{x}_{1:T} \sim Q\bigl( \boldsymbol{x}_{1:T} \mid \boldsymbol{x}_0 \bigr)}をEQ\mathbb{E}_Qと省略しています。

    ELBOを最大化するには、ELBOのマイナスを最小化すれば良いので、上式の各項を次のように損失として定義します。

    LT=DKL(Q(xT∣x0)∥Pθ(xT))Lt−1=DKL(Q(xt−1∣xt,x0)∥Pθ(xt−1∣xt)) (t=2…T)L0=EQ[−log⁡Pθ(x0∣x1)]\begin{aligned} \text{L}_T &= \text{D}_{\text{KL}}\bigl(Q(\boldsymbol{x}_{T} \mid \boldsymbol{x}_0 \bigr) \| P_\theta\bigl( \boldsymbol{x}_{T} \bigr) \bigr) \\[3ex] \text{L}_{t-1} &= \text{D}_{\text{KL}}\bigl(Q(\boldsymbol{x}_{t-1} \mid \boldsymbol{x}_t, \boldsymbol{x}_0 \bigr) \| P_\theta\bigl( \boldsymbol{x}_{t-1} \mid \boldsymbol{x}_t \bigr) \bigr)  \quad (t = 2 \ldots T) \\[3ex] \text{L}_0 &= \mathbb{E}_Q\biggl[-\log P_\theta\bigl(\boldsymbol{x}_{0} \mid \boldsymbol{x}_1 \bigr) \biggr] \end{aligned}

    LT\text{L}_Tは、拡散過程が画像x0\boldsymbol{x}_0から生成する最終ノイズ付き画像xT\boldsymbol{x}_Tの分布(標準正規分布を近似)と、生成過程による入力画像xT\boldsymbol{x}_Tの分布(標準正規分布を想定)が一致するほど小さくなります。これは既にカバーされています。

    L0\text{L}_0は、モデルがステップ1のノイズ付き画像x1\boldsymbol{x}_1から元の画像x0\boldsymbol{x}_0を復元できるほど大きくなります。これは、MSEによる損失関数によって最小化されます。

    Lt\text{L}_tは、拡散過程による画像x0\boldsymbol{x}_0とxt\boldsymbol{x}_tを条件とした画像xt−1\boldsymbol{x}_{t-1}の分布と、生成過程による画像xt\boldsymbol{x}_tを条件とした画像xt−1\boldsymbol{x}_{t-1}の分布が一致するほど小さくなります。

    拡散過程には決まった分散スケジュールがあるので、画像x0\boldsymbol{x}_0とxt\boldsymbol{x}_tを与えられれば、画像xt−1\boldsymbol{x}_{t-1}の分布は決まります。

    問題は、生成過程による画像xt\boldsymbol{x}_tを条件とした画像xt−1\boldsymbol{x}_{t-1}の分布です。

    これがガウス分布になっています。いよいよその理由に迫ります。

    ガウス分布で生成できる理由

    さて、生成過程がガウス分布によって画像生成をできる理由を考察しましょう。

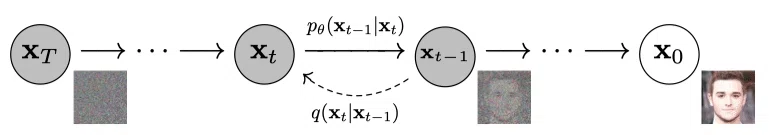
    まず、拡散過程は、以下のようにガウス過程で定義されています。

    Q(xt∣xt−1)=N(xt;1−βtxt−1,βtI)Q(\boldsymbol{x}_t \mid \boldsymbol{x}_{t-1}) = \mathcal{N} \bigl(\boldsymbol{x}_t; \sqrt{1 - \beta_t} \boldsymbol{x}_{t-1}, \beta_t \mathbf{I}\bigr)

    これは、画像に段階的にランダムノイズ(ガウスノイズ)を加えていく仕組みで、最終的にxT\boldsymbol{x}_Tは標準正規分布N(0,I)\mathcal{N}(\boldsymbol{0}, \mathbf{I})に近づきます。

    xt\boldsymbol{x}_tを条件として、xt−1\boldsymbol{x}_{t-1}を確率的に決める式です。マルコフ連鎖に従って、xt\boldsymbol{x}_tの各ピクセルを1−βt\sqrt{1 - \beta_t}でスケールしたものを平均、βt\beta_tを分散としたガウス分布からサンプリングしています。

    画像

    この逆過程である生成過程Pθ(xt−1∣ xt)P_\theta\bigl(\boldsymbol{x}_{t-1} \mid \boldsymbol{x}_t\bigr)が、ガウス分布になっているのは納得感はあります。

    実は、数学的に「順方向の遷移がすべてガウスで構成されているなら、逆方向の条件付き分布もガウス分布として記述が可能」になっています。

    なぜなら、ガウス関数は指数関数の形をしており、その積もガウス関数になります。よって、条件付き確率がガウス関数であるならば、それをひっくり返したものもガウス関数になります。

    先程の損失Lt−1L_{t-1}にあるQQを使う以下のように表現できます。

    Q(xt,xt−1,x0)=Q(xt∣xt−1,x0)Q(xt−1,x0)= Q(xt−1∣xt,x0)Q(xt,x0)\begin{aligned} Q(\boldsymbol{x}_t, \boldsymbol{x}_{t-1}, \boldsymbol{x}_0) &= Q(\boldsymbol{x}_t \mid \boldsymbol{x}_{t-1}, \boldsymbol{x}_0)Q(\boldsymbol{x}_{t-1}, \boldsymbol{x}_0) \\[2ex] &= Q(\boldsymbol{x}_{t-1} \mid \boldsymbol{x}_{t}, \boldsymbol{x}_0)Q(\boldsymbol{x}_{t}, \boldsymbol{x}_0) \end{aligned}

    よって、次の関係が成り立ちます。

    Q(xt∣xt−1,x0)=Q(xt−1∣xt,x0)Q(xt,x0)Q(xt−1,x0)Q(\boldsymbol{x}_t \mid \boldsymbol{x}_{t-1}, \boldsymbol{x}_0) = \frac{Q(\boldsymbol{x}_{t-1} \mid \boldsymbol{x}_{t}, \boldsymbol{x}_0)Q(\boldsymbol{x}_{t}, \boldsymbol{x}_0)}{Q(\boldsymbol{x}_{t-1}, \boldsymbol{x}_0)}

    ベイズ定理の導出と同じ考え方です。

    Q(xt∣xt−1,x0)Q(\boldsymbol{x}_t \mid \boldsymbol{x}_{t-1}, \boldsymbol{x}_0)には、x0\boldsymbol{x}_0が条件として含まれてはいますが、拡散過程はマルコフ遷移なのでQ(xt∣xt−1,x0)=Q(xt∣xt−1)Q(\boldsymbol{x}_t \mid \boldsymbol{x}_{t-1}, \boldsymbol{x}_0) = Q(\boldsymbol{x}_t \mid \boldsymbol{x}_{t-1})です。これは上述したようにガウス分布として定義されています。

    また、Q(xt,x0)=Q(xt∣x0) Q(x0)Q(\boldsymbol{x}_{t}, \boldsymbol{x}_0) = Q(\boldsymbol{x}_{t} \mid \boldsymbol{x}_0) Q(\boldsymbol{x}_0)とQ(xt−1,x0)=Q(xt−1∣x0) Q(x0)Q(\boldsymbol{x}_{t-1}, \boldsymbol{x}_0) = Q(\boldsymbol{x}_{t-1} \mid \boldsymbol{x}_0) Q(\boldsymbol{x}_0)より、分母と分子でQ(x0)Q(\boldsymbol{x}_0)が消えます。

    よって、上式は以下になります。

    Q(xt∣xt−1)=Q(xt−1∣xt,x0)Q(xt∣x0)Q(xt−1∣x0)Q(\boldsymbol{x}_t \mid \boldsymbol{x}_{t-1}) = \frac{Q(\boldsymbol{x}_{t-1} \mid \boldsymbol{x}_{t}, \boldsymbol{x}_0)Q(\boldsymbol{x}_{t} \mid \boldsymbol{x}_0)}{Q(\boldsymbol{x}_{t-1} \mid \boldsymbol{x}_0)}

    Q(xt−1∣x0)Q(\boldsymbol{x}_{t-1} \mid \boldsymbol{x}_0)とQ(xt∣x0)Q(\boldsymbol{x}_{t} \mid \boldsymbol{x}_0)は、x0\boldsymbol{x}_0を条件としてステップttにおけるノイズ付き画像xt\boldsymbol{x}_tの確率なので、これらもガウス分布です。

    まさに拡散過程の実装どおりです。

    よって、拡散過程の逆方向の条件確率Q(xt−1∣xt,x0)Q(\boldsymbol{x}_{t-1} \mid \boldsymbol{x}_t, \boldsymbol{x}_0)もガウス分布になることが分かります。また、これは損失Lt−1\text{L}_{t-1}にも登場していました。

    Lt−1=DKL(Q(xt−1∣xt,x0)∥Pθ(xt−1∣xt)) (t=2…T)\text{L}_{t-1} = \text{D}_{\text{KL}}\bigl(Q(\boldsymbol{x}_{t-1} \mid \boldsymbol{x}_t, \boldsymbol{x}_0 \bigr) \| P_\theta\bigl( \boldsymbol{x}_{t-1} \mid \boldsymbol{x}_t \bigr) \bigr)  \quad (t = 2 \ldots T)

    つまり、Pθ(xt−1∣xt)P_\theta(\boldsymbol{x}_{t-1} \mid \boldsymbol{x}_t)はこのQ(xt−1∣xt,x0)Q(\boldsymbol{x}_{t-1} \mid \boldsymbol{x}_t, \boldsymbol{x}_0 )をニューラルネットワークであるノイズ予測モデルを利用して近似しているわけです。

    これが生成過程の確率分布がガウス分布になっている理論的な理由です。

    なぜサンプリングするのか

    論文では、生成過程のステップttにおける生成過程の確率は、次のようにガウス分布でモデル化されています。

    Pθ(xt−1∣ xt)=N(xt−1;μθ(xt,t),Σθ(xt,t)) P_\theta\bigl(\boldsymbol{x}_{t-1} \mid \boldsymbol{x}_t\bigr) = \mathcal{N}\bigl(\boldsymbol{x}_{t-1}; \boldsymbol{\mu}_\theta(\boldsymbol{x}_{t}, t), \Sigma_\theta(\boldsymbol{x}_{t}, t) \bigr)  

    このガウス分布では、画像xt\boldsymbol{x}_tとステップttを条件として、画像xt−1\boldsymbol{x}_{t-1}の平均μθ(xt,t)\boldsymbol{\mu}_\theta(\boldsymbol{x}_{t}, t)と分散Σθ(xt,t)\Sigma_\theta(\boldsymbol{x}_{t}, t)を予測しています。これらのパラメータに従ってサンプリングしたものが具体的な画像xt−1\boldsymbol{x}_{t-1}になるわけです。

    ではなぜこの分布からサンプリングする必要があるのでしょうか?

    一見すると、「画像のノイズを取り除く」目的なら、平均μθ\boldsymbol{\mu}_\thetaをそのまま使えばよさそうに思えます。しかし、実際にはそうしてしまうと「確率的な生成モデル」にはなりません。

    拡散モデルの本質的な目的は、画像のノイズ除去ではなく、元画像の分布(データ分布)からのサンプリングです。

    この画像生成AIのシリーズでは、これまでいろいろな生成モデルを見てきましたが、共通するのは「画像生成は決定的なマッピングではなく、学習データの分布からのサンプリング」だということです。

    拡散モデルDDPMは、元画像が属する真の分布P(x0)P(\boldsymbol{x}_0)を近似するモデルPθ(x0)P_\theta(\boldsymbol{x}_0)を構築しています。

    このモデルは、完全なノイズxT\boldsymbol{x}_Tから始めて、逆拡散ステップをランダムにサンプリングしながら進めるという手続きによって、多様性のある画像サンプルを生成するのが目的です。

    仮に毎ステップでxt−1=μθ(xt,t)\boldsymbol{x}_{t−1} = \boldsymbol{\mu}_\theta(\boldsymbol{x}_t, t)として決定的に使ってしまうと、生成される画像はいつも同じになります。これでは分布からのサンプリングではなく、単なる決定的なマッピングになってしまい、生成モデルとしての意義を失います。

    生成モデルは、「正解の1枚の画像」だけでなく、「正解とみなせる多様な画像の集合」から適切にランダム性をもって選ぶことが求められます。

    そのために、ネットワークは「もっともらしい画像の平均と、その周辺の分布の形(分散)」を学習・予測し、その上で確率的に画像を1枚ずつ選んでいくというわけです。

    この確率的な選択こそがサンプリングであり、それが画像生成に不可欠なステップとなっています。

    生成過程(サンプリング)の実装

    ここでは、生成過程が行うガウス分布からのサンプリング(生成、推論)の実装を行います。まずは、そのための平均と分散の計算を導出します。

    サンプリングの平均と分散

    では生成過程のガウス分布の平均と分散の計算を導出します。

    Pθ(xt−1∣ xt)=N(xt−1;μθ(xt,t),Σθ(xt,t)) P_\theta\bigl(\boldsymbol{x}_{t-1} \mid \boldsymbol{x}_t\bigr) = \mathcal{N}\bigl(\boldsymbol{x}_{t-1}; \boldsymbol{\mu}_\theta(\boldsymbol{x}_{t}, t), \Sigma_\theta(\boldsymbol{x}_{t}, t) \bigr)  

    Pθ(xt−1∣xt)P_\theta(\boldsymbol{x}_{t-1} \mid \boldsymbol{x}_{t})が近似する逆過程の条件付き分布Q(xt−1∣xt,x0)Q(\boldsymbol{x}_{t-1} \mid \boldsymbol{x}_{t}, \boldsymbol{x}_0)を求めます。これは、上述した式から、以下のように表現できます。

    Q(xt−1∣xt,x0)= Q(xt∣xt−1,x0)Q(xt−1∣x0)Q(xt∣x0)Q(\boldsymbol{x}_{t-1} \mid \boldsymbol{x}_{t}, \boldsymbol{x}_0) =  \frac{Q(\boldsymbol{x}_t \mid \boldsymbol{x}_{t-1}, \boldsymbol{x}_0)Q(\boldsymbol{x}_{t-1} \mid \boldsymbol{x}_0)}{Q(\boldsymbol{x}_{t} \mid \boldsymbol{x}_0)}

    また、拡散過程のガウス分布の定義から以下がわかります。

    Q(xt∣xt−1)=N(xt;αtxt−1,βI)Q(\boldsymbol{x}_t \mid \boldsymbol{x}_{t-1}) = \mathcal{N}(\boldsymbol{x}_t; \sqrt{\alpha_t} \boldsymbol{x}_{t-1}, \beta \mathbf{I})

    ここで、αt=1−βt\alpha_t = 1 - \beta_tです。

    また、Q(xt∣x0)Q(\boldsymbol{x}_{t} \mid \boldsymbol{x}_{0})は、x0\boldsymbol{x}_0からttステップへ拡散させた結果です。これも前回解説しました。

    Q(xt∣x0)=N(xt;αˉtx0,(1−αˉt)I)Q(\boldsymbol{x}_{t} \mid \boldsymbol{x}_{0}) = \mathcal{N}(\boldsymbol{x}_t; \sqrt{\bar{\alpha}_{t}} \boldsymbol{x}_{0}, (1 - \bar{\alpha}_{t}) \mathbf{I})

    ここで、αˉt=∏s=1tαt\bar{\alpha}_t = \prod\limits_{s=1}^t \alpha_tです。

    同様に、Q(xt−1∣x0)Q(\boldsymbol{x}_{t-1} \mid \boldsymbol{x}_{0})は、x0\boldsymbol{x}_0からt−1t-1ステップへ拡散させた結果です。

    Q(xt−1∣x0)=N(xt−1;αˉt−1x0,(1−αˉt−1)I)Q(\boldsymbol{x}_{t-1} \mid \boldsymbol{x}_{0}) = \mathcal{N}(\boldsymbol{x}_{t-1}; \sqrt{\bar{\alpha}_{t-1}} \boldsymbol{x}_{0}, (1 - \bar{\alpha}_{t-1}) \mathbf{I})

    以上のガウス分布の式から、Q(xt−1∣xt,x0)Q(\boldsymbol{x}_{t-1} \mid \boldsymbol{x}_{t}, \boldsymbol{x}_0)は次の形になります。

    Q(xt−1∣xt,x0)=N(xt−1;μ~t(xt,x0),β~tI)Q(\boldsymbol{x}_{t-1} \mid \boldsymbol{x}_{t}, \boldsymbol{x}_0) = \mathcal{N}(\boldsymbol{x}_{t-1}; \tilde{\boldsymbol{\mu}}_t(\boldsymbol{x}_t, \boldsymbol{x}_0), \tilde{\beta}_t \mathbf{I})

    ガウス分布は指数関数なので、指数部分を二次式として整理できます。そして、こちらの記事の導出から、μ~t(xt,x0)\tilde{\boldsymbol{\mu}}_t(\boldsymbol{x}_t, \boldsymbol{x}_0)とβ~t\tilde{\beta}_tは、次のようになります。

    μ~t(xt,x0)=αt(1−αˉt−1)1−αˉtxt+αˉt−1βt1−αˉtx0 β~t=1−αˉt−11−αˉtβt\begin{aligned} \tilde{\boldsymbol{\mu}}_t(\boldsymbol{x}_t, \boldsymbol{x}_0) &= \frac{\sqrt{\alpha_{t}}(1 - \bar{\alpha}_{t-1})}{1 - \bar{\alpha}_t}\boldsymbol{x}_t + \frac{\sqrt{\bar{\alpha}_{t-1}}\beta_t}{1 - \bar{\alpha}_t} \boldsymbol{x}_0   \\[2ex] \tilde{\beta}_t &= \frac{1 - \bar{\alpha}_{t-1}}{1 - \bar{\alpha}_t} \beta_t \end{aligned}

    ただし、このμ~t(xt,x0)\tilde{\boldsymbol{\mu}}_t(\boldsymbol{x}_t, \boldsymbol{x}_0)は、元のデータx0\boldsymbol{x}_0​が既知である場合の逆過程の平均です。しかし、実際に生成を行う際にはx0\boldsymbol{x}_0​は未知です。

    そこで、前回の記事からの拡散過程の定義を利用します。

    xt=αˉtx0+1−αˉtϵ\boldsymbol{x}_t = \sqrt{\bar{\alpha}_t} \boldsymbol{x}_0 + \sqrt{1 - \bar{\alpha}_t} \boldsymbol{\epsilon}

    ϵ∼N(0,I)\boldsymbol{\epsilon} \sim \mathcal{N}(\boldsymbol{0}, \mathbf{I})です。

    この式をx0\boldsymbol{x}_0の式として書き直します。

    x0= 1αˉt(xt−1−αˉtϵ)\boldsymbol{x}_0 =  \frac{1}{\sqrt{\bar{\alpha}_t}} \biggl(\boldsymbol{x}_t - \sqrt{1 - \bar{\alpha}_t} \boldsymbol{\epsilon} \biggr)

    これは、与えられた画像xt\boldsymbol{x}_tとそこに含まれるノイズϵ\boldsymbol{\epsilon}から、x0\boldsymbol{x}_0が計算できることを示しています。よって、これを平均の式に代入すればμ~t(xt,x0)= μ~t(xt)\tilde{\boldsymbol{\mu}}_t(\boldsymbol{x}_t, \boldsymbol{x}_0) = \tilde{\boldsymbol{\mu}}_t(\boldsymbol{x}_t)となります。

    μ~t(xt)=αt(1−αˉt−1)1−αˉtxt+αˉt−1βt1−αˉt1αˉt(xt−1−αˉtϵ)=αˉtαt(1−αˉt−1)+αˉt−1βtαˉt(1−αˉt)xt− αˉt−1βtαˉt(1−αˉt)1−αˉtϵ\begin{aligned} \tilde{\boldsymbol{\mu}}_t(\boldsymbol{x}_t) &= \frac{\sqrt{\alpha_{t}}(1 - \bar{\alpha}_{t-1})}{1 - \bar{\alpha}_t}\boldsymbol{x}_t + \frac{\sqrt{\bar{\alpha}_{t-1}}\beta_t}{1 - \bar{\alpha}_t} \frac{1}{\sqrt{\bar{\alpha}_t}} \biggl(\boldsymbol{x}_t - \sqrt{1 - \bar{\alpha}_t} \boldsymbol{\epsilon} \biggr) \\[2ex] &= \frac{\sqrt{\bar{\alpha}_t}\sqrt{\alpha_{t}}(1 - \bar{\alpha}_{t-1}) + \sqrt{\bar{\alpha}_{t-1}}\beta_t}{\sqrt{\bar{\alpha}_t}(1 - \bar{\alpha}_t)}\boldsymbol{x}_t -  \frac{\sqrt{\bar{\alpha}_{t-1}}\beta_t}{\sqrt{\bar{\alpha}_t}(1 - \bar{\alpha}_t)} \sqrt{1 - \bar{\alpha}_t} \boldsymbol{\epsilon} \end{aligned}

    αˉt−1\bar{\alpha}_{t-1}があるのが厄介ですが、αˉt=∏s=1tαt\bar{\alpha}_t = \prod\limits_{s=1}^t \alpha_tよりαˉt−1=αˉtαt\bar{\alpha}_{t-1} = \frac{\bar{\alpha}_t}{\alpha_t}となるので、これを代入してカッコの中身を整理します。

    μ~t(xt)=αˉtαt(1−αˉtαt)+αˉtαtβtαˉt(1−αˉt)xt− αˉtαtβtαˉt(1−αˉt)1−αˉtϵ=αt−αˉt+βtαt(1−αˉt)xt− βtαt1−αˉtϵ=1−αˉtαt(1−αˉt)xt− βtαt1−αˉtϵ=1αt(xt− βt1−αˉtϵ)\begin{aligned} \tilde{\boldsymbol{\mu}}_t(\boldsymbol{x}_t) &= \frac{\sqrt{\bar{\alpha}_t}\sqrt{\alpha_{t}}(1 - \frac{\bar{\alpha}_t}{\alpha_t}) + \sqrt{\frac{\bar{\alpha}_t}{\alpha_t}}\beta_t}{\sqrt{\bar{\alpha}_t}(1 - \bar{\alpha}_t)}\boldsymbol{x}_t -  \frac{\sqrt{\frac{\bar{\alpha}_t}{\alpha_t}}\beta_t}{\sqrt{\bar{\alpha}_t}(1 - \bar{\alpha}_t)} \sqrt{1 - \bar{\alpha}_t} \boldsymbol{\epsilon} \\[2ex] &= \frac{\alpha_{t} - \bar{\alpha}_t + \beta_t}{\sqrt{\alpha_t}(1 - \bar{\alpha}_t)}\boldsymbol{x}_t -  \frac{\beta_t}{\sqrt{\alpha_t}\sqrt{1 - \bar{\alpha}_t}} \boldsymbol{\epsilon} \\[2ex] &= \frac{1 - \bar{\alpha}_t}{\sqrt{\alpha_t}(1 - \bar{\alpha}_t)}\boldsymbol{x}_t -  \frac{\beta_t}{\sqrt{\alpha_t}\sqrt{1 - \bar{\alpha}_t}} \boldsymbol{\epsilon} \\[2ex] &= \frac{1}{\sqrt{\alpha_t}}\left( \boldsymbol{x}_t -  \frac{\beta_t}{\sqrt{1 - \bar{\alpha}_t}} \boldsymbol{\epsilon} \right) \end{aligned}

    なお、第1項の変形ではβt= 1−αt\beta_t = 1 - \alpha_tであることも利用しました。

    これは全て分散スケジュールから計算できる値です。以上より、ノイズ予測モデルが、ϵ\boldsymbol{\epsilon}を正確に予測できれば、x0\boldsymbol{x}_0を介さずともxt\boldsymbol{x}_tからxt−1\boldsymbol{x}_{t-1}をサンプリングするための平均を計算ができることが理論的に証明されました。

    あとは、これを実装に落とし込むだけです。

    理論から実装における近似

    論文では次のように書かれています。

    実験的には、σt2=βt\sigma_t^2 = \beta_tとσt2=βt~=1−αˉt−11−αˉtβt\sigma_t^2 = \tilde{\beta_t} = \frac{1 - \bar{\alpha}_{t-1}}{1 - \bar{\alpha}_t}\beta_tのどちらを用いても、ほぼ同様の結果が得られました。

    Experimentally, both σt2=βt\sigma_t^2 = \beta_t and  σt2=βt~=1−αˉt−11−αˉtβt\sigma_t^2 = \tilde{\beta_t} = \frac{1 - \bar{\alpha}_{t-1}}{1 - \bar{\alpha}_t}\beta_t had similar results.

    つまり、生成過程のサンプリングにおけるガウス分布の分散は、拡散過程の分散βt\beta_tをそのまま近似として使えるということです。

    ノイズ予測モデルをϵθ(xt,t)\boldsymbol{\epsilon}_\theta(\boldsymbol{x}_t , t)と表現すると、生成過程の実装は以下の式をコード化するだけです。

    μ~θ(xt,t)≈1αt(xt− βt1−αˉtϵθ(xt,t))β~t≈βt\begin{aligned} \tilde{\boldsymbol{\mu}}_\theta(\boldsymbol{x}_t, t) &\approx \frac{1}{\sqrt{\alpha_t}}\left( \boldsymbol{x}_t -  \frac{\beta_t}{\sqrt{1 - \bar{\alpha}_t}} \boldsymbol{\epsilon}_\theta(\boldsymbol{x}_t , t) \right) \\[3ex] \tilde{\beta}_t &\approx \beta_t \end{aligned}

    これは、xt\boldsymbol{x}_tから予測されたノイズϵθ(xt,t)\boldsymbol{\epsilon}_\theta(\boldsymbol{x}_t, t)を取り除くことで、xt−1\boldsymbol{x}_{t-1}をサンプリングするための平均画像を計算しています。

    これは次のようにPyTorchで実装できます。

    # ------------------------------------------------------------
    # 生成過程 P_θ(x_{t-1} | x_t) からサンプリングする逆方向の処理
    # ------------------------------------------------------------
    def sample_p(
        x_t: torch.Tensor,  # ノイズ付き画像(バッチ、チャンネル、高さ、幅)
        t: torch.Tensor,    # ステップ数(バッチサイズ分のテンソル)
        noise_pred: torch.Tensor  # モデルによるノイズ予測(バッチ、チャンネル、高さ、幅)
    ):
        # tに対応するalpha_barとbetaを取得(4次元テンソルに変形)
        beta = betas[t].view(-1, 1, 1, 1)
        alpha = alphas[t].view(-1, 1, 1, 1)
        s1_ab = torch.sqrt(1 - alpha_bars[t]).view(-1, 1, 1, 1)
    
        # 平均を計算
        mean = (1 / torch.sqrt(alpha)) * (x_t - beta / s1_ab * noise_pred)
    
        # ステップ 0 ではノイズを加えない(決定的出力)
        mask = (t != 0).float().view(-1, 1, 1, 1)
        
        # サンプリングのノイズを追加
        noise = torch.randn_like(x_t)
        return mean + torch.sqrt(beta) * noise * mask

    注意点としては、拡散過程の時と同様で、入力 x_t はバッチです。よって、4次元の形になっているため、beta、alphaなどは全て4次元にする必要があります。これは view(-1, 1, 1, 1) で行なっています。

    あとは、平均の計算を上述の近似のとおりに行います。

        # 平均を計算
        mean = (1 / torch.sqrt(alpha)) * (x_t - beta / s1_ab * noise_pred)

    ここでの noise_pred はノイズ予測モデルが予測したものです。これもバッチになっています。

    この平均画像にサンプリングのノイズを加えれば良いのですが、最終ステップだけは次の理由で特別に扱います。

    コードにおける t = 0 (理論上のステップだとt=1t = 1)は、x1\boldsymbol{x}_1からx0\boldsymbol{x}_0への生成過程の最終ステップです。拡散過程によるノイズはx0\boldsymbol{x}_0に含まれないため、サンプリングのこのステップでは新たなノイズを加える必要はありません。

    実際、論文にも次のように述べれれています。

    サンプリングの最後では、μθ(x1,1)\boldsymbol{\mu}_\theta(\boldsymbol{x}_1, 1)(x0\boldsymbol{x}_0に対するモデルの平均予測)をノイズなしで表示します。

    At the end of sampling, we display μθ(x1,1)\boldsymbol{\mu}_\theta(\boldsymbol{x}_1, 1) noiselessly.

    https://arxiv.org/abs/2006.11239

    よって、この実装の最終ステップでは、予測された平均画像をそのまま使うためにマスクを使います。

        # ステップ 0 ではノイズを加えない(決定的出力)
        mask = (t != 0).float().view(-1, 1, 1, 1)

    通常、バッチでサンプリングする際には、 t の値は全ての画像に対して同じものを指定しますが、ここでは t は、それぞれの画像に対して指定できるような形式になっています。よって、画像ごとにステップの値が異なったとしても問題が無いようにコードを書いています。

    このマスクもバッチに対応するために4次元にしています。

    最後に、バッチと同じサイズのサンプリングのノイズを生成して、それを近似の標準偏差(分散 beta の平方根)でスケールしたものを付加します。

    ここでマスクが使われています。

        # サンプリングのノイズを追加
        noise = torch.randn_like(x_t)
        return mean + torch.sqrt(beta) * noise * mask

    生成過程の分布からサンプリングするための実装はこれだけです。

    生成過程(サンプリング)

    この生成過程の実装 sample_p と、訓練済みのノイズ予測モデル model を使うことで、完全なノイズxT\boldsymbol{x}_Tから逐次的にx0\boldsymbol{x}_0をサンプリングし画像を生成することができます。

    そのためのコードは以下になります。

    # ------------------------------------------------------------
    # サンプリング関数(画像生成)
    # ------------------------------------------------------------
    def sample(model, n_samples: int):
        # 入力ノイズを画像の形状に合わせて生成
        x = torch.randn(n_samples, image_channels, image_size, image_size)
        x = x.to(device)
    
        # 時間ステップを逆順にサンプリング
        for t_step in reversed(range(T)):
            # 時間ステップをテンソルに変換
            t = torch.full((n_samples,), t_step, dtype=torch.long,
                            device=device)
    
            # ノイズ予測を行う
            noise_pred = model(x, t)
    
            # 生成過程によって次のステップの画像をサンプリング
            x = sample_p(x, t, noise_pred)
        return x

    n_sample は生成したい画像の数です。まず、その数のノイズ画像を用意します。

        # 入力ノイズを画像の形状に合わせて生成
        x = torch.randn(n_samples, image_channels, image_size, image_size)
        x = x.to(device)

    image_channels や image_size は、学習データセットに合わせて定義されているとします。また、正方形を想定しています。これも学習データセット(MNISTやCIFAR10など)に依存します。

    以下のように最終ステップ T - 1 から始めて t_step = 0 へと逆過程を進めます。

    for t_step in reversed(range(T)):

    ステップ数を画像分だけ用意します。

          # 時間ステップをテンソルに変換
          t = torch.full((n_samples,), t_step, dtype=torch.long,
                         device=device)

    このように画像生成の際は、同じステップを全ての生成画像で使うのが通常です。ただし、sample_p はこの想定がなくとも機能するように実装されています。

    次に、ノイズ予測モデルを使って、現在のステップの画像に含まれるノイズを予測します。

          # ノイズ予測を行う
          noise_pred = model(x, t)

    あとは、生成過程を呼び出して、次のステップの画像をサンプリングします。

          # 生成過程によって次のステップの画像をサンプリング
          x = sample_p(x, t, noise_pred)

    もちろん、次のステップというのは生成の方向での話で、拡散過程から見ると逆方向です。

    これを使って以下のように画像生成を行います。

    # 推論モード
    model.eval()
    
    # 勾配不要
    with torch.no_grad():
        samples = sample(model, n_samples=16)
    
    # 画像を表示
    show_images(samples)

    生成過程のサンプリングの実装は以上です。

    次回予告

    あとは、ノイズ予測モデルさえあれば、訓練して画像生成を行うことができます。

    よって次回は、DDPMのノイズ予測モデルであるU-Netの実装を解説します。

    お楽しみに!


    「わかりやすく、具体的に」AIとサイエンスの情報を発信中

    あなたへのおすすめ