前回は、スコアベース生成モデルの基本的な考え方を紹介しました。
その中で触れた連続時間の拡散モデルは、前回は一般形だけを示すにとどめましたが、今回はさらに踏み込み、具体的な形を紹介します。
拡散モデルを記述する確率微分方程式(Stochastic Differential Equation、SDE)には、VP-SDE、VE-SDE、sub-VP-SDEといったいくつかのバリエーションがあり、それぞれに「ノイズの付加方法」と「ノイズの除去方法」の違いが明確に現れます。
さらに、DDPMのような離散時間の拡散モデルも、連続時間の確率過程の枠組みで統一的に捉えることができます。
拡散モデルとSDEの一般形
まずは、前回までの振り返りをして、VP-SDEを理解する土台を固めます。
スコアベースの生成モデル
一般に生成モデルでは、データの分布P(x)を推定し、そこからサンプリングを行うことで新しいデータを生成します。
これはスコアベースの生成モデルでも同様ですが、その方法はスコア(対数確率の勾配)を推定することで、データ分布P(x)の形状を把握し利用するというアプローチになっています。
s(x)=∇xlogP(x)
このスコア関数を知ることで、各地点において「確率が高くなる方向」がわかります。そして、この対数密度の勾配(スコア)を近似・学習する手法の全般を「スコアマッチング」と呼びます。
これはDDPMなどの拡散モデルが登場する以前から研究されている確率モデリングの手法です。
拡散モデルとスコアマッチング
しかし、高次元データの確率分布を学習するのは非常に困難です。なぜなら、データは空間全体にまんべんなく存在しているわけではなく、ほとんどの領域(位置)で確率密度が0です。
つまり、スカスカであり、ある特定の領域でのみ意味のあるデータが存在します。前回はこのことをMNISTの画像の例で解説しました。
数学的には、高次元のデータは、疎(sparse)であると表現します。
そこでスコアベースの生成モデルでは、段階的にノイズを加えた分布Pt(x)のスコアを学習します。このため確率分布は位置xだけでなく時間tにも依存して変化します。
時間によって、分布が変わるという方がわかりやすいかもしれません。徐々に、ノイズを加えることで高次元データの確率分布が少しずつ「密」になります。つまり、より広い領域に確率が広がるため、スコアの学習が容易になります。
この「密」(dense)は、「疎」(sparse)の反対の意味です。
ただし、一度に強いノイズを加えてしまうと元の分布の構造が一気に壊れてしまうため、時間とともに徐々にノイズを強くして確率分布を密にしていきます。
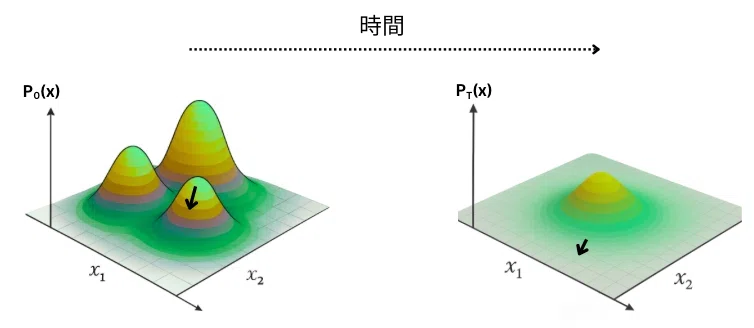 時間によって変化する確率分布のイメージ
このようにして、段階的に密な分布を通過しながら、スコア関数を学習していきます。この学習がうまくいけば、「ある時間」における「ある位置」のスコアが予測できるようになります。
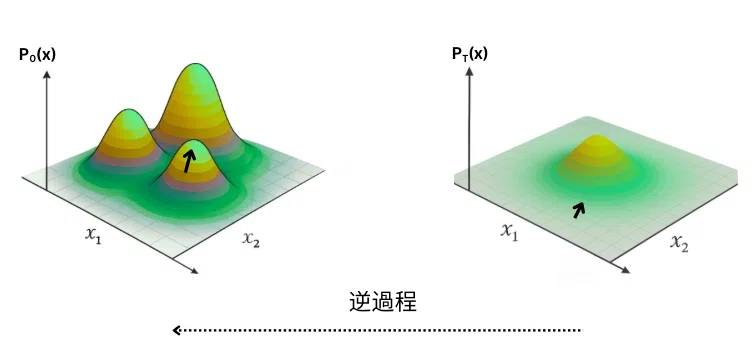 時間を逆に遡って変化する確率分布のイメージ
すると、ノイズから始めてスコアが示す方向に従って移動すると同時に時間を遡っていくことで、ノイズ空間からデータ空間へと「時間を逆行するように」移動していくことで、サンプリングが実現できます。
DDPM、DDIM、LDMでは、ノイズを加えたデータを使って学習を行い、最終的にノイズから画像を生成できるようにするという視点で語られることが多いです。
スコアベースの生成モデルでは、高次元の確率分布を直接扱うことが難しいため、ノイズを加えることで分布を密にし、スコア(対数密度の勾配)を学習しやすくする(現実的で安定性が高くする)という発想に立っています。
こうして、高次元でスカスカな確率分布からの生成が可能となります。
フォワードSDEによる拡散過程
スコアベースの生成モデルでは、連続時間の拡散過程はフォワードSDE(前方向の確率微分方程式)として次のように記述されます。
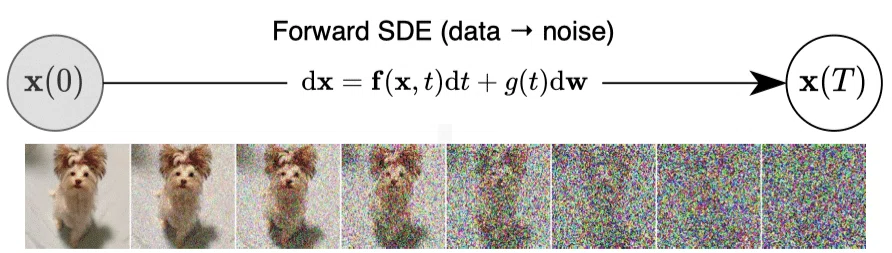 論文:図1(上部)
dx=f(x,t)dt+g(t)dw
dx:画像xの微小な変化
f(x,t)dt:ドリフト項(平均的な変化)
g(t):拡散係数(ノイズの強さ)
dw:ブラウン運動(標準正規分布に基づくガウスノイズ)
太字の記号(x,f,dw)は、すべて画像xと同じサイズのベクトルを意味しています。
この拡散過程フォワードSDEに従って、画像xに徐々にノイズが加えられ、分布は時間とともに拡散し、より密になります。
リバースSDEによる生成過程
この拡散過程を逆向きにたどることで、ノイズからデータを生成することができます。この生成過程は、リバースSDE(逆方向の確率微分方程式)として次のように記述されます。
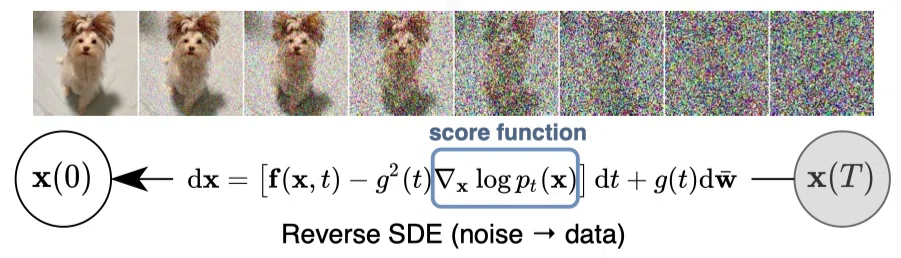 論文:図1(下部)
dx=[f(x,t)−g2(t)∇xlogPt(x)]dt+g(t)dwˉ
f(x,t)dt:フォワードSDEと同じドリフト項
∇xlogPt(x):時刻tにおけるスコア関数(確率密度の勾配)
−g2(t)∇xlogPt(x)dt:スコアによる補正
dwˉ:逆向き時間でのブラウン運動(標準正規分布に従う)
ここで注意して欲しいのは、逆過程ではdtは負である(dt<0)ことです。よって、フォワードSDEと同じドリフト項があるのは、「拡散過程(フォワードSDE)で加わった影響を打ち消す」という意味です。
なお、∇xlogPt(x)にマイナスがついていますが、dtが負なので、全体として正の方向(確率が高くなる方向)にxを変化させています。
g2(t)という係数がついているのは、単なる設計上の工夫ではなく、リバースSDEとフォワードSDEとが確率的に整合するようにするために理論的に必要な項です。
これはAnderson (1982)において理論的に導出されたものであり、スコアベースの生成モデルの論文「Score-Based Generative Modeling via SDEs」でもこの式を導出なしで採用しています。
なお、最後の項にあるdwˉはサンプリングのための揺らぎです。これは時間を逆向きに進めているという点を除けば、フォワードと同じく標準正規分布に基づいています。
このように、フォワードSDEが与えられると、逆過程であるリバースSDEが理論的に定義されます。あとは、スコア関数を学習することで、高次元データのサンプリングである生成過程を実現することができます。
今回は、代表的なSDEの一つであるVP-SDEを紹介します。
DDPMとVP-SDE
VP-SDE(Variance Preserving SDE、分散保存型SDE)は、DDPMの離散的な拡散過程を時間連続のSDEとして表現したものです。
まずは、DDPMの拡散過程が分散保存型であることを確認します。
DDPMの拡散過程は分散保存型
DDPMにおける拡散過程は以下のように定義されていました。
xt=1−βtxt−1+βtϵ,ϵ∼N(0,I)
この式は、「元の画像に少しノイズを足す」処理を繰り返す構造になっています。第1項は前のステップからの減衰された画像であり、第2項は新たに足されるガウスノイズを意味します。
また、次のように分散の関係式が成り立ちます。
Var[xt]=(1−βt)Var[xt−1]+βt
初期条件として、データセットにある画像の分散が1であると仮定すると、Var[x0]=1となるため、すべてのtに対して Var[xt]=1が成立します。
実装ではデータの前処理として、ピクセル値を[−1, +1]の範囲に収まるようにしていますが、これによってデータセットにある画像の分散が1になるわけではありません。
よって、Var[x0]=1は理論的な理想条件であり、実際は近似です。それでも、よくある[ 0, 1 ]の範囲にする前処理ではなく[−1, +1]にしていることにはそれなりの意味があります。
なお、ここでの分散Var[x(t)]は、正確には共分散行列を指しますが、各成分(ピクセル)のノイズ(分散)が等しく、相互に相関がないと仮定することで、スカラーとして記述しています。
これは、DDPMの拡散過程における分散は保存される(一定に保たれる)ことを意味します。そして、最終的に完全なノイズ(標準正規分布)に近づくように設計されています。
時間連続のフォワードSDEへ
ここでは、DDPMを時間連続のSDEへと拡張し、VP-SDEを導出します。
まず、βtを連続関数β(t)へと滑らかに拡張します。そして、離散ステップtを微小時間δtに置き換えることで、近似的に次の式が成り立ちます。
xt+δt≈1−β(t)δtxt+β(t)δtϵ,ϵ∼N(0,I)
「近似的」なのは、微小時間δtにおいてβ(t)が一定とは限らないからです。しかし、微小時間δtが十分に小さいならば近似的に上記の関係が成り立ちます。
ここで、1−β(t)δtを次のようにテイラー展開して近似します。
1−β(t)δt≈1−21β(t)δt
関数f(x)をx=0の周りでテイラー展開すると以下になります。
f(x)=f(0)+f′(0)x+21f′′(0)x2+…
展開点がx=0なので、マクローリン展開とも呼ばれます。なお、f′(x)は、関数f(x)をxで1度微分したという意味です。f′′(x)は、関数f(x)をxで2度微分したということです。
これをf(x)=1−xに適用すると以下になります。
f(x)=1−x=1−21x−81x2+ …
ここで、x=β(t)δtと置き、上式の一次項までを使って近似します。
1−β(t)δt≈1−21β(t)δt
この近似を上述の式に代入します。
xt+δt≈(1−21β(t)δt)xt+β(t)δtϵ,ϵ∼N(0,I)
ここでδt→0の極限としてδt→dtとします。また、xt+δt−xt→ dxとなるので、以下の連続時間SDEの形になります。これがVP-SDEです。
dx=−21β(t)xdt+β(t)dw
dtϵをdwと書き換えたのは、連続時間の確率過程の記法です。以下のように両者とも同じ統計的性質を持ちます。
dtϵはϵ∼N(0,I)なので、分散がdtとなる
dw∼N(0,dtI)の意味で、これも分散がdtとなる
なお、元画像にはノイズを加えないので、β(t=0)=0です。
この式におけるdxは、ある時刻におけるxの微小な変化(無限小変化)を表しています。第1項はxからどれだけ減衰するのかを示し、第2項は付加されるガウスノイズを意味します。
つまり、DDPMの拡散過程を時間連続へと拡張したものになっています。
VP-SDEの近似としてのDDPM
VP-SDEは、DDPMの拡散過程が分散保存型であり、それを時間連続に拡張したことからも「分散保存型」(Variance Preserving)であることを受け入れることができます。
しかし、スコアベースの生成モデルで定義されるフォワードSDEの一般形には分散保存型という条件はありません。
dx=f(x,t)dt+g(t)dw
次回紹介するVE-SDEは「分散発散型」(Variance Exploding)です。
つまり、VP-SDEの式には「分散保存型」という性質が含まれているわけで、DDPMから導出したという事実に依存せずに確認できるはずです。そこで、VP-SDEを純粋にSDEとして見た場合に、なぜ分散保存型になるのかを考えてみます。
VP-SDEの定義をここに再掲します。
dx=−21β(t)xdt+β(t)dw
フォワードSDEの一般形と比較すると次の項を認識できます。
ドリフト項:−21β(t)xdtはxの一次式(線形)
拡散項:β(t)dwはxに依存していない(時間依存だけ)
このようなSDEは「線形SDE」と呼ばれ、初期値x(0)=x0を与えると、以下の解が導出されます。
x(t)=α(t)x0+σ(t)ϵ,ϵ∼N(0,I)
一般的に、確率微分方程式を解くには積分を行う必要があるのですが、複雑なのでここでは割愛し結果だけを受け入れてその性質を見ていきます。
このため、データセットにある画像の分散がVar[x0]=1であると(理想的な)仮定すると、以下の条件が満たされ、全体の分散が1となります。
Var[x(t)]=α2(t)Var[x0]+σ2(t)=1
繰り返しになりますが、ここでの分散Var[x(t)]は、正確には共分散行列を指しますが、各成分(ピクセル)のノイズ(分散)が等しく、相互に相関がないと仮定することで、スカラーとして記述しています。
こうして、VP-SDEが「分散保存型」であることが純粋にSDEの解の構造そのものから理解することができます。逆にいうと、これは一般のフォワードSDEの定義に「分散保存型」という条件をつけたもので、「画像の情報を徐々に削り取り、同じだけノイズに置き換えていく」ようになっています。
一般的なフォワードSDEの定義から始めると、VP-SDEは「分散保存型」であり、その離散的な近似がDDPMの拡散過程になるという統一的な視点であらゆる拡散モデルを捉えることができます。
また、「分散保存型」という条件はVP-SDEに特有であり、その他のフォワードSDEでは異なる条件が可能であり、それぞれに応じた生成アルゴリズムを構築することができます。
スコア関数とDDPMのノイズ予測
VP-SDE以外のフォワードSDEに進む前に、まずはDDPMのノイズ予測モデルとスコア関数の関係について考察します。
スコアベースの生成モデルでは、時間とともに変化する確率分布Pt(x)に対して、そのスコア関数∇xlogPt(x)を学習し、以下のリバースSDEに従ってサンプリングを行います
dx=[f(x,t)−g2(t)∇xlogPt(x)]dt+g(t)dwˉ
この式から分かるように、各時刻におけるスコア関数さえ分かれば、状態xをどの方向に動かすべきかが決定できます。
ここで疑問なのは、「スコア関数」と「DDPMのノイズ予測モデル」にはどのような関係があるのかということです。VP-SDEはDDPMの拡散過程を連続時間化したものであり、両者のノイズ削減には理論的な対応関係が存在するはずです。
そこでVP-SDEの解を使って、実際にスコア関数を計算してみます。VP-SDEのフォワードSDEは、次のような多変量ガウス分布に従います。
x(t)=α(t)x0+σ(t)ϵ,ϵ∼N(0,I)
このとき、条件確率(密度)は、以下になります。
Pt(x(t)∣x0)=N(α(t)x0,σ2(t)I)=(2π)d/2σ(t)d1exp(−2σ2(t)∥x(t)−α(t)x0∥2)
dはデータxの次元です。この対数を計算します。
logPt(x(t)∣x0)=−2dlog(2π)−dlogσ(t)−2σ2(t)1∥x−α(t)x0∥2
xに関して勾配を計算すると、xに依存しない項は消え、次のようになります。
∇xlogPt(x(t)∣x0)=−σ2(t)x(t)−α(t)x0
これがVP-SDEの解に基づくx0がわかっている時のスコア関数です。ただし、リバースSDEでの生成の際にはx0は未知のため、これを直接使うことはできません。そこで、ニューラルネットワークによりスコア関数の近似を学習します。
今度は、このスコア関数の式とノイズの関係を見るために、VP-SDEの解を変形してノイズϵの式に書き直します。
ϵ=σ(t)x(t)−α(t)x0
これとスコア関数を比べると次の関係があります。
∇xlogPt(x(t)∣x0)=−σ(t)1ϵ
つまり、スコア関数はノイズをσ(t)の逆数でスケールしたものです。マイナス符号は、ノイズを削減する方向を指しています。
なお、DDPMの生成過程においてもx0が未知であるためノイズϵを直接計算できません。そこで、ノイズ予測モデルϵθ(xt,t)によってϵを近似します。
これにより、スコア関数は次のように近似できます。
∇xlogPt(x(t)∣x0)≈−σ(t)1 ϵθ(xt,t)
まとめると、「VP-SDEのスコア関数予測」と「DDPMのノイズ予測モデル」は、時間tにおける同じノイズ成分に関する情報を、異なる形式(スコア vs ノイズ)で表現・学習していると見ることができます。
よって、DDPMはスコア関数を間接的に学習しているとみなすことができ、スコアベース生成モデルの一種として解釈できるというわけです。
次回予告
次回は「分散発散型」(Variance Exploding)のVE-SDEとsub-VP-SDEを紹介します。
お楽しみに!


