メインコンテンツへスキップ
見出し画像

微分と偏微分と勾配

    ディープラーニングでよく使われる計算として微分があります。微分がわかると、偏微分や勾配についても理解が進むのでディープラーニングの訓練で何が起きているのか理解しやすくなります。

    もちろん、微分の計算ができなくともディープラーニングのモデルを構築することはできますが、多くの解説記事などでは微分、偏微分、勾配といった概念が登場するので、ある程度は内容を知っていた方が便利です。

    微には「細かい」とか「小さい」という意味があります。分は「分ける」とか「部分」といった言葉に登場します。よって、微分という名前には「小さく分ける」という意味が込められています。

    この記事では、微分とは何なのかについて、そして偏微分と勾配との関係を解説します。

    関数の変化率と区間

    関数の変化率

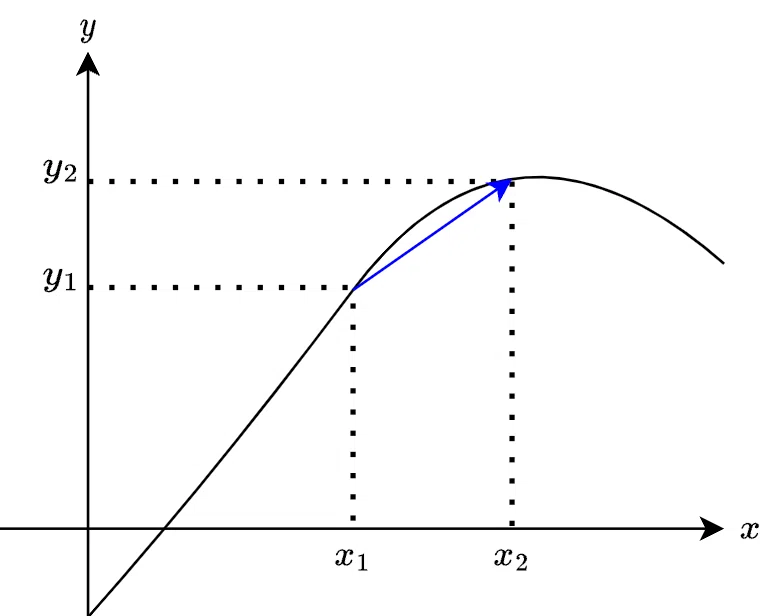
    下のグラフを見てください。yyはxxの関数です。

    y=f(x)y = f(x)

    画像

    xxをx1x_1からx2x_2へと移動すると、yyがy1y_1からy2y_2へと値が変わります。この変化率は次のように定義できます。

    ΔyΔx=y2−y1x2−x1\dfrac{\Delta y}{\Delta x} = \dfrac{y_2 - y_1}{x_2 - x_1}

    ここで、Δy=y2−y1\Delta y = y_2 - y_1とΔx=x2−x1\Delta x = x_2 - x_1としています。Δ\Deltaはデルタと呼びます。

    変化率と区間

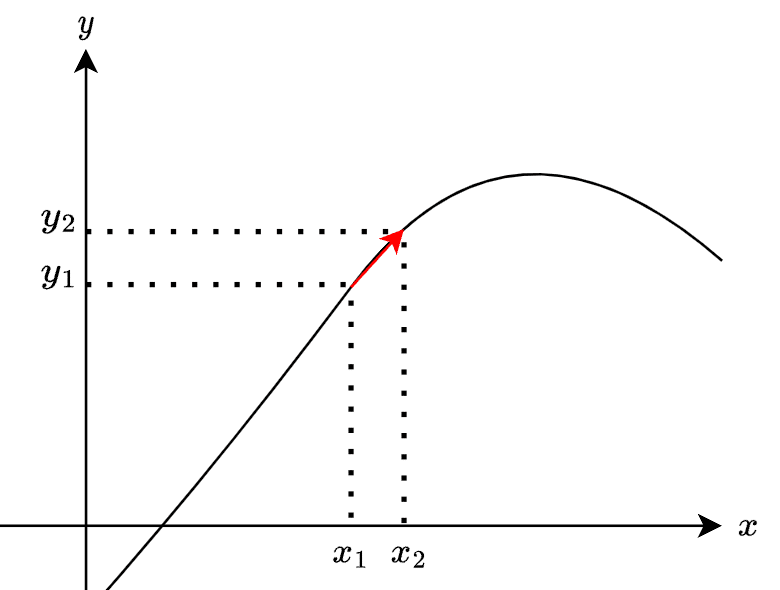
    Δx\Delta xを小さくとると、y2y_2の位置が変わるので変化率も変わります。

    画像

    Δx\Delta xが小さくなるほど、変化率ΔyΔx\dfrac{\Delta y}{\Delta x}はx1x_1における関数y=f(x)y=f(x)の傾き(接線)へと近づきます。

    1次関数

    具体的に、関数f(x)f(x)として、次の直線を考えます。

    y=ax+by = a x + b

    すると変化率は、

    ΔyΔx=y2−y1x2−x1=(ax2+b)−(ax1+b)x2−x1=a(x2−x1)x2−x1=a\dfrac{\Delta y}{\Delta x} = \dfrac{y_2 - y_1}{x_2 - x_1} = \dfrac{(a x_2 + b) - (a x_1 + b)}{x_2 - x_1} = \dfrac{a (x_2 - x_1)}{x_2 - x_1} = a

    となり、直線の傾きと同じになります。1次関数では変化率は一定なのでΔx\Delta xによらず固定値となります。

    2次関数

    では、次の2次関数ではどうでしょうか。

    y=x2y = x^2

    変化率を計算します。

    ΔyΔx=y2−y1x2−x1=x22−x12x2−x1=(x2−x1)(x2+x1)x2−x1=x2+x1\dfrac{\Delta y}{\Delta x} = \dfrac{y_2 - y_1}{x_2 - x_1} = \dfrac{x_2^2 - x_1^2}{x_2 - x_1} = \dfrac{(x_2 - x_1)(x_2 + x_1)}{x_2 - x_1} = x_2 + x_1

    y=x2y = x^2のx1x_1からx2x_2への変化率は、x1+x2x_1 + x_2であることがわかります。

    では、Δx\Delta xをもっと小さくするとどうなるでしょうか。

    微分の計算

    区間を極限まで小さく

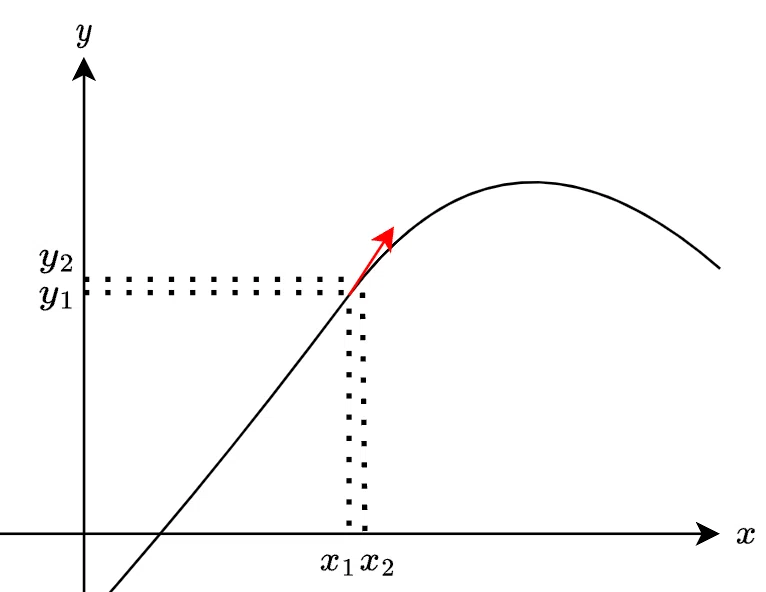
    では区間Δx\Delta xをどんどん小さくして0へと近づけましょう。

    画像

    なお、Δx\Delta xが小さい時はδx\delta xと書くことが多いです。δ\deltaもデルタですが小文字になっています。

    変化率は次のように書けます。

    δyδx\dfrac{\delta y}{\delta x}

    ここで、δy=y2−y1\delta y = y_2 - y_1でδx=x2−x1\delta x = x_2 - x_1です。

    なのでΔx\Delta xでもδx\delta xでも同じですが、δx\delta xだと小さい区間というニュアンスが込められています。

    微分の計算

    さらに、δx\delta xを限りなく0に近づけることを考えます。

    δx\delta xを限りなく0に近づけた時のδyδx\dfrac{\delta y}{\delta x} の値を次のように表現します。

    lim⁡δx→0δyδx\lim\limits_{\delta x \rightarrow 0} \dfrac{\delta y}{\delta x}

    lim⁡\limはリミット(limit)で極限とか限界を意味します。よって、lim⁡δx→0\lim\limits_{\delta x \rightarrow 0}とは「δx\delta xを限りなく0に近づける」という意味です。

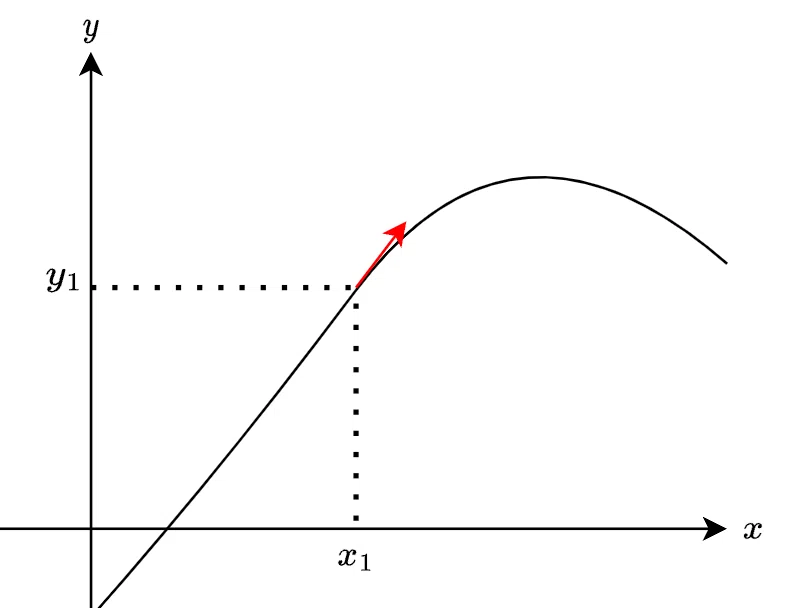
    これは関数f(x)f(x)のある点における傾きになります。

    画像

    実は、lim⁡δx→0δyδx\lim\limits_{\delta x \rightarrow 0} \dfrac{\delta y}{\delta x} は微分の計算を意味し、次のようにdydx\dfrac{dy}{dx}という表記をします。

    dydx=df(x)dx=lim⁡δx→0δyδx\dfrac{dy}{dx} = \dfrac{df(x)}{dx} = \lim\limits_{\delta x \rightarrow 0} \dfrac{\delta y}{\delta x}

    これをxxによるf(x)f(x)の微分と呼びます。

    「微分する」とは、f(x)f(x)のある点における傾きを計算することを意味します。なお、計算されたものを微分係数とも呼びます。

    また、次のように微分を表現する表記にはいろいろあります。

    dydx=y′=df(x)dx=f′(x)\dfrac{dy}{dx} = y' = \dfrac{df(x)}{dx} = f'(x)

    物理などでは、次のような表記もします。

    dydx=y˙=df(x)dx=f˙(x)\dfrac{dy}{dx} = \dot{y} = \dfrac{df(x)}{dx} = \dot{f}(x)

    これらの省略形の表現ができるのは、y=f(x)y = f(x)がxxだけに依存する関数だからです。あとで見るように複数の変数がある場合は表記の仕方が変わってきます。

    なお、微分の値は関数のある点における傾きなので、計算する時のxxの値によって変わります。

    よって、x1x_1における微分であることを強調するには次のようも表現できます。

    dydx∣x=x1=df(x1)dx=f′(x1)\dfrac{dy}{dx} \bigg\vert_{x = x_1} = \dfrac{df(x_1)}{dx} = f'(x_1)

    2次関数の微分

    繰り返しますが、2次関数の変化率は次のようになっていました。

    ΔyΔx=y2−y1x2−x1=x22−x12x2−x1=(x2−x1)(x2+x1)x2−x1=x2+x1\dfrac{\Delta y}{\Delta x} = \dfrac{y_2 - y_1}{x_2 - x_1} = \dfrac{x_2^2 - x_1^2}{x_2 - x_1} = \dfrac{(x_2 - x_1)(x_2 + x_1)}{x_2 - x_1} = x_2 + x_1

    区間が小さくても同じです。

    δyδx=y2−y1x2−x1=x22−x12x2−x1=(x2−x1)(x2+x1)x2−x1=x2+x1\dfrac{\delta y}{\delta x} = \dfrac{y_2 - y_1}{x_2 - x_1} = \dfrac{x_2^2 - x_1^2}{x_2 - x_1} = \dfrac{(x_2 - x_1)(x_2 + x_1)}{x_2 - x_1} = x_2 + x_1

    ここでδx\delta xを限りなく小さくするとは、x2x_2をx1x_1に限りなく近づけることになります。

    dydx∣x=x1= lim⁡x2→x1δyδx= lim⁡x2→x1(x2+x1)=2x1\dfrac{dy}{dx}\bigg|_{x=x_1} = \lim\limits_{x_2 \rightarrow x_1} \dfrac{\delta y}{\delta x} = \lim\limits_{x_2 \rightarrow x_1} (x_2 + x_1) = 2 x_1

    となります。つまり、x2x^2のx1x_1における微分は2x12 x_1です。

    δx=x2−x1\delta x = x_2 - x_1ですが、より一般にx1x_1をxxで置き換えると、x2=x+δx x_2 = x + \delta x になり、次のように書き直せます。

    df(x)dx= lim⁡δx→0δyδx = lim⁡δx→0(x+(x+δx))=2x\dfrac{ df(x)}{dx} = \lim\limits_{\delta x \rightarrow 0} \dfrac{\delta y}{\delta x}  = \lim\limits_{\delta x \rightarrow 0} (x + (x+\delta x)) = 2x

    さまざまな関数で、微分を計算することができます。ただし、微分が計算できる関数には条件があります。

    微分ができる条件

    関数が連続である区間

    微分ができるのは、関数f(x)f(x)が連続である区間に限ります。

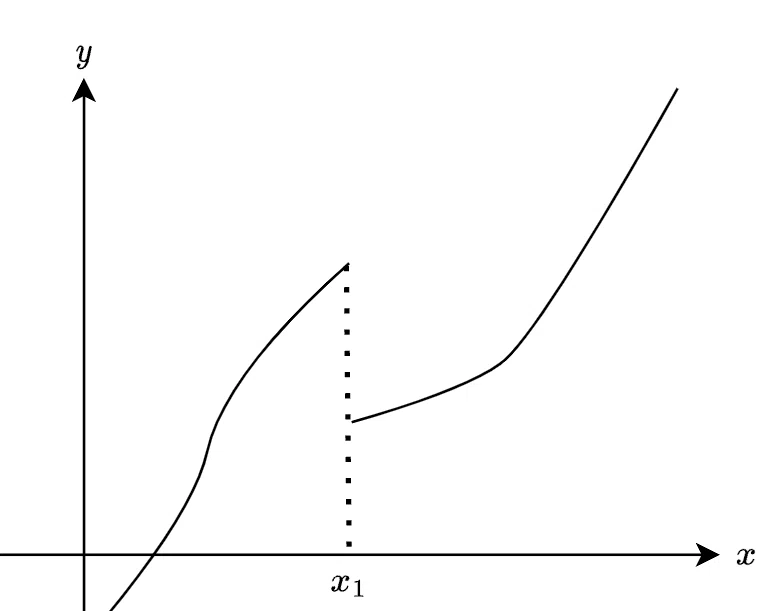
    例えば、以下の関数は点x1x_1で不連続なので、x1x_1での微分はできません。他の連続な部分での微分は可能です。

    画像

    関数が定義できる区間

    あと、関数が定義されていない区間で微分はもちろん不可能です。

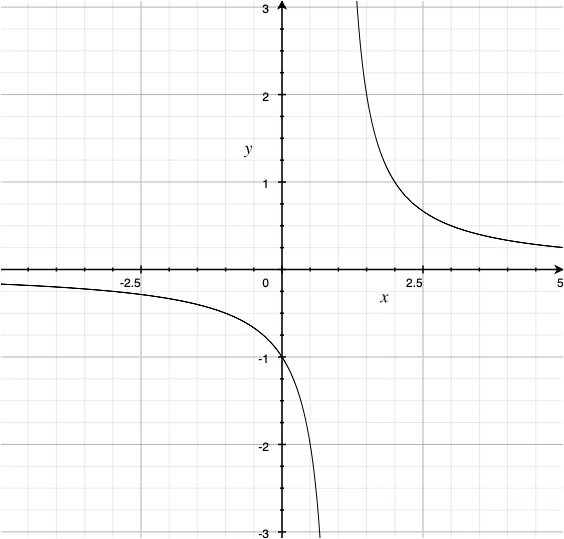
    例えば、関数f(x)=1x−1f(x) = \dfrac{1}{x - 1}はx=1x = 1で定義されていないのでx=1x = 1では微分できません。

    画像

    微分が一定値である

    微分の値が一つに定まらないケースも、微分ができません。

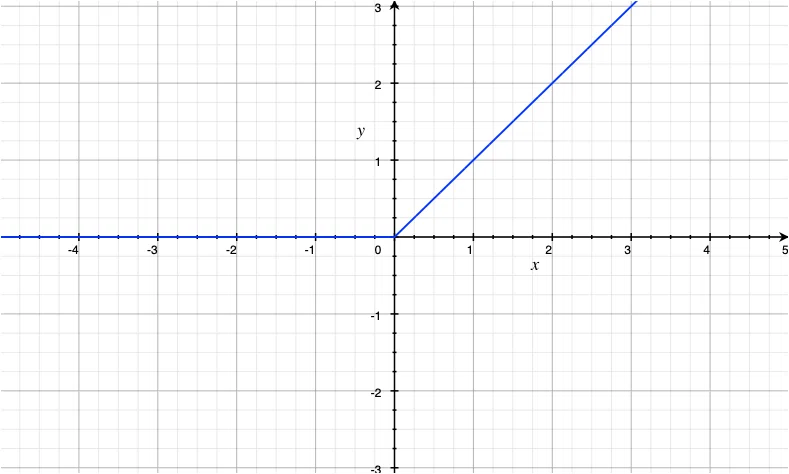
    例えば、活性化関数としてよく使われるReLUはx=0x=0では微分ができません。

    ReLU(x)=max⁡(0,x)\text{ReLU}(x) = \max(0, x)

    画像

    実用ではx=0x=0におけるReLU\text{ReLU}の微分はdReLU(x)dx∣x=0=1\dfrac{d \text{ReLU(x)}}{dx}\bigg|_{x=0} = 1と決めることで対応します。

    偏微分とは

    複数変数の関数

    偏微分は、関数が複数の変数を持つ場合に各変数に対して定義します。

    例えば、関数z=f(x,y)z = f(x, y)に関してはxxとyyに対してそれぞれ微分を別々に考えるのですが、これを偏微分と呼びます。

    偏微分は次のように定義します。

    ∂z∂x= ∂f(x,y)∂x=lim⁡δx→0f(x+δx,y)−f(x,y)δx\dfrac {\partial z}{\partial x} = \dfrac{\partial f(x, y)}{\partial x} = \lim\limits_{\delta x \rightarrow 0} \dfrac{f(x + \delta x, y) - f(x, y)}{\delta x}

    つまり、xxでf(x,y)f(x, y)を偏微分する時に、xxだけに関して極小の変化を考えますが、それ以外は固定されているとみなします。

    そのため、∂\partialという記号を使って、「この関数はxxだけに依存するわけではなく他にも変数がある」ことを暗示しています。

    同様に、yyでf(x,y)f(x, y)を偏微分するのは、次のように定義できます。

    ∂z∂y= ∂f(x,y)∂y=lim⁡δy→0f(x,y+δy)−f(x,y)δy\dfrac {\partial z}{\partial y} = \dfrac{\partial f(x, y)}{\partial y} = \lim\limits_{\delta y \rightarrow 0} \dfrac{f(x, y + \delta y) - f(x, y)}{\delta y}

    損失関数の偏微分

    もちろん、ニューラルネットワークのように、たくさんのパラメータ(重み)がある場合でも偏微分の考え方は同じです。

    それぞれのパラメータに対して損失関数の偏微分を行います。それによって、各パラメータを微調整するとどのくらい損失関数に影響を与えるのかがわかるからです。

    例えば、損失関数をパラメータの関数として、loss(w)\text{loss}(\boldsymbol{w})と表現します。ここで、w=(w1,w2,…,wn)\boldsymbol{w} = (w_1, w_2, \dots, w_n)となります。

    各パラメータによる損失関数loss(w)\text{loss}(\boldsymbol{w})の偏微分が計算できれば、どの方向に各パラメータを調整すれば損失値が小さくなるのかがわかります。

    損失値が小さくなるようにパラメータw1w_1を調節するの更新式は次のように書けます。

    w1←w1−α∂loss(w)∂w1w_1 \leftarrow w_1 - \alpha \dfrac{\partial \text{loss}(\boldsymbol{w})}{\partial w_1}

    α\alphaは学習率です。

    さらに、全てのパラメータの更新式をまとめて表記するには勾配を使います。

    勾配とは

    勾配とは、ある関数における全ての偏微分をベクトルとしてまとめたものです。計算式がコンパクトになるなどの利点があります。

    gradf(x,y)=(∂f(x,y)∂x, ∂f(x,y)∂y)\text{grad} f(x, y) = \left( \dfrac{\partial f(x, y)}{\partial x},  \dfrac{\partial f(x, y)}{\partial y} \right)

    また、次のようにナブラ記号を使うこともよくあります。

    ∇f(x,y)=(∂f(x,y)∂x, ∂f(x,y)∂y)\nabla f(x, y) = \left( \dfrac{\partial f(x, y)}{\partial x},  \dfrac{\partial f(x, y)}{\partial y} \right)

    これを使うと全てのパラメータの更新を次のように書き表せます。

    w← w−α∇loss(w)\boldsymbol{w} \leftarrow \boldsymbol{w} - \alpha \nabla \text{loss}(\boldsymbol{w})

    なお、数学的に厳密な話でない限り、微分と偏微分と勾配を全て同じような意味合いで使うことが見受けられます。その場合は、文脈で判断するしかありません。

    関連記事


    「わかりやすく、具体的に」AIとサイエンスの情報を発信中

    あなたへのおすすめ