こちらの記事で説明した誤差逆伝播法をもう少し現実的なフィードフォワード型のニューラルネットワークに適用して解説してみます。
1層のニューラルネットワーク
まず1つの層からなる単純なニューラルネットワークで誤差逆伝播法を考えます。
フィードフォワード処理
まずは、順方向の処理を解説します。
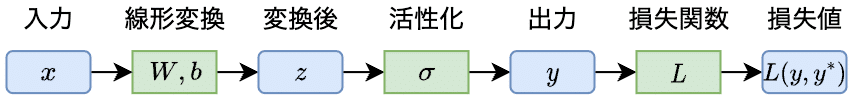
水色の箱は変数で、入力によって値が変ります。緑色の箱は操作で、変換や関数を意味します。
まず、入力xは一般にベクトルを想定しています。
x=x1x2⋮xn
この1層のニューラルネットワークでは、出力をスカラーとします。よって、線形変換の重み行列Wは1×nになります。
W=[w1w2⋯wn]
また、バイアスbはスカラーです。よって、重み行列Wとバイアスbによるxの線形変換は以下のように表現できます。
z=Wx+b= w1x1+w2x2+⋯+wnxn+b
さらに、活性化関数σ(sigmoid、tanhなど)によってzを非線形変換したのが出力yです。
y=σ(z)
最後に、損失関数Lにモデルの出力値yと正解値y∗を与えて計算した損失値がL(y,y∗)になります。
y,y∗ L L(y,y∗)
この損失関数Lの計算内容は、誤差の種類によって異なります。例えば、二乗誤差や交差エントロピーを計算する場合がありますが、ここでは損失関数$L$がスカラーであることだけが重要です。損失関数の具体的な中身は、勾配計算には影響しません。
バックプロパゲーション
損失から誤差逆伝播を行います。
まず、損失L(y,y∗)を予測yで偏微分します。これが∂y∂L(y,y∗)です。
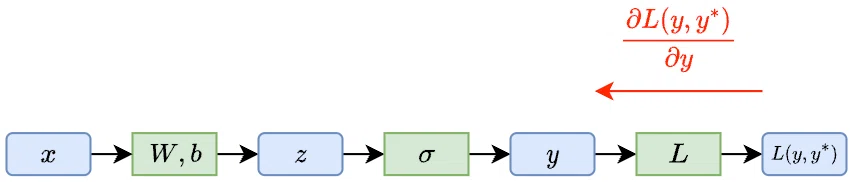
次に、y=σ(z)をzで微分したのが、dzdy=dzdσ(z)=σ′です。この活性化は要素ごとに適用され、一変数関数なので、その微分を常微分として表記しています。
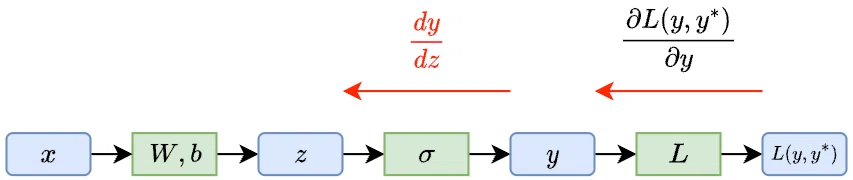
さらに、zを各重みパラメータwiとバイアスbに関して偏微分します。
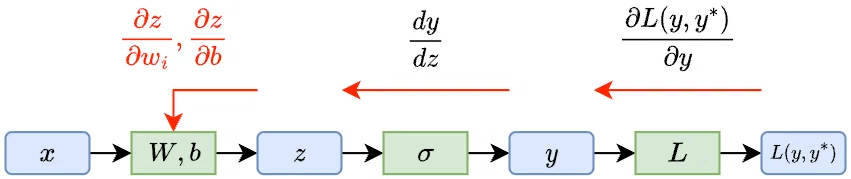
∂wi∂z∂b∂z= ∂wi∂(Wx+b)=xj(i=1,…,n)=∂b∂(Wx+b)=1
以上より、損失関数Lをパラメータwiとbに関して偏微分することができます。
∂wi∂L∂b∂L= ∂y∂L⋅dzdy⋅ ∂wi∂z= ∂y∂L⋅σ′⋅ xi= ∂y∂L⋅dzdy⋅ ∂b∂z = ∂y∂L⋅σ′
ここでのドット記号⋅は積を意味します。また、後でベクトルと行列の積としても使われます。
これらの偏微分をベクトルとしてまとめたものが勾配(gradient)です。
∇L= ∂w1∂L∂w2∂L⋮∂wn∂L∂b∂L
丸括弧で次のようにもコンパクトに表記することも多いです。同じ意味です。
∇L=(∂w1∂L, ∂w2∂L,⋯, ∂wn∂L, ∂b∂L)
まとめ
誤差逆伝播では以下の処理を行います。
フィードフォワード処理時に値を保存するので場合によっては多くのメモリを消費しますが、微分の連鎖律を利用できるため逆伝播の計算は非常に効率的です。
2層のニューラルネットワーク
次に2層のニューラルネットワークにおける誤差逆伝播を考えます。
フィードフォワード処理
このニューラルネットワークには線形層が2つあり、その間に途中の状態(隠れ状態h)が計算されています。
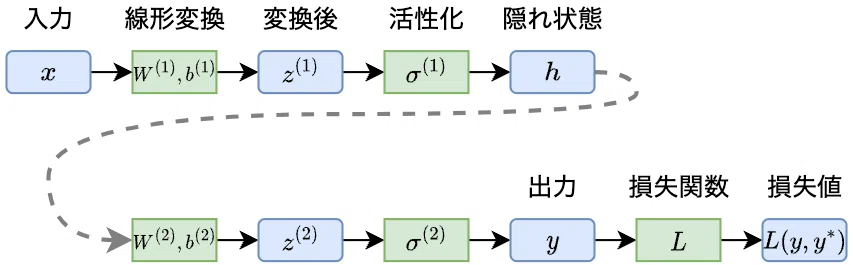
なお、隠れ状態hを出力するまでを第1層とし、第2層は隠れ状態hを入力としてyを出力するまでとします。上付きの番号(1)と(2)は、それぞれ第1層と第2層を意味します。
第1層の線形変換の重み行列W(1)はm×nで、バイアスb(1)はm個の要素を持つベクトルとします。
W(1)=w11(1) w21(1) ⋮wm1(1)w12(1)w22(1)⋮wm2(1)⋯⋯⋱⋯w1n(1)w2n(1)⋮wmn(1),b(1)=b1(1)b2(1)⋮bm(1)
よって、線形変換z(1)=W(1)x+b(1)は以下になります。
z(1)=z1(1)z2(1)⋮zm(1)=w11(1)x1+w12(1)x2+⋯+w1n(1)xn +b1(1)w21(1)x1+w22(1)x2+⋯+w2n(1)xn +b2(1)⋮wm1(1)x1+wm2(1)x2+⋯+wmn(1)xn+bm(1)
これに活性化関数σ(1)を適用したものが、隠れ状態h=σ(1)(z(1))です。活性化関数はベクトルの要素ごとに適用されるので、隠れ状態hはm個の要素を持つベクトルになります。
h= h1h2⋮hm=σ(1)(z1(1))σ(1)(z2(1))⋮σ(1)(zm(1))
第2層の線形変換の重み行列W(2)は1×mで、バイアスb(2)はスカラーとします。
W(2)=[w1(2)w2(2)⋯wm(2)]
よって、線形変換z(2)=W(2)h+b(2)は以下になります。
z(2)= w1(2)h1+w2(2)h2+⋯+wm(2)hm +b(2)
結果として、z(2)はスカラーになっています。このz(2)に活性化関数σ(2)を適用したのが、このニューラルネットワーク全体の出力yになります。
y=σ(2)(z(2))
そして、損失はL(y,y∗)です。
バックプロパゲーション
損失から誤差逆伝播を行います。まずは、第2層の各パラメータによる損失Lの偏微分を考えます。
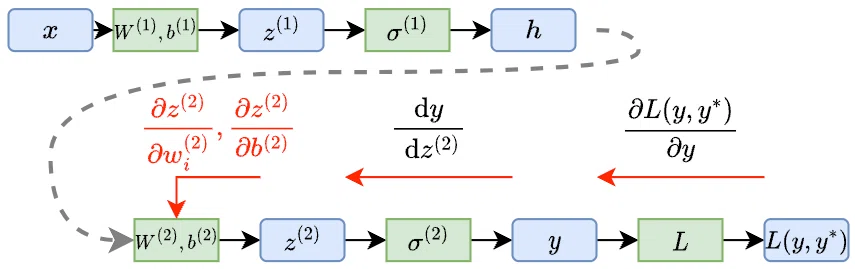
隠れ状態hを中間層への入力と考えると、第2層の計算は「1層のニューラルネットワーク」と同じ処理になります。よって、第2層の各パラメータによる損失Lの偏微分は以下になります。
∂wj(2)∂L∂b(2)∂L= ∂y∂L⋅dz(2)dy⋅∂wj(2)∂z(2)= ∂y∂L⋅σ(2)′⋅ hj= ∂y∂L⋅dz(2)dy⋅∂b(2)∂z(2) = ∂y∂L⋅σ(2)′
次に、第一層の各パラメータによる損失Lの偏微分を考えます。∂y∂L⋅dz(2)dyに関しては上記ですでに考慮されているので、残りの偏微分を計算します。
第2層の線形変換の結果z(2)=W(2)h+b(2)から偏微分を連鎖させます。
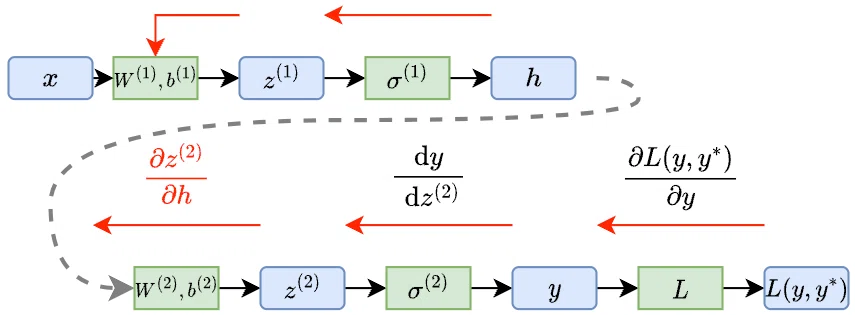
z(2)はスカラーであり、これをhの各成分で偏微分します。
∂h∂z(2)=[ ∂h1∂z(2)∂h2∂z(2)⋯∂hm∂z(2) ]= [ w1(2)w2(2)⋯wm(2) ]=W(2)
なお、ベクトルによる微分についてはこちらでも解説しています。
次に、隠れ状態h=σ(1)(z(1))の偏微分を計算します。
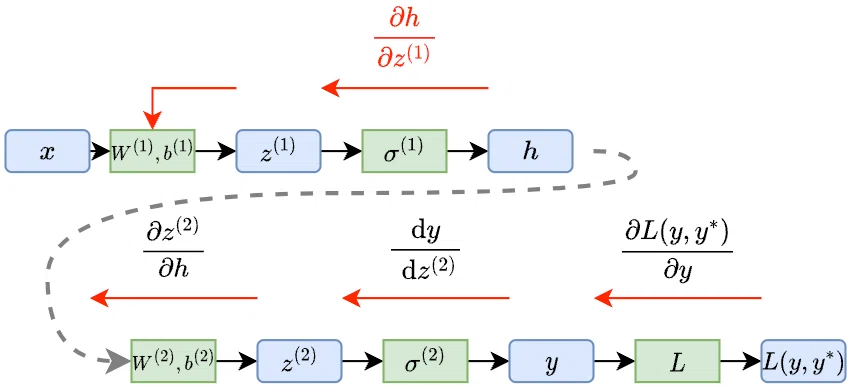
なお、hはベクトルであり、これをベクトルz(1)の各要素で偏微分するのでヤコビ行列(各成分が∂zj(1)∂hi)となります。
∂z(1)∂h = ∂z1(1)∂h1∂z1(1)∂h2 ⋮∂z1(1)∂hm∂z2(1)∂h1 ∂z2(1)∂h2⋮ ∂z2(1)∂hm⋯⋯⋱⋯ ∂zm(1)∂h1 ∂zm(1)∂h2⋮ ∂zm(1)∂hm= σ(1)′(z1(1))0 ⋮0 0 σ(1)′(z2(1))⋮ 0⋯⋯⋱⋯ 00⋮ σ(1)′(zm(1))
対角線上以外の要素が0になっているのは、hi=σh(zi)が一変数の関数で他の要素に依存しないからです。
次は、第1層の線形変換z(1)=W(1)x+b(1)の偏微分を計算します。
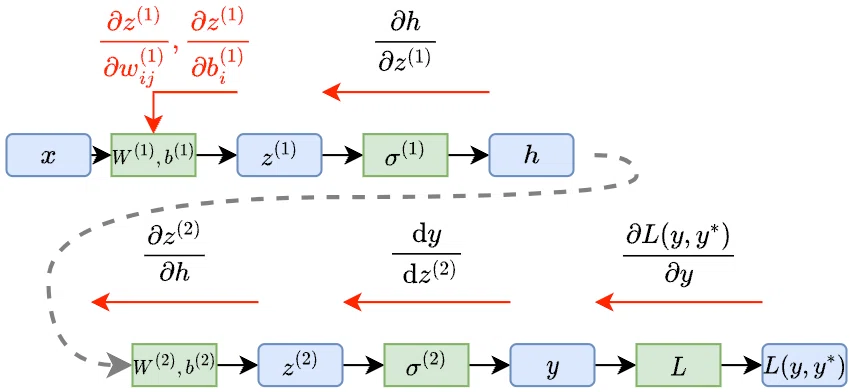
z(1)はベクトルであり、これを各パラメータで偏微分します。
重み行列の成分wij(1)での偏微分では、z(1)のi行目以外は0になります。また、wijはxjの係数なのでxjだけが残ります。
∂wij∂z(1)= ∂wij∂z1(1)∂wij∂z2(1)⋮∂wij∂zi(1)⋮∂wij∂zm(1)= 00⋮xj⋮0
同様に、ベクトルz(1)をバイアスの成分bi(1)で偏微分します。
∂bi∂z(1)= ∂bi∂z1(1)∂bi∂z2(1)⋮∂bi∂zi(1)⋮∂bi∂zm(1)= 00⋮ 1 ⋮0
以上より、第一層の各パラメータによる損失Lの偏微分は以下になります。
∂wij∂L∂bi∂L= ∂y∂L⋅dz(2)dy⋅∂h∂z(2)⋅∂z(1)∂h⋅∂wij∂z(1)= ∂y∂L⋅dz(2)dy⋅∂h∂z(2)⋅∂z(1)∂h⋅∂bi∂z(1)
なお、最後3つの偏微分の連鎖の最終形はともに(1×m)⋅(m×m)⋅(m×1)なのでスカラーとなることがわかります。
また、2つの層のすべてのパラメータに関する偏微分をまとめるとニューラルネットワーク全体の勾配になります。
まとめ
2層のニューラルネットワークでも、誤差逆伝播の処理は1層の場合と同じアプローチの繰り返しで行えることが確認できました。具体的な微分や偏微分の計算内容は、関係するベクトルや行列の形状によって異なりますが、全体としては微分の連鎖律に基づいて勾配を計算している点は同じです。
したがって、もっと層を追加しても同様のアプローチで誤差逆伝播を適用できると理解できます。
関連記事