前回は、再帰型ニューラルネットワークを一般化した形で解説しました。
主に以下のRNNの構成パターンを紹介しました。
回帰・分類:最後の隠れ状態から予測を行う
時系列処理:各ステップから予測を出力する
Seq2Seq:エンコーダ・デコーダ機械翻訳
積み重ねる:多層化による複雑な特徴量抽出
RNNでは、これらの組み合わせが可能であり、複雑にもなりがちですが、同時に非常にフレキシブルになっています。
そこで今回紹介するのは、すべてのRNNの構成パターンにおける学習を支える仕組BPTT(Backpropagation Through Time、時間軸に沿った誤差逆伝播法)です。
前回のように図と式を使いながら、RNNでの誤差逆伝播法がどのような手順で処理されるのかを解説します。
関連記事の紹介
なお、今回はベクトルによる微分や誤差逆伝播の基本的な理解を必要とします。必要に応じて、以下の記事も参考にしてください。
BPTTの概要
再帰型ニューラルネットワーク(RNN)における誤差逆伝播法の基本的なアプローチは、RNNの図を展開してフィードフォワード型のニューラルネットワークと同じように扱うことです。
以下は、RNNの再帰構造を示した図です。
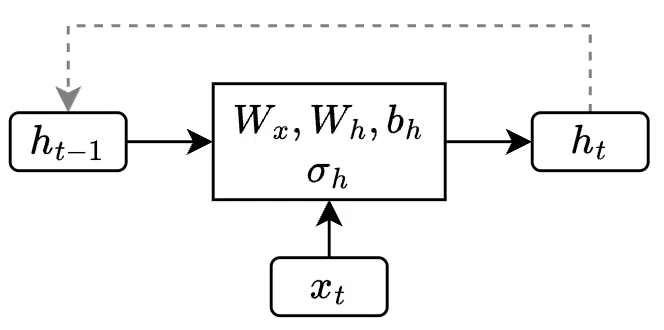
この図を実行されたステップ数だけ展開してやれば、フィードフォワード型と同じように損失関数から誤差逆伝播法を使って勾配が計算できます。
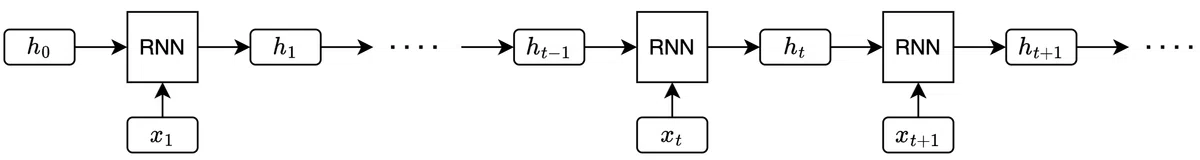
この手法では誤差逆伝播を時間軸(ステップ)に沿って行うので、BPTT(Backpropagation Through Time)と呼ばれます。
ただし、RNNでは各ステップにおいて同じパラメータが繰り返し使用されるためフィードフォワード型における誤差逆伝播とは少し異なります。また、RNNにはさまざまなパターンがあるので偏微分を連鎖がどのようにつながっていくかを理解することが重要です。
最後の隠れ状態から予測を行う場合
まず、最後の隠れ状態からの予測出力yだけを使うパターンを考えます。
フィードフォワード処理
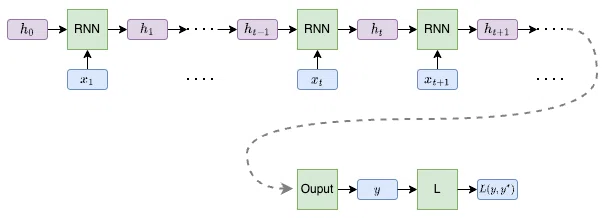
上図における「緑色の箱」は何らかの計算を行う関数であり、入力変数や関数内のパラメータによって微分することが可能だとします。
この「RNN」の箱をRNN層と呼び、線形変換と非線形変換の両方が含まれているとします。RNN層は、ステップtの隠れ状態htを次のように計算します。
ztht=Wxxt+Whht−1+bh=σh(zt)
それぞれのシンボルを以下のように定義しました。
t:1から始まるステップ数
xt:入力ベクトル(要素数n)
Wx:入力ベクトルに対する重み行列(m×n)
ht:隠れ状態ベクトル(要素数m)
Whは隠れ状態$に対する重み行列(m×m)
bh:バイアスベクトル(要素数m)
zt:線形変換の結果(要素数m)
σh:活性化関数(要素ごとの非線形変換)
WxとWhとbhは、すべてのステップで共有されます。つまり、同じパラメータが何度も使われることになります。また、h0はゼロベクトルとします。
「Output」は出力層で線形変換か非線形変換あるいは両方を行いますが、微分できる関数であることだけが重要で、中身は特に考えません。
「L」は損失関数で予測値yと正解値y∗を使って計算します。これも微分可能とします。
バックプロパゲーション
RNN層のパラメータに関する損失Lの偏微分を考えます。
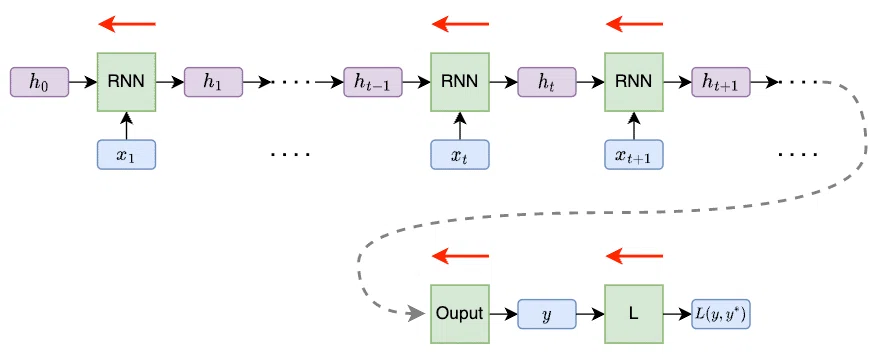
損失Lからステップtの隠れ状態htへと偏微分を連鎖させると以下になります。
∂ht∂L= ∂y∂L⋅∂hn∂y⋅∂hn−1∂hn⋯∂ht∂ht+1
このとおり、誤差逆伝播を時間軸(ステップ)に沿って行なっています。なお、最後のステップnに関する偏微分だけは以下になります。
∂hn∂L=∂y∂L⋅∂hn∂y
ここで、∂ht∂Lの形状について考えてみます。
∂y∂Lはスカラー
∂hn∂yは1×m
∂hn−1∂hnはm×m
∂ht∂ht+1はm×m
よって、(スカラー)⋅(1×m)⋅(m×m)⋅(m×m)なので、∂ht∂Lの形状は(1×m)になっています。最後のステップnでも同じです。
ここでは、スカラー値関数をベクトルで微分すると、ベクトルの成分と同じ数の偏微分を持つベクトルになることを利用して形状を計算しています。
また、ベクトルをベクトルで微分するとヤコビ行列(各変数に対する偏微分を成分とする行列)になり、変数の組み合わせの数だけ成分を持ちます。
ベクトルと行列の微分さらに、RNNの中の計算に入って偏微分の連鎖を続けます。
∂zt∂L= ∂ht∂L⋅∂zt∂ht
∂zt∂htの形状は(m×m)なので、∂zt∂Lの形状は(1×m)⋅(m×m)⇒(1×m)となります。
次に、各パラメータに関する損失Lの偏微分を計算します。まず、重み行列Wxの成分(Wx)ijによる偏微分は以下になります。
∂(Wx)ij∂Lt= ∂zt∂L⋅∂(Wx)ij∂zt
ここで、ステップtであることを明示するためにtをつけました。
∂(Wx)ij∂ztの形状はm×1であり、∂(Wx)ij∂Ltの形状は(1×m)⋅(m×1)となり、これはスカラーです。
全てのステップの偏微分を足し合わせることで各パラメータの影響をまとめます。
∂(Wx)ij∂L=t=1∑n ∂(Wx)ij∂Lt
よって、各パラメータに関する損失Lの偏微分は以下になります。
∂(Wx)ij∂L ∂(Wh)ij∂L ∂(bh)i∂L = t=1∑n ∂(Wx)ij∂Lt = t=1∑n∂zt∂L⋅∂(Wx)ij∂zt= t=1∑n ∂(Wh)ij∂Lt = t=1∑n∂zt∂L⋅∂(Wh)ij∂zt= t=1∑n ∂(bh)i ∂Lt = t=1∑n∂zt∂L⋅ ∂(bh)i ∂zt
∂zt∂Lの中には、ステップtによって異なる長さの偏微分の連鎖が含まれています。
なお、出力層にパラメータがある場合は、その各パラメータに対する損失Lの偏微分も計算する必要があります。ただし、ここではRNN層のパラメータにフォーカスしているので考えません。
全てのパラメータに関する損失の偏微分をBPTTで計算し、一つのベクトルにまとめると勾配となります。その勾配とは逆方向にパラメータを更新することで損失を減少させるのが勾配降下法です。
各ステップから予測を出力する場合
次に、各ステップの隠れ状態htからの予測出力ytを使いパターンを考えます。
各ステップの損失に対する誤差逆伝播
このパターンでは、各ステップにおいて損失のLtが計算されます。
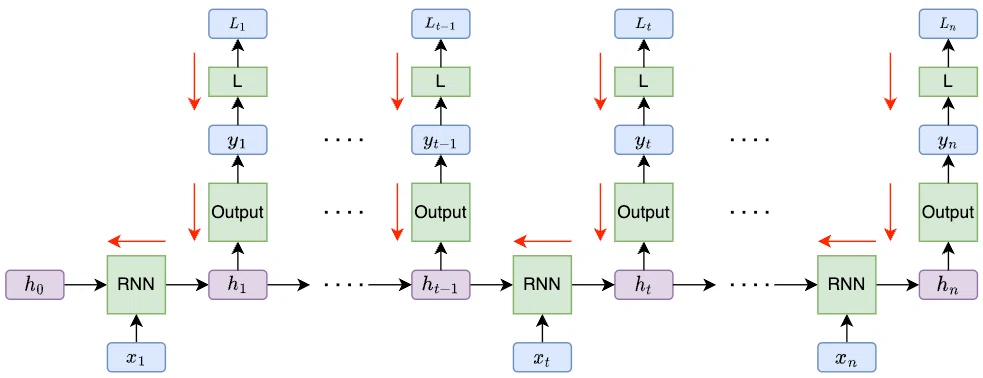
全体の損失Lallは、各ステップからの損失Ltの合計です。
Lall=t=1∑nLt=t=1∑nL(yt,yt∗)
隠れ状態 htに関する損失の偏微分は、損失Lk(k≥t)に対して計算され合計されます。
∂ht∂Lall=k=t∑n∂ht∂Lk
一つの損失Lkに注目して時間軸に沿った形式に展開してみます。
∂ht∂Lk= ∂yk∂Lk⋅∂hk∂yk⋅∂hk−1∂hk⋯∂ht∂ht+1
なお、k=tの場合は以下になります。
∂hk∂Lk= ∂yk∂Lk⋅∂hk∂yk
これは「最後の隠れ状態から予測を行う」パターンと同じ逆伝播を示しています。
このように展開すると「それぞれの損失からの逆伝播の結果の合計」のイメージが掴みやすいです。ただし、以降は全体の損失Lallを使って簡潔に話を進めます。
全体の損失を各パラメータで偏微分
RNN層の中の計算に入って偏微分の連鎖を続けます。
∂zt∂Lall=∂ht∂Lall⋅∂zt∂ht
次に、各パラメータに関するLallの偏微分を計算します。まず、重み行列 Wxの成分(Wx)ijによる偏微分は以下になります。
∂(Wx)ij∂Lallt=∂zt∂Lall⋅∂(Wx)ij∂zt
ここで、ステップtであることを明示するためにtをつけました。
全ステップの偏微分を足し合わせることで各パラメータの影響をまとめます。
∂(Wx)ij∂Lall=t=1∑n ∂(Wx)ij∂Lallt
よって、各パラメータに関するLallの偏微分は以下になります。
∂(Wx)ij∂Lall ∂(Wh)ij∂Lall ∂(bh)i∂Lall = t=1∑n ∂(Wx)ij∂Lallt = t=1∑n∂zt∂Lall⋅∂(Wx)ij∂zt= t=1∑n ∂(Wh)ij∂Lallt = t=1∑n∂zt∂Lall⋅∂(Wh)ij∂zt= t=1∑n ∂(bh)i ∂Lallt = t=1∑n∂zt∂Lall⋅ ∂(bh)i ∂zt
こうしてみると「最後の隠れ状態から予測を行う」パターンと同じ形に見えますが、「各ステップから予測を出力する」パターンでは、全てのステップの損失の合計Lallに対して、各パラメータの偏微分を計算しています。
つまり、各ステップtではそれ以降のステップの損失(Lt,Lt+1,…,Ln)を考慮して誤差逆伝播を行なった結果を合計している点で「最後の隠れ状態から予測を行う」パターンと特に異なっています。
エンコーダ・デコーダを使う場合
エンコーダ・デコーダにおけるBPTTは、「最後の隠れ状態から予測を行う」と「各ステップから予測を出力する」の両方のパターンの応用として理解できます。ここでは、「アテンションがない」パターンと「アテンションがある」パターンに分けて考察します。
アテンションがないパターン
アテンションがない場合は、エンコーダからの最後の隠れ状態をデコーダに渡します。よって、エンコーダは「最後の隠れ状態から予測を行う」パターンとほぼ同じです。異なるのは、その後の出力層の部分がデコーダになっているところです。よって、誤差逆伝播はデコーダの損失から最後の隠れ状態を通して伝わってきます。
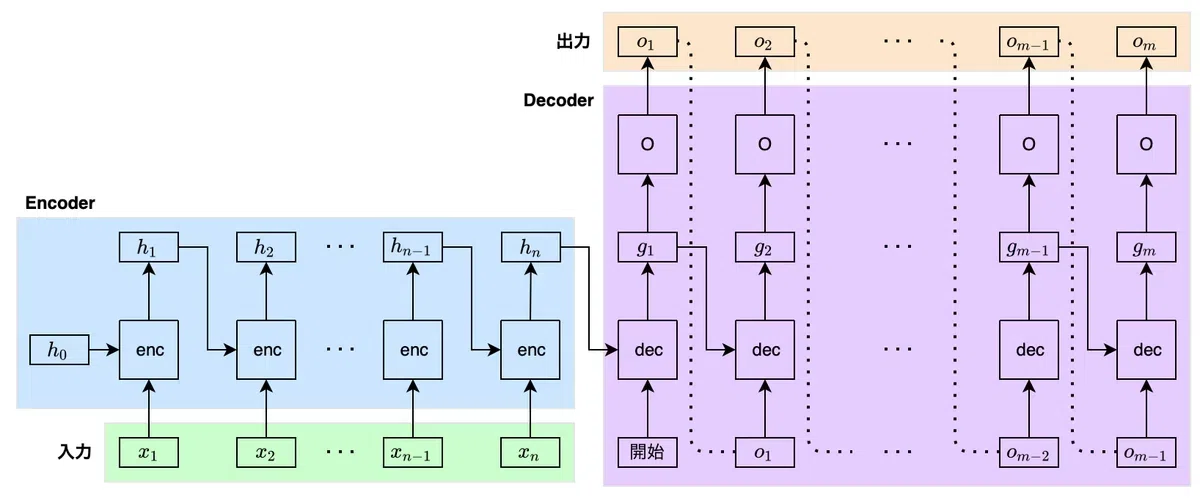 エンコーダ・デコーダ
一方、デコーダはエンコーダからの最後の隠れ状態を入力として、各ステップで予測値を出力します。よって、損失も各ステップで計算されるため「各ステップから予測を出力する」パターンと同じ考え方になります。
つまり、デコーダの各ステップの損失を使って誤差逆伝播が行われ、デコーダ内のパラメータに対して勾配が計算された後、偏微分の連鎖はエンコーダへと伝わります。このため、デコーダの損失がエンコーダのパラメータにも影響を与える形でエンコーダの勾配が計算されます。
これによって、エンコーダはデコーダの予測の損失が低くなるよう学習し、またデコーダをエンコーダからの情報(文脈など)をうまく使うことを学びます。
アテンションがあるパターン
アテンション機構は、エンコーダの各ステップの隠れ状態にアクセスします。
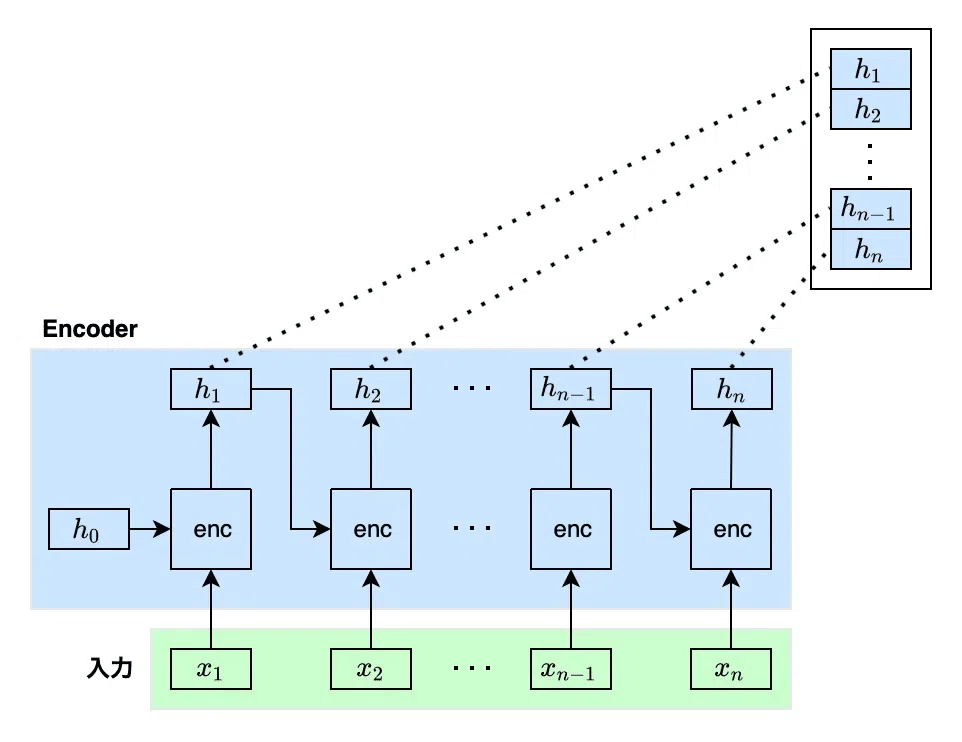
デコーダの各ステップは、アテンション機構を通してエンコーダの各隠れ状態に対するスコア(アテンションの重み)を計算します。これに基づいてエンコーダの各隠れ状態からデコーダへの出力が決定されます。
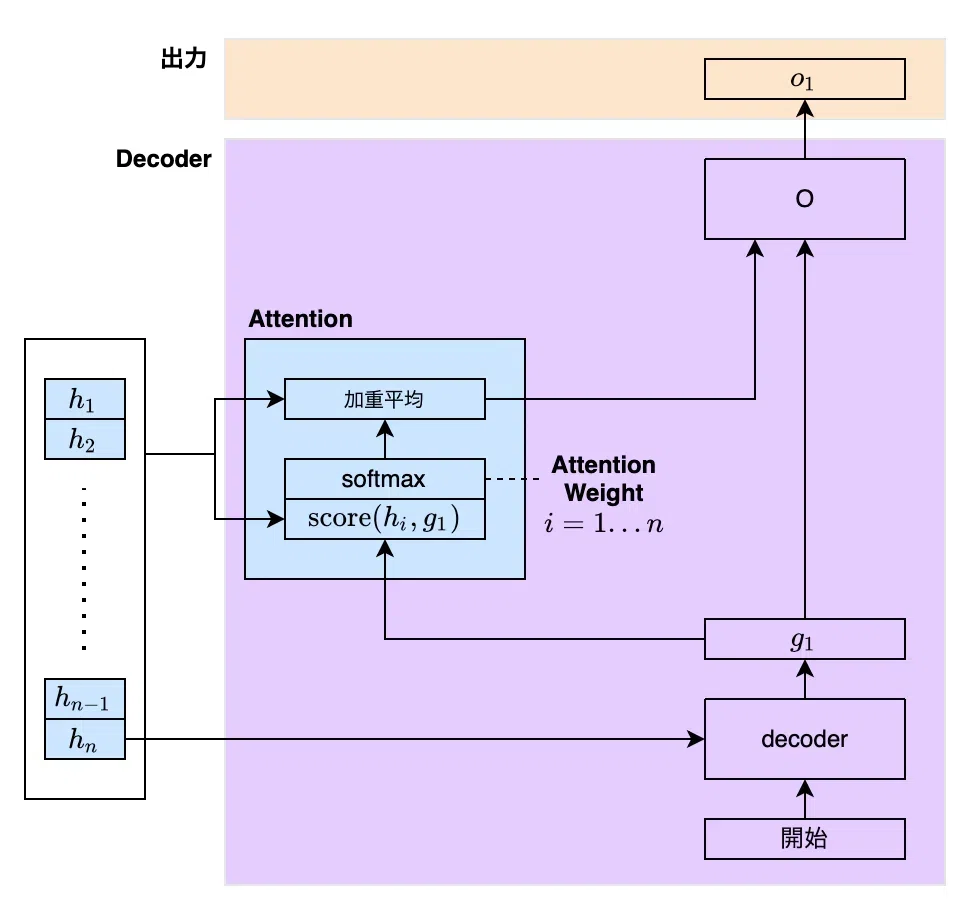
つまり、アテンション機構がある場合、デコーダはエンコーダの各ステップの隠れ状態にアクセスします。これによって最後の隠れ状態だけを使う場合よりも「直接的に、しかも必要に応じて」各ステップの情報を得ることができます。結果として、エンコーダのすべてステップの隠れ状態(文脈)が、より効率的にデコーダの出力に影響するようになります。
したがって、デコーダの各ステップで計算された損失が、アテンション機構を通じてエンコーダの各隠れ状態に個別に伝わり、それぞれに対して異なる勾配が(スコアに応じて)計算されます。これにより、エンコーダの全ステップがデコーダの損失に基づいて細かく調整されるため、学習効率が高まります。
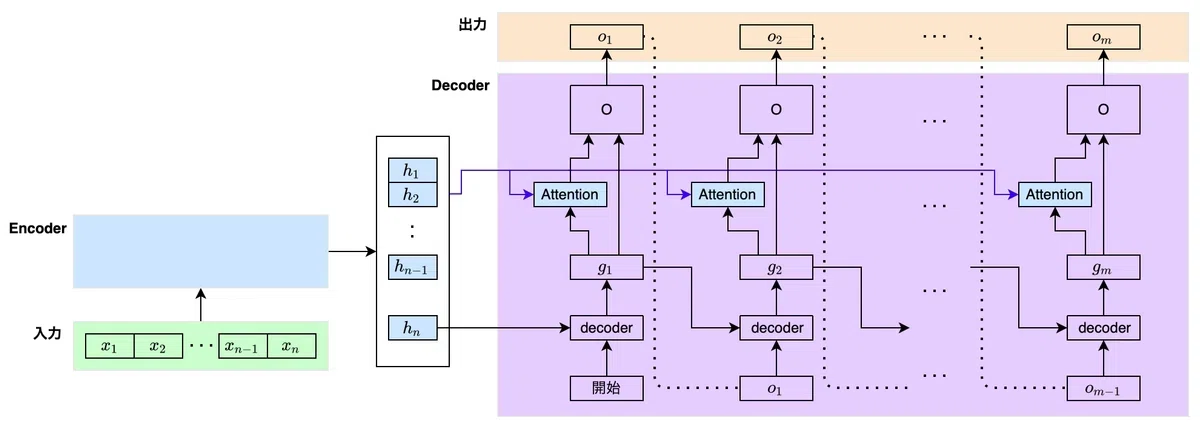
この仕組みを通して学習を繰り返すことで、アテンションは文脈に従って重みを調節できるようになり、デコーダは必要な情報を得ることができるようになります。
このように、誤差逆伝播の観点からアテンションを眺めるとその役割や意義がよくわかります。
RNNを積み重ねて使う場合
多層RNNは、下層RNNからの隠れ状態を入力として上層RNNが学ぶようになっています。これによって、複雑で抽象的な特徴をシーケンスから捉えることを目指しています。
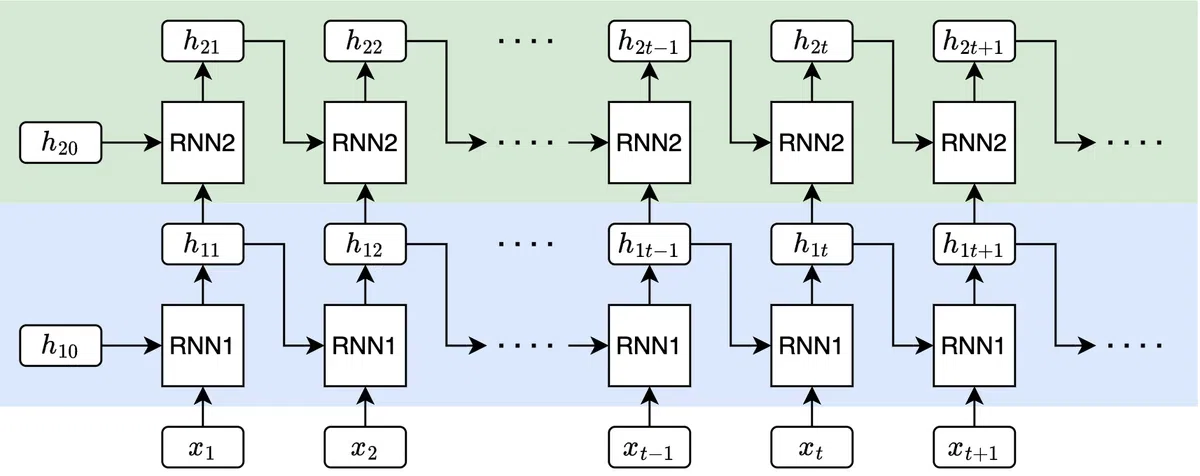
最上層のRNNが「最後の隠れ状態から予測を行う」パターンか「各ステップから予測を出力する」パターンかによって損失の計算が変わってきます。しかし、下層のRNNからすると上層から伝わってくる偏微分の連鎖を計算することに変わりはありません。よって、下層のRNNは「各ステップから予測を出力する」パターンとほぼ同じですが、損失が上層のRNNを通して伝わってくるところが異なります。
RNNの問題点
前回と今回でRNNのさまざまなパターンとBPTTを紹介しました。そのフレキシブルな仕組みによってたくさんのケースに同じ学習の仕組みで対応できることがわかりした。しかし、RNNにはいくつかの問題があります。
計算コストと並列処理の問題
RNNのフィードフォワード処理は、各ステップが直前のステップに依存しているため、全タイムステップを一度に処理することができません。
よって、並列処理が難しく、シーケンスを逐次的に処理するため、計算時間がかかります。特に、長いシーケンスデータを扱う場合、学習が遅くなりがちです。
また、BPTTで利用するために各ステップの隠れ状態を保存するので、メモリの消費量もシーケンスの長さに応じて増加します。パラメータが多いモデルでは、このメモリ消費によって計算が遅くなる原因となることもあります。
長期の依存関係の学習が困難
RNNは、直前の「隠れ状態」から次の「隠れ状態」へと情報を伝えるため、長期的な依存関係を持つシーケンスからの学習が難しい場合があります。
例えば、長い文章の冒頭に出現する情報が、後半に登場する単語やフレーズの予測に影響を与える場合、RNNではその情報を長期にわたって適切に保持し続けることが難しいです。なぜなら、RNNは離れたステップを直接結びつける仕組みを持たないからです。
そのため、隠れ状態ベクトルの限られた容量によって情報を伝達するしかなく、長いシーケンスを処理する際には「途中で重要でないと判断された情報」は失われやすくなります。一度失われた情報は復元できないため、長期依存関係を学習するのが難しくなります。
勾配消失と勾配爆発
RNNの最もよく知られた問題の一つが、勾配消失(vanishing gradient)と勾配爆発(exploding gradient)です。これらは他のニューラルネットワークでも発生しますが、RNNは可変長のシーケンスを扱えるため、特にこの問題が顕著になりやすいです。
BPTTでは、各ステップで連鎖的に勾配が計算されるため、長い時系列データを扱うと、「逆伝播される勾配が非常に小さくなる」勾配消失や「逆伝播される勾配が非常に大きくなる」勾配爆発が起こりやすくなります。勾配消失が発生すると学習が進まなくなり、勾配爆発が起こるとパラメータが急激に変動して学習が不安定になります。
次回予告
RNNは、「過去の情報を伝達する再帰の仕組み」を中心に、柔軟な構成によってシーケンス処理を行うことが理論的には可能です。しかし、構造上のいくつかの課題があり、実用における困難が浮き彫りになりました。
上述した「計算コストと並列処理の問題」、「長期の依存関係の学習が困難」、そして「勾配消失と勾配爆発」がそれにあたります。これらの課題により、RNNによる学習の限界が明らかになり、改善を求められるようになりました。
そのため、LSTM(Long Short-Term Memory)やGRU(Gated Recurrent Unit)といったアーキテクチャが開発され、RNNの代替として活用されるようになりました。特に、近年ではRNNというと、実際にはLSTMを指していることも少なくありません。
次回は、LSTM(Long Short-Term Memory)による、長期の記憶と短期の記憶を使い分ける仕組みを紹介します。
お楽しみに!


