前回は、DDPMの拡散過程を連続時間へと拡張したVP-SDEを紹介しました。これにより、DDPMはスコア関数を間接的に学習する スコアベース生成モデル の一種として解釈できることを示しました。
VP-SDEは「分散保存型」(Variance Preserving)であり、拡散過程を通じて分散がほぼ一定に保たれるようにノイズの加え方が設計されています。
これは、元画像の分散が1に近いことを前提に、元の信号の分散と加えられるノイズの分散の合計を一定に保つスケジュールです。
なお、スコアベース生成モデルの拡散過程は、この「分散保存型」だけにとどまりません。たとえば、VP-SDEよりも分散の付加がわずかに抑えられるsub-VP-SDEがあります。
また、VE-SDEは「分散発散型」(Variance Exploding)と呼ばれ、時刻が進むにつれて状態分布(ピクセル値)の分散が大きくなるように設計されています。特に拡散過程の後半では、ノイズのスケールが急激に増加します。
これら3つのパターンはSongらの論文「Score-Based Generative Modeling through Stochastic Differential Equations」において整理されています。
それぞれ拡散の仕方が異なり、学習の安定性と生成の多様性に違いをもたらします。
まずは、「分散を保存する理由」と「分散を発散する狙い」を理解し、その後に3つのパターンの違いを解説します。
分散を保存・発散したい理由
なぜ分散を保存したいのか
前回紹介したVP-SDEは、実装的に成功したDDPMを連続時間に拡張し、スコアベース生成モデルとして再解釈したものです。
VP-SDEは、拡散過程を通して状態(画像)の分散がほぼ一定に保たれるようにノイズスケジュールが設計されています。このため「分散保存型」と呼ばれます。
前述したように、元画像の分散が近似的に1であることを仮定しています。
分散を一定に保つため、時刻tが進むにつれて元画像の信号成分を減衰させ、その分をガウスノイズ成分で置き換えていきます。この結果、画像は徐々に意味を失い、最終的には完全なノイズ(標準正規分布)に近づきます。
分散を保存する最大の利点は、極端に大きなノイズが発生せず、数値計算的に安定する点にあります。状態のスケールが時間を通じてほぼ一定であるため、学習も安定しやすくなります。
sub-VP-SDEは、全体分散をVP-SDEよりわずかに小さく抑えることで、生成モデルの学習時の復元誤差を減少させ、生成過程での出力の安定性と品質を向上させる設計となっています。
なぜ分散を発散させたいのか
VE-SDEは「分散発散型」(Variance Exploding)と呼ばれ、時間の経過とともに状態の分散が大きくなるように設計された拡散過程です。
開始時点ではわずかなノイズしか含まれませんが、時間が進むにつれてノイズの強度が急速に増加し、元画像の情報は比較的早い段階で失われます。
このため、分散保存型に比べて学習が不安定になる可能性があります。それでも分散を発散させるのは、以下のような狙いがあるからです。
つまり、学習の安定性が低下するリスクはありますが、生成の多様性やスコア推定の簡易化といった利点を重視する目的で使われます。
拡散過程の3パターンの比較
フォワードSDEの一般形
まず、スコアベース生成モデルにおける拡散過程の一般形をおさらいします。
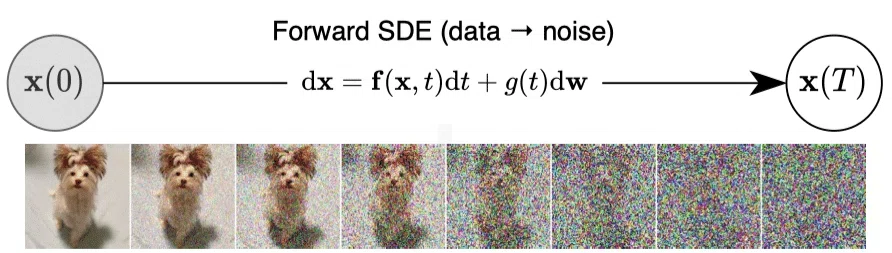 論文:図1(上部)
dx=f(x,t)dt+g(t)dw
dx:画像xの微小な変化
f(x,t)dt:ドリフト項(平均的な変化)
g(t):拡散係数(ノイズのスケール)
dw:ブラウン運動(標準正規分布に基づくガウスノイズ)
スコアベース生成モデルでは、このドリフト項と拡散項の設計によって、拡散過程の性質をデザインできます。そして、拡散過程のSDEの定義から逆向きのSDE(リバースSDE)を導くことで、学習したスコア関数を使ってノイズから画像を生成できます。
拡散によって、意味がある画像が「疎」な確率分布から、ノイズ中心の「密」な確率分布に移行することで逆過程の学習が可能になっています。
VP-SDE、sub-VP-SDE、VE-SDEの違いは、この拡散過程におけるドリフト項と拡散係数の時間変化に現れます。それぞれを順番に見ていきましょう。
VP-SDEの拡散過程
おさらいになりますが、「分散保存型」であるVP-SDEのドリフト項と拡散係数は次のように定義されます。
dx=−21β(t)xdt+β(t)dw
ドリフト項f(x,t)dt=−21β(t)xdtは、画像の元データを減衰させる
拡散項g(t)dw=β(t)dwは、画像のノイズ成分を増加させる
この確率微分方程式は「伊藤の補題」(Itô's lemma)によって解かれます。
VP-SDEの解は以下になります。
x(t)=α(t)x0+σ(t)ϵ,ϵ∼N(0,I)
データセットにある元画像の分散がVar[x0]=1であると仮定すると、全体の分散が拡散過程を通して1に保たれます。
VarVP[x(t)]=α2(t)Var[x0]+σ2(t)=α2(t)+(1−α2(t))=1
なお、ここでの分散Var[x(t)]は、正確には共分散行列を指しますが、各成分(ピクセル)の分散が等しく、相互に相関がないと仮定しているので、スカラーとして記述しています。
次に見るsub-VP-SDEでは、ドリフト項はこのままにして、拡散係数だけを変更します。
sub-VP-SDEの拡散過程
sub-VP-SDEのドリフト項と拡散係数は次のように定義されます。
dx=−21β(t)xdt+β(t)(1−exp(−2∫0tβ(s)ds))dw
VP-SDEの拡散過程と同じドリフト項になっていますが、拡散係数の計算が異なります。以下の指数が含まれています。
exp(−2∫0tβ(s)ds)
ここでβ(t)>0なので、その積分は正となり、指数項の0<exp(⋯)≤1になります。これを1から引くため、拡散係数はVP-SDEの場合よりも小さくなります。
この違いが画像成分(状態)の分散にどう影響するのかを見ていきます。
まず、VP-SDEでは、時間tの状態分散は以下でした。
VarVP[x(t)]=α2(t)+(1−α2(t))=1
同じくVar[x0]=1を仮定して、sub-VP-SDEを解くと状態分散は次のようになります。
Varsub-VP[x(t)]=α2(t)+(1− α2(t))2≤1
つまり、sub-VP-SDEの方がVP-SDEよりも全体の分散が低くなります。このため「サブ」VP-SDEと呼ばれます。
どの程度の違いになるのかは、α(t)によります。
α(t)=exp(−21∫0tβ(s)ds)
通常β(t)は初期に極めて小さく(例:10−4)、序盤ではα(t)≈1です。
このため、VP-SDEと比較すると、sub-VP-SDEは特に初期段階では元データの特徴が壊されにくく、逆拡散過程での復元精度(生成精度)の向上が期待できます。
ただし、このノイズ分散の差は時間とともに縮まり、最終的には全体の分散は標準正規分布に近づきます。そのため、sub-VP-SDEでも逆拡散過程は標準正規ノイズから始められます。
まとめると、sub-VP-SDEは、ノイズ蓄積をわずかに抑制し、特に初期のノイズ負荷を減らすことで学習の安定性や生成の品質向上を狙っています。
VE-SDEの拡散過程
VE-SDEのドリフト項と拡散係数は次のように定義されます。
dx=dtd[σ2(t)]dw
論文では次の形のσ(t)が使われています。
σ(t)=σmin(σminσmax)t
ここで、σ(t=0)=σmin、σ(t=1)=σmaxとなります。時刻tが進むにつれて、σ(t)は指数関数的に増加します。
VP-SDEでは線形スケジュールが使われるのと比較すると違いが明白です。
g(t)=βmin+(βmax−βmin)t
このSDEを解くと、時刻tの状態は以下になります。
x(t)=x0+σ(t)ϵ,ϵ∼N(0,I)
状態分散は、時間経過によるσ(t)の増加に伴い急速に大きくなります。
VarVE[x(t)]=Var[x0]+σ2(t)
これが「分散発散型」と呼ばれる所以です。
また、この式を見てわかるようにσ2(t)はある時点までに累積された分散の大きさを示しています。そのため、ある瞬間のノイズ強度は分散の時間微分の平方根g(t)=dtdσ2(t)となります。
では、実際のg(t)はどうなっているのでしょうか。
dtd[σ2(t)]は、以下の微分の公式を利用して計算できます。
dxd(ax)=ax loga
これを覚えていない場合にはax=exp(log(ax))=exp(log(a)x)として指数関数の微分を利用すれば思い出せます。
dxd(ax)=dxd[exp(log(a)x)]=log(a)exp(log(a)x)=axloga
よって、拡散項は以下になります。
dtd[σ2(t)]dw=dtd[(σmin(σminσmax)t)2]dw=σmin2dtd[((σminσmax)2)t]dw=σmin2((σminσmax)2)tlog((σminσmax)2) dw=σmin(σminσmax)t 2log(σminσmax) dw
以上から、累積標準偏差σ(t)によって累積分散の時間変化をデザインし、また拡散係数g(t)を計算できるため、それを実装することが可能となります。
注意点:分散保存型に比べて学習が不安定になりやすく、σminとσmaxによるスケジュールの設計が重要になります。大きすぎるσmaxは発散やモード崩壊(同じ画像ばかり生成される)の原因になる可能性があります。
次回予告
ここまで無条件の拡散モデルを中心に解説してきましたが、実際の画像生成AIの多くは、テキストなどの条件を与えて出力を制御します。
次回は、その条件付き拡散モデルの中でも、オープンソースとして初めて広く利用可能になり、生成AIの普及に大きな影響を与えた Stable Diffusion を紹介します。
お楽しみに!


