小さいLLMの自信ある誤りを辞書の説明文で直す――語義選びだけLLMにさせると取り違え72%→10%



前回(E4・E5)は、小さなAI(Gemma-2 2B)の「X は C の一種か」という答えを網にまとめ、ルールで確かめました。 ルールでは、Gemma が強い自信で言い切る誤りはあまり直せませんでした(例:「beagle is a type of sport」に強く Yes)。
今回は外の資料として Wiktionary の説明文 を使い、3段で調べました。
- E6:物の語 X の説明文を見せると、自信ある誤りがどれだけ直るか。正しい答えをどれだけ壊すか。
- E7:説明文の頭の名詞(genus)を3段までたどる(granddaughter → daughter → person → mammal)。
- E8:鎖の途中の語の 語義を1つ選ぶ 方法を4通り比べ、決め方に使っていない新しい300問で確かめる。
結論を先に書きます。
- 説明文で、自信ある誤り81問の約4分の3が直りました(外の NLI で判定して 75%、説明文をプロンプトに入れて聞き直すと 70%)。
- ただし、遠回りの正解を壊します。WordNet では「違う」だが常識では正しい68問の 40% を「違う」にしました(「granddaughter is a type of mammal」など。説明文は直接の上位語しか書かない)。
- 鎖でたどると壊すのは 29% に減り、正しい答え177問への「いいえ」も 24%→6% に減りました。ただ、分類に着いた2段以上の道の 64% が途中で語義を取り違えていました(person の「体」の語義を通って body part に着く、など)。
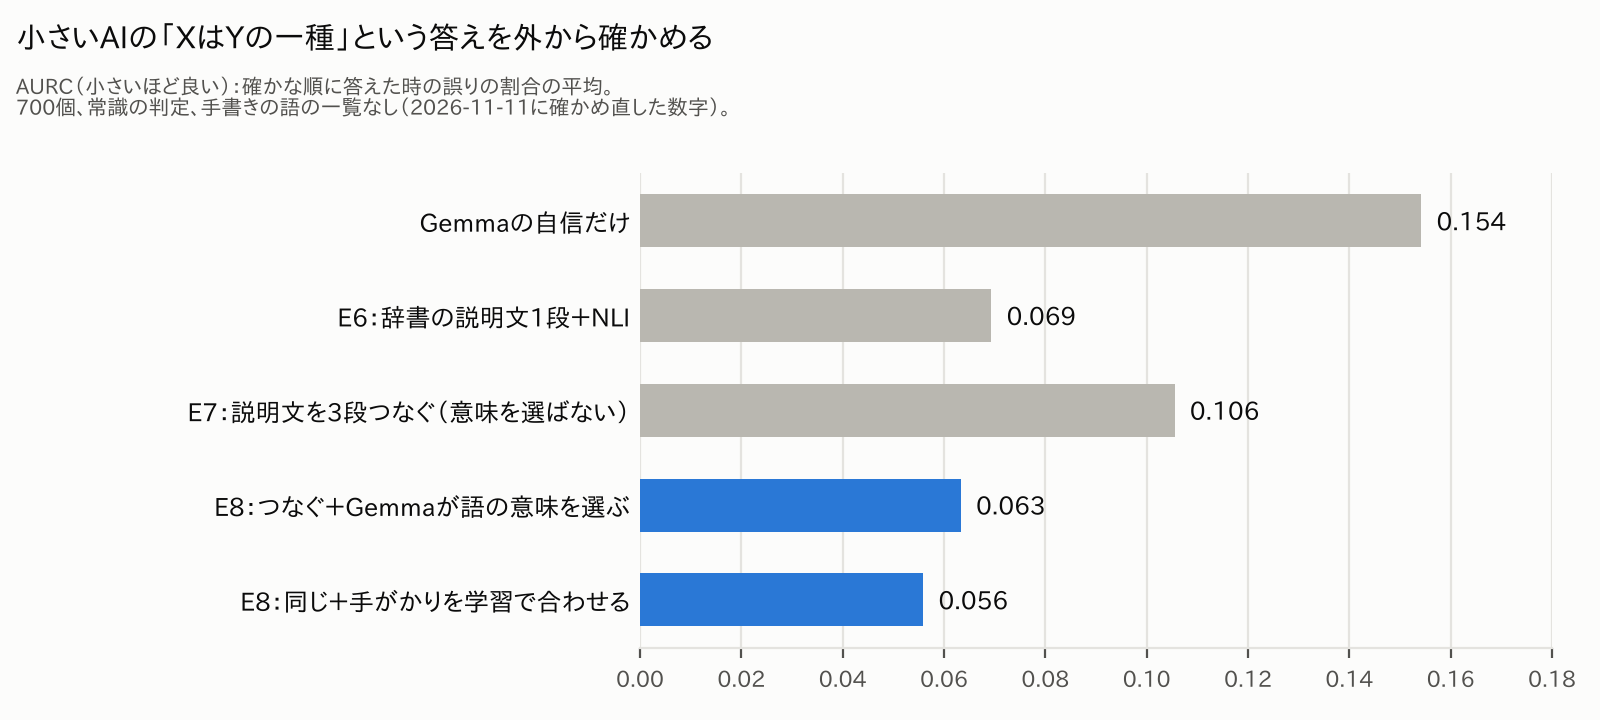
- Gemma に「この説明文の中で、この語はどの語義か」だけを選ばせると、取り違えは 4% に下がりました。(11/11 訂正:手書きの語の一覧なしで確かめ直すと、取り違えは 72% → 10%) 単純な「一番強い道の掛け算」でも、直り 75% を保ったまま、正しい答えへの「いいえ」は 8%、AURC 0.047 でした(一覧なしでは 0.063)。
- 新しい300問でも、Gemma の自信だけ(AURC 0.118)よりはっきり良い(0.039)。ただし説明文1段だけの NLI(0.055)との差は、300問では言い切れませんでした。
- 網(loopy BP)は今回も出番がありませんでした。 両立しない分類への NLI を罰として足しても、一番強い道の掛け算に5回とも負けました。
コードと結果は GitHub にあります。
https://github.com/mst-design2020/akane-e2-experiments (analysis/e6/・analysis/e8/、plans/E6_*.md・plans/E7_*.md・plans/E8_*.md、results/E6/〜results/E8/、Colab は colab/E6_dictionary_gemma.ipynb・colab/E7_chain_definitions.ipynb・colab/E8_sense_choice.ipynb)。Wiktionary の文は CC BY-SA なので、リポジトリからは抜いてあります(ノートが取り直します)。
物差しと問題
- E5 と同じ、常識で見直した700問(「X is a type of C.」)。正解は Claude と Gemini に別々に常識で判定させたもの(人の判定ではない)。主な採点は Claude の判定、Gemini の判定でも同じ向きかを見ます。
- 内訳で使う群:自信ある誤り=Gemma が Yes で常識では違う81問、常識で正しいG=WordNet では違うが常識では正しい68問、T=正しい答え177問。
- AURC(risk–coverage 曲線の下の面積、小さいほど良い)。名詞ごとに5分割、2割を調整用・8割を評価用で5回。判定は実験前に固定し、AURC の差 0.02 以上で5回中4回以上同じ向きなら差あり、率は10ポイント以上で差あり。
- NLI は MoritzLaurer/DeBERTa-v3-large-mnli-fever-anli-ling-wanli。前提
"X" means: <説明文>、仮説X is a type of C.で、含意の確率を使います。
計算のしかた
記号。 "w" means: <説明文>、仮説は W is a type of <語>. です。
1段だけ(③)。
鎖の点。
一番強い道(⑥)。
網(⑦、E8 は打ち消し入り)。 点ごとに
つながりは根→X の各語義(
物差し。 答え
借りた所と独自の所。 段の点の掛け算は Entailer 2022、頭の名詞をたどるのは Chodorow 1985・OntoLearn 2013、語義選びは B が Kovács 2023、C が McIntosh 2009、D が Meconi 2025・ConSeC 2021、網と BP は Bansal 2014、打ち消しは Jiang 2012、AURC は Geifman 2019 の考えです。前提・仮説の文の形、網の因子の形と打ち消しの項
コードが式どおりかは analysis/e8/check_formulas_e8.py で確かめました。一番強い道は道を全部数え上げた値と 4,000 組で一致し、網は点13個以下の問いで、全部の組み合わせの数え上げと比べて木の形で一致、輪のある形で最大 0.015 のずれでした。
E6:説明文を1段だけ見せる
説明文は物の語だけ:S1 WordNet、S2 Wiktionary の英語の名詞の語義すべて(本命、599語中591語)、S3 Wiktionary の1番目の語義。方法は ①自信、②説明文をプロンプトに入れて聞き直す、③外の NLI(一番含む語義)、④Gemma の答えと語義をつなぐ網、⑤特徴+ロジスティック回帰。
| 方法(S2) | 自信ある誤りが直る(81) | T に「いいえ」 | 常識で正しいGを壊す | AURC |
|---|---|---|---|---|
| ① 自信 | 0% | 33% | 4% | 0.154 |
| ② プロンプトに入れる | 70% | 24% | 26% | 0.124 |
| ③ 外で NLI | 75% | 24% | 40% | 0.070 |
| ④ 網 | 20% | 31% | 8% | 0.098 |
| ⑤ 特徴+LR | 68% | 24% | 24% | 0.079 |
- ②と③は 70% 対 75% で同着。どちらも自信の高い誤りほど直りにくい(③:自信の低/中/高で 89/81/56%)。Gemma が文を無視するせいだけでなく、組そのものが難しい(「matchbox is a type of toy」など)。
- 結果を見たあと(参考):NLI だけで並べるのが AURC 一番(0.070)で、Gemma の自信を足すとかえって悪くなりました。資料が段落だった E3 では外の NLI が負けましたが、今回は説明文が主張に直接答えています。(11/11追記:勾配ブースティングの学習(0.067)とはほぼ同じ)
E7:genus を3段たどる
物の語の語義は E6 のもの、その先の語は Wiktionary の全部入りダンプ(2026-11-10、2,339語)から。頭の名詞は spaCy の最初の名詞句の主辞に、少しの決まりを足して取ります(「one who …」→ person、「a kind of X」→ X など)。各段も NLI で "w" means: <説明文> ⇒ W is a type of g.、着きは NLI か分類の語そのもの。途中の語は最初の4語義を全部たどります。
方法:③1段だけ、⑥一番強い道の段の掛け算(Entailer 型)、⑦網(点=「この語は C の一種」、段に沿って含意の因子、loopy BP、強さ3つを調整用で選ぶ)、⑧E6 の特徴+鎖の値で LR。
| 方法 | 直る(81) | 常識で正しいGを壊す(68) | T に「いいえ」(177) | AURC |
|---|---|---|---|---|
| ③ 1段だけ | 75% | 40% | 24% | 0.070 |
| ⑥ 一番強い道 | 64% | 29% | 6% | 0.087 |
| ⑦ 網(BP) | 83% | 47% | 28% | 0.083 |
| ⑧ 特徴+鎖で LR | 68% | 27% | 23% | 0.048 |
- 網と掛け算は同着。網は段を弱く見る設定(β 0.25 など)を選び、1段だけに近い動きになりました。
- 分類に着いた2段以上の道を50本見ると、30本が途中で語義を取り違えていました。一番多いのは person の珍しい語義を通って body part・organ に着く道。device →「企み」、child →占いのカード、もありました。網は道の強さしか見ず語義を見ないので、これを見分けられません。
- 鎖を信じてよいかは、網より学習で決めるほうが良かった(⑧ 0.048、E6 の⑤ 0.079 に 5/5)。Liang ほか 2017 と同じ向きです(11/11訂正:強い学習と比べると同着。冒頭の訂正を参照)。
E8:途中の語の語義を選ぶ
ダンプを読み直し、{{lb|en|...}} の印(obsolete・archaic・rare・slang など)を語義ごとに残しました。途中の語は8語義まで持ち、鎖の点を「語+語義番号」にしました。語義の選び方は4通り:
- A:選ばない(最初の4語義を全部、E7 と同じ)
- B:印のない最初の語義(Kovács ほか 2023 型)
- C:1つ前の説明文に一番近い語義(all-mpnet-base-v2 の cos、OntoLearn・McIntosh 2009 型)
- D:Gemma に選ばせる(Meconi ほか 2025・ConSeC 型)。分類 C は見せません。
D のプロンプト(番号の logit の softmax で選ぶ):
Dictionary definition of "<w>": <説明文>

In this definition, which meaning of the word "<g>" is used?
1. <語義1>
2. <語義2>
...

Answer with the number only.
打ち消しとして、主張の分類と両立しない8つの大きなまとまり(animal・plant・food・man-made object など)への NLI を、網の罰 γ として入れました。
さらに、E4-2 の主張から700問に出ない語で 新しい300問(G/H/E/T の割合は同じ)を作り、方法とパラメータはすべて700問で固定してから評価しました。新しい300問の正解は Claude が語と分類だけを見て付けました。
| 方法(700問) | 直る(81) | 常識で正しいGを壊す(68) | T に「いいえ」(177) | AURC Claude | AURC Gemini |
|---|---|---|---|---|---|
| ① 自信 | 0% | 4% | 33% | 0.154 | 0.149 |
| ③ 1段だけ | 75% | 40% | 24% | 0.069 | 0.084 |
| ⑥ 一番強い道 A | 64% | 29% | 6% | 0.087 | 0.078 |
| ⑥ 一番強い道 B / C | 75% / 74% | 35% / 35% | 19% / 15% | 0.053 / 0.055 | 0.062 / 0.063 |
| ⑥ 一番強い道 D | 75% | 34% | 8% | 0.047 | 0.056 |
| ⑦ 網+打ち消し D | 83% | 49% | 29% | 0.091 | 0.075 |
| ⑧ 特徴+鎖で LR A | 67% | 28% | 23% | 0.050 | 0.057 |
| ⑧ 特徴+鎖で LR D | 72% | 27% | 14% | 0.037 | 0.045 |
- 取り違え(分類に着いた2段以上の道。どの方法の道かを伏せて Claude が判定):A 32/50(64%)、B 2/18、C 5/39、D 2/48(4%)。(11/11 訂正:一覧なしでは A 72% → D 10%)
- 結果を見たあとの直接の確かめ:語義選びの場面を無作為に40個取り、Claude が候補から正しい語義を先に決めて照合。判定できた37個で、Gemma 35、C 24、B 24、いつも最初の語義 24。最初の語義の 65%(24/37)は Meconi ほか 2025 の数字と同水準です。
- 主な比べ1(⑧A 対 ⑧D):0.050 対 0.037。5回とも D が良いが差は 0.011〜0.013 で(一覧なしでは ⑧D 0.056)、決めておいた 0.02 に届かず同着。
- 主な比べ2(⑥D 対 網+打ち消し):網が 5/5 で負け。調整用で選んだ γ は25回中23回で0でした。
新しい300問(すべて700問で固定した設定):
| 方法 | AURC |
|---|---|
| ① 自信 | 0.118 |
| ③ 1段だけ | 0.055 |
| ⑤ E6 の特徴+LR | 0.055 |
| ⑥ 一番強い道 D | 0.043 |
| ⑧ 特徴+鎖で LR D | 0.039 |
- ①との差 0.079(語で取り直した 95% 区間 0.043〜0.121)。
- ③との差 0.017(−0.007〜0.040)で、300問では言い切れません。新しい300問は700問より易しかったようです(③の直りが 87%)。
読み方
- Gemma は「X は C の一種か」では自信を持って誤るのに、「この文の中でこの語はどの語義か」はよく当てました。判断の全体を任せず、得意な小さな役目(語義選び)だけをさせ、判定は外の NLI と鎖で行う分け方が、今回いちばん良く働きました。
- 多段の説明文の鎖での語義の取り違えは 1990年代から知られた難所で(Rigau ほか 1998 は1段約8割の正しさを引用)、3段なら 0.8³ ≒ 5割と、E7 の 6割の取り違えとほぼ合います。
- 網(BP)は、E4 から通して、ルールや鎖の強さだけを見る限り単純な方法に勝てていません。今回効いたのは語義の選び方で、網の計算ではありませんでした。
言えないこと
- LLM は Gemma-2 2B だけ、主張は「X is a type of C」の形だけ、英語だけ。
- 正解は2つの LLM の常識判定で、人ではありません。新しい300問の正解、取り違えの判定、語義の確かめは Claude だけです。
- 新しい300問で1段だけの NLI に勝ったとは言えません。
- D は A より、常識で正しいGを壊す割合が少し高い(29%→34%)。
- 取り違えの割合は、方法ごとに数えた道の数が違います(18〜50本)。
- 語義の確かめ(40個)は結果を見たあとに足したものです。
再現
cd analysis/e6
python e6_analyze.py ../../data/E6_answers_gemma-2-2b-it.json out6.json                                   # E6(数秒)
python e7_analyze.py ../../data/E7_chains_nli.json ../../data/E6_answers_gemma-2-2b-it.json out7.json      # E7(約10分)
cd ../e8
python e8_analyze.py ../../data/E8_chains_nli.json out8.json                                                # E8(約5分)
Gemma・NLI の出力は Colab(L4)で取りました。E8 は約1時間半です。
参考文献
- Moskvoretskii ほか "TaxoLLaMA: WordNet-based Model for Solving Multiple Lexical Semantic Tasks", ACL 2024. https://arxiv.org/abs/2403.09207
- Wu・Wu・Zou "ClashEval: Quantifying the tug-of-war between an LLM's internal prior and external evidence", NeurIPS 2024. https://arxiv.org/abs/2404.10198
- Tafjord・Dalvi・Clark "Entailer: Answering Questions with Faithful and Truthful Chains of Reasoning", EMNLP 2022. https://arxiv.org/abs/2210.12217
- Velardi・Faralli・Navigli "OntoLearn Reloaded: A Graph-Based Algorithm for Taxonomy Induction", Computational Linguistics 2013. https://aclanthology.org/J13-3007/
- Bansal ほか "Structured Learning for Taxonomy Induction with Belief Propagation", ACL 2014. https://aclanthology.org/P14-1098/
- Liang ほか "On the Transitivity of Hypernym-Hyponym Relations in Data-Driven Lexical Taxonomies", AAAI 2017. https://ojs.aaai.org/index.php/AAAI/article/view/10675
- Rigau・Rodríguez・Agirre "Building Accurate Semantic Taxonomies from Monolingual MRDs", COLING-ACL 1998. https://arxiv.org/abs/cmp-lg/9806015
- Kovács・Gemes・Kornai・Recski "Explainable lexical entailment with semantic graphs", Natural Language Engineering 2023. https://doi.org/10.1017/S1351324922000092
- McIntosh・Curran "Reducing Semantic Drift with Bagging and Distributional Similarity", ACL 2009. https://aclanthology.org/P09-1045/
- Barba・Procopio・Navigli "ConSeC: Word Sense Disambiguation as Continuous Sense Comprehension", EMNLP 2021. https://aclanthology.org/2021.emnlp-main.112
- Meconi・Stirpe・Martelli・Lavalle・Navigli "Do Large Language Models Understand Word Senses?", 2025. https://arxiv.org/abs/2509.13905
- Laurer ほか DeBERTa-v3-large-mnli-fever-anli-ling-wanli. https://huggingface.co/MoritzLaurer/DeBERTa-v3-large-mnli-fever-anli-ling-wanli
- Reimers・Gurevych "Sentence-BERT", EMNLP 2019(all-mpnet-base-v2)
- Gemma Team "Gemma 2: Improving Open Language Models at a Practical Size", 2024. https://arxiv.org/abs/2408.00118
一般向けの説明は note に書きました:https://note.com/mst_design2020/n/nde0fb5abc0aa

Discussion