小さいLLMの答えを辞書で確かめる方法を「TADORI」と命名した(E15で辞書の鎖を区切る)




この連載では、小さな言葉のAI(Gemma-2 2B)を「口」として使い、その答えを AI の外に置いた部品で確かめられるかを、1つずつ試してきました。将来はこの「確かめる計算」を p-bit のような物理の部品に任せる、AKANE アーキテクチャという構想の部品の研究です。
今回はシリーズの区切りです。E15(辞書の鎖の最後の段を Gemma に判定させる)の結果と、E2〜E15 で最後まで残った確かめ方 TADORI(たどり) のまとめを書きます。
TADORI は Tracing Along Definitions, Opting for the Right Interpretation の頭文字です。「辞書の説明文(定義)をたどり、途中の語の正しい意味を選ぶ」という意味で、日本語の「たどり」とも読めるように名付けました。
これまでの流れ
- E2〜E2-12:AI が作ったルールを確率伝搬(BP)で確かめた。先行研究 BTProp と比べ、元のつながりでは BTProp が上か同着。
https://zenn.dev/mst_design2020/articles/8b904689df2ddc
https://zenn.dev/mst_design2020/articles/bc3e1c916a4baa - E3〜E5:資料の網・輪の多い大きな網。網は強い学習に勝てず、BP と p-bit 方式の正しさは分かれなかった。
https://zenn.dev/mst_design2020/articles/c1537032d8943c
https://zenn.dev/mst_design2020/articles/545424bd00f46f - E6〜E8:辞書の説明文で確かめる。説明文をたどる「辞書の鎖」で、途中の語の意味を Gemma に選ばせると取り違えが72%→10%に減った。
https://zenn.dev/mst_design2020/articles/5d3feab2c2fff8 - E9・E10:網で広げても強い学習に勝てない。部分と全体では答えを書いた文が効いた。
https://zenn.dev/mst_design2020/articles/804eba1639b569
https://zenn.dev/mst_design2020/articles/50e211cbd882af - E11〜E14:意味選びは3万4千問でも保てた(80.9%)。手がかりを全部1つの学習にまとめると良い。鎖を深くする・外の文で行き止まりを埋める・正解なしの網は効かなかった。
https://zenn.dev/mst_design2020/articles/8ac3114ae8cf58
E14 のあとに残った外れの多くは、鎖の最後の段、つまり「この途中の語は C の一種か」の判定で落ちていました。E15 ではそこを直せるかを試し、直せなければ辞書の鎖の系を区切る、と先に決めていました。
結論を先に書きます。
- 最後の段を Gemma に判定させると悪くなりました(E15)。 600問で 0.060 → 0.109。道の説明文を全部見せても、関係のない道を見せた時(0.102)と差がありません。親の語を Gemma に選ばせても同着でした。
- 辞書の鎖の系はここで区切ります。 小さいAIに残った役目は「途中の語の意味を選ぶ」ことだけでした。
- 残った形を TADORI と呼びます。 辞書の説明文をたどり、途中の語の意味だけ小さいAIに選ばせ、判定は外の NLI に任せる確かめ方です。
コードと結果は GitHub にあります。
https://github.com/mst-design2020/akane-e2-experiments (README の「TADORI(研究者向けの要約)」、analysis/e15/、plans/E15_*.md、data/E15/、results/E15/、Colab は colab/E15_last_step.ipynb)。Zenodo の版は v1.3.0 です(全部の版の DOI 10.5281/zenodo.24045799)。
問いと物差し
- AI は Gemma-2 2B-it、NLI は DeBERTa-v3-large-mnli-fever-anli-ling-wanli、辞書は英語版 Wiktionary のダンプ(2026-11-10)です。手書きの語の一覧はありません。
- 問いは「X is a type of C.」(X は物の語、C は46分類のどれか)。
- AURC は、確かな順に答えていった時の誤り率の平均で、小さいほど良い物差しです。上から
k r_k \mathrm{AURC}=\frac1N\sum_{k=1}^N r_k - 「差あり」は、相手の AURC の20%以上の差があり、物の語で取り直した95%の幅が0をまたがない時。結果を見る前に計画に固定しました。
- 常識の採点は Claude(主な物は Gemini でも)で、人の判定ではありません。
E15:鎖の最後の段を Gemma に替える
なぜ最後の段か
E8n の1,000問で、正しい主張に鎖が「いいえ」と言った82問を数えると、29問は正しい途中の語(kitten → cat、wife → human など)まで強く着いているのに、最後の段で落ちていました。最後の段は「途中の語の説明文 ⇒ W is a type of C.」の NLI 1回で、説明文に分類の語が書いてないと値が低くなります(human ⇒ mammal 0.015、cat ⇒ mammal 0.012)。NLI が上位語の置き換えに弱いことは Glockner ほか(2018)も報告しています。
一方、分類の判定で根からの道(先祖の並び)を見せると良くなるという報告があります(LORex、Mishra ほか 2025。8B 級のモデル)。そこで「道の説明文を全部見せれば、2B の Gemma でも最後の段を判定できるか」を試しました。
変えた所
- 最後の段:たどった道の説明文を全部見せて Gemma に聞く。
Dictionary definitions:
- "kitten": …
- "cat": …
Based on these definitions, is a "kitten" a kind of "mammal"? Answer Yes or No only.
- 親の語:説明文の親の候補が2つ以上ある時、「この説明文のどの語が、w が何の一種かを言っているか」を Gemma に番号で選ばせる。
対照として、道の最後の説明文だけ見せた Gemma(last)、関係のない別の問題の同じ長さの道を見せた Gemma(ctrl)、説明文なしの Gemma(none)も出しました。ctrl は「Gemma が道を読まずに自分の知識で答えているだけではないか」を見るためです。
式。 鎖の点を
結果
確かめは E10-3 の「一種か」600問(はい210)、E8 の1,000問は前に何度も使ったので見るだけにしました。
| 作り方 | 「一種か」600問 | E8 の1,000問(見るだけ) |
|---|---|---|
| 今のやり方(親も最後の段も NLI) | 0.060 | 0.061 |
| 最後の段:道を全部見せた Gemma | 0.109 | 0.088 |
| 最後の段:最後の説明文だけ見せた Gemma | 0.128 | 0.096 |
| 最後の段:関係のない道を見せた Gemma | 0.102 | 0.131 |
| 説明文なしの Gemma | 0.168 | 0.117 |
| 親の語を Gemma が選ぶ(最後の段は NLI) | 0.062 | 0.060 |
(AURC、小さいほど良い)
- 最後の段を Gemma に替えると悪い(差 −0.049、95%の幅 −0.071〜−0.029)。間違った「はい」が増えます。
- 道を全部見せると、最後の説明文だけより少し良く、説明文なしよりずっと良い。でも600問では関係のない道と同着で、「道を読んでいる」とは言えません。
- 親の語は、NLI と Gemma で 14,851 のうち 12,653 が同じで、違っても答えはほぼ変わりません。
- 先に決めた旗は4つとも立ちませんでした。
最後の一歩の判定は、2B の Gemma より判定専用の NLI の方が良い、という結果です。E8 からの見立て(小さいAIには狭い役目だけ)と同じ向きです。
TADORI:最後まで残った確かめ方
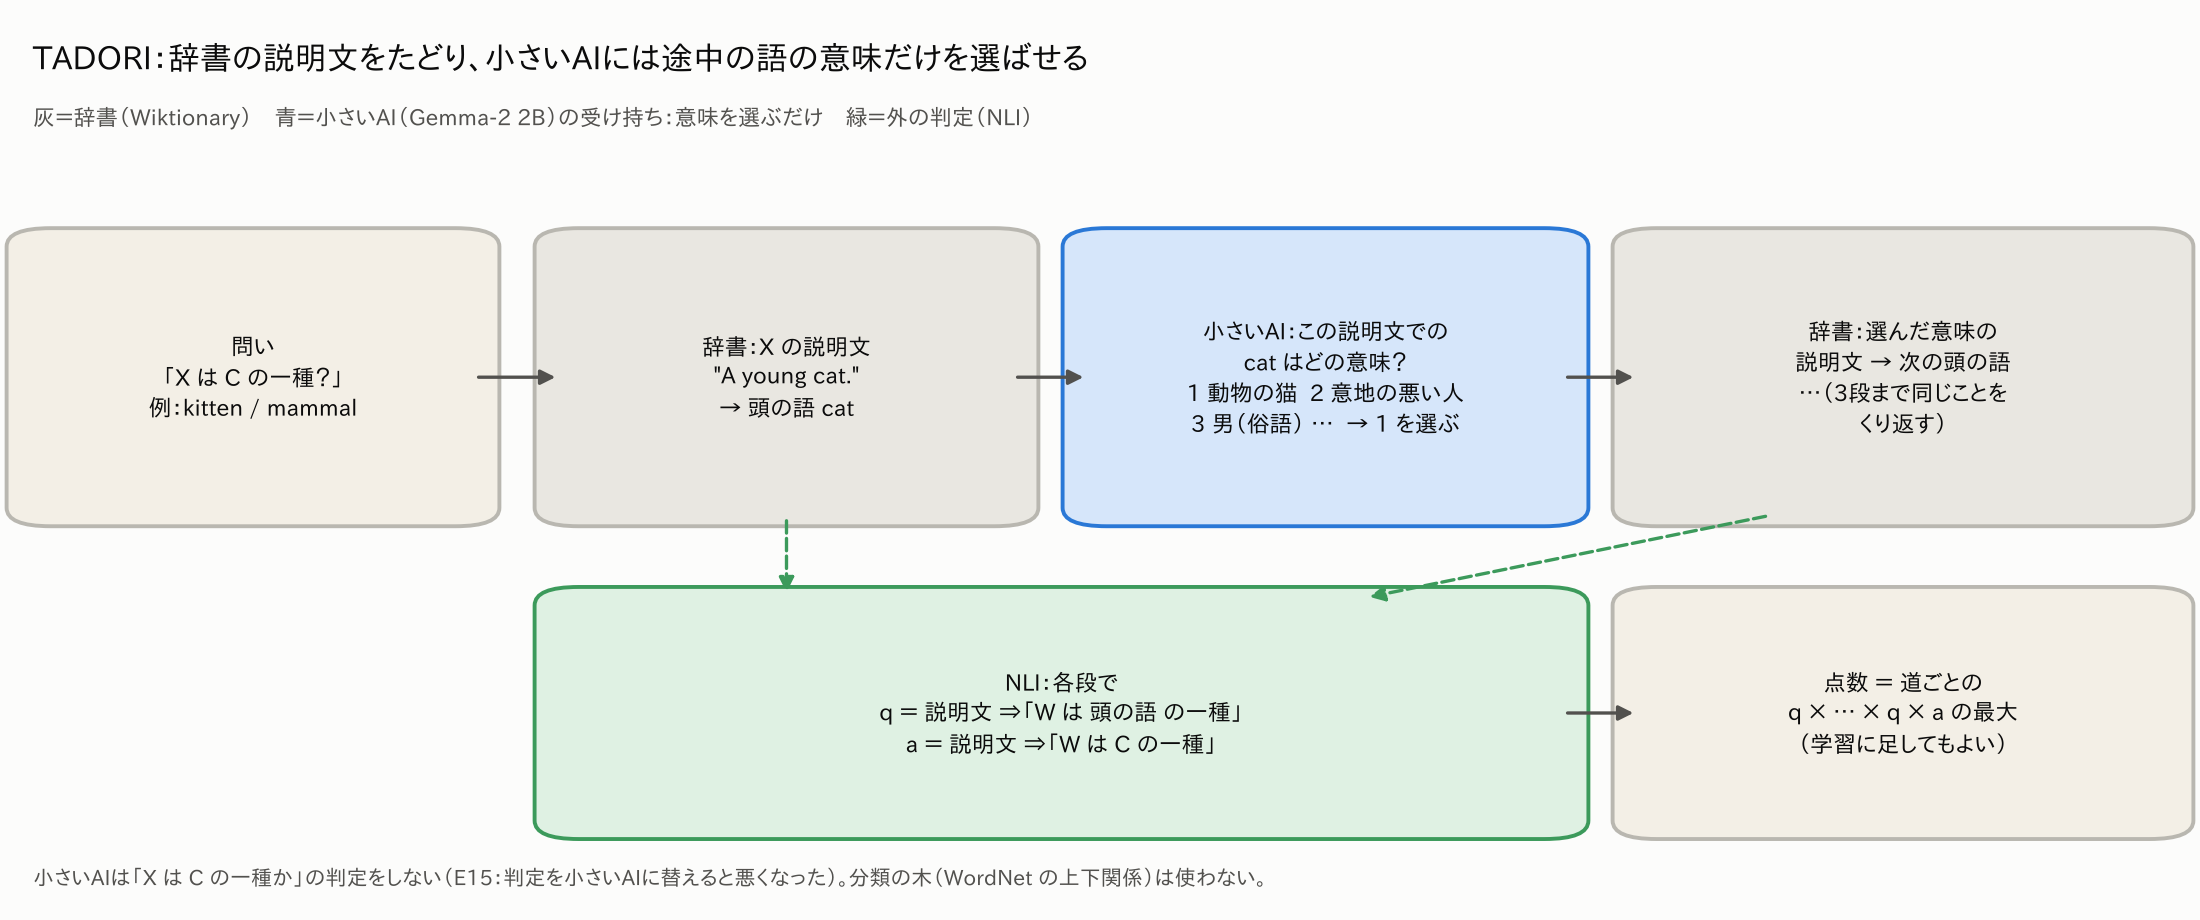
TADORI(たどり) = Tracing Along Definitions, Opting for the Right Interpretation(説明文をたどり、正しい意味を選ぶ)の略です。日本語の「たどる」とも読めるように名付けました。
小さいAIの「X は C の一種か」という答えを、辞書の説明文の鎖で確かめます。小さいAIには、鎖の途中で「この説明文の中の語は、どの意味で使われているか」を選ぶ役だけをさせます。各段の確からしさと「C に着いたか」は外の NLI が決めます。小さいAI自身は「X は C の一種か」を判定しません。
手順
いま説明文を読んでいる語を
-
w d - 説明文の頭の名詞
g - 小さいAIに
d g d g
Dictionary definition of "w": d

In this definition, which meaning of the word "g" is used?
1. …
2. …

Answer with the number only.
答えの最初の位置での「1」「2」…のロジットを softmax し、一番高い番号を選びます(文は生成させません)。
4. 外の NLI で、段の確かさ "w" means: d。例:前提 "kitten" means: A young cat.、仮説 Kitten is a type of cat.。
5. 選んだ意味の説明文から 2〜4 をくり返す(3段まで)。
6. 点数は、道ごとの
確かめられたこと
| 主張 | データ | TADORI | 比べ相手 | 判定 |
|---|---|---|---|---|
| 小さいAIは意味選びが得意 | 鎖の途中の意味の取り違え(2段以上の道、方法を伏せて判定) | 4/41(10%) | 意味を選ばない 36/50(72%) | 取り違えが減った |
| 意味選びはたくさんの問題でも保てる | WordNet の説明文の頭の語 34,402問、人が付けた意味 | 80.9% | 文の近さ 67.9%、最初の意味 60.5% | 差あり(+13.0 ポイント、95%の幅 10.3〜16.3) |
| 覚えていただけではない | 語の名前を隠す/言い換える 5,000問 | 80.8%/69.3% | 最初の意味 59.3% | 差あり |
| 小さいAIの答えを確かめられる | 新しい300問、AURC | 0.046(鎖+学習) | 小さいAIの自信 0.118 | 差あり(幅 0.038〜0.112) |
| 他の手がかりと一緒に学習に渡すと良い | 700問、AURC、木の学習 | 0.038 | 小さいAIの答えだけの学習 0.053 | 差あり(5回中5回) |
言えないこと
- 辞書の1段だけの確かめ(E6)より良いとは言えません(700問で 0.063 対 0.069、新しい300問でも幅が0をまたぐ)。強みは「意味の取り違えが減る」ことと「学習の材料として効く」ことです。
- 80.9% は WordNet での意味選びの正しさで、TADORI の答えの正しさではありません(TADORI が使う辞書は Wiktionary)。
- 小さいAIは Gemma-2 2B の1つ、英語、問いは主に「一種か」だけです。
- E15 で分かったのは「2B の小さいAIに最後の判定をさせると悪い」ことで、もっと大きいAIなら違う可能性があります。
試して外した物
| 試した方向 | 結果 | 判断 |
|---|---|---|
| 網(BP)でまとめる、両立しない分類の打ち消し | 0.091 対 一番強い道 0.047(悪い) | 網は使わない |
| p-bit 方式 | BP と正しさが一度も分かれない | 正しさでは出番なし(速さ・電力は未測定) |
| 鎖を3段→6段 | 0.063 対 0.063(同着) | 止まる理由は辞書の行き止まり |
| 行き止まりを外の文で埋める | GenericsKB 0.063→0.140(悪い)、Wikipedia 同着 | 資料を足す方向は追わない |
| 最後の段を小さいAIに判定させる | 0.060→0.109(悪い) | 判定は NLI のまま |
| 親の語を小さいAIに選ばせる | 0.062 対 0.060(同着) | 今の取り方のまま |
近い研究との違い
部品はどれも前からあります。辞書の説明文の頭の語をたどって分類を作る研究(Chodorow ほか 1985、Véronis・Ide 1991、Rigau ほか 1998、OntoLearn Reloaded 2013)、AI に説明文の候補から意味を選ばせる研究(Meconi ほか 2025)、AI の答えを外の判定で確かめる研究(ConCoRD 2022、BTProp 2025)です。TADORI はそれらを組み合わせ、小さいAIを「判定する役」でなく「途中の意味を選ぶ役」だけに使います。この組み合わせ方は、調べた範囲では見つかりませんでした(見落としの可能性はあります)。BTProp は AI 自身の答えどうしを網でつなぎますが、TADORI は外の辞書をたどり、網を使いません。
このあと
辞書の鎖の系はここで区切ります。p-bit は正しさでは出番がなかったので、次は「Gemma と同じ答えを、どれだけ安く(速く・少ない電力で)出せるか」という別の物差しで使い道を考えます。
再現
cd analysis/nolist
E8_DIR=../e8 python e8n_analyze.py ../../data/E8n_chains_nli.json out.json   # TADORI(方法D)、CPU で約5分
cd ../e15
E8_DIR=../e8 python e15_analyze.py ../../data/E15/E15_results.json.gz out.json   # E15、数秒
E15 は、公開したファイルから分析をやり直すと保存した出力(results/E15/E15_analysis.json)とぴったり同じになります。
参考文献
- Mishra ほか(LORex), 2025. https://arxiv.org/abs/2505.13282
- Glockner・Shwartz・Goldberg "Breaking NLI Systems with Sentences that Require Simple Lexical Inferences", ACL 2018. https://arxiv.org/abs/1805.02266
- Chodorow・Byrd・Heidorn "Extracting Semantic Hierarchies from a Large On-Line Dictionary", ACL 1985.
- Véronis・Ide "An Assessment of Semantic Information Automatically Extracted from Machine Readable Dictionaries", EACL 1991.
- Rigau・Rodríguez・Agirre "Building Accurate Semantic Taxonomies from Monolingual MRDs", COLING-ACL 1998. https://arxiv.org/abs/cmp-lg/9806015
- Velardi・Faralli・Navigli "OntoLearn Reloaded: A Graph-Based Algorithm for Taxonomy Induction", Computational Linguistics 2013.
- Meconi ほか "Do Large Language Models Understand Word Senses?", EMNLP 2025. https://arxiv.org/abs/2509.13905
- Mitchell ほか "Enhancing Self-Consistency and Performance of Pre-Trained Language Models through Natural Language Inference"(ConCoRD), EMNLP 2022. https://arxiv.org/abs/2211.11875
- Hou ほか "A Probabilistic Framework for LLM Hallucination Detection via Belief Tree Propagation"(BTProp), NAACL 2025. https://arxiv.org/abs/2406.06950
- Geifman・Uziel・El-Yaniv "Bias-Reduced Uncertainty Estimation for Deep Neural Classifiers", ICLR 2019. https://arxiv.org/abs/1805.08206
- Laurer ほか DeBERTa-v3-large-mnli-fever-anli-ling-wanli. https://huggingface.co/MoritzLaurer/DeBERTa-v3-large-mnli-fever-anli-ling-wanli
- Gemma Team "Gemma 2: Improving Open Language Models at a Practical Size", 2024. https://arxiv.org/abs/2408.00118

Discussion